开源大模型越来越强,可一放进你公司的业务里,它就像个刚入职的高材生:什么都懂一点,偏偏不懂“我们这儿的规矩”。微调,就是给它上的那堂岗前培训。
这篇文章沿着一条主线,把微调从“为什么需要它”一路讲到“亲手训一个、部署成接口”。读完你应该能回答三个问题:什么时候该微调?微调到底改了模型的什么?LoRA、DPO、GRPO 这些名词,各自解决的是哪一个问题?
写在前面
全文用一个例子贯穿始终:Text-to-SQL,让模型把业务人员的一句话翻译成能直接执行的 SQL。选它是因为对错能自动判断(SQL 跑一下,结果对就是对),而且基座模型会犯很具体的错:它 SQL 写得很溜,却不知道你们公司“销售额”怎么算、金额存的是分还是元、取消的订单算不算。这些“业务口径”,正是微调要教的东西。
阅读本文只需要会写 Python、会用命令行。损失函数、梯度、矩阵的秩这些概念,用到的时候都会从头讲。
全文分四个部分:
- 第一部分:大模型的训练流程与微调的定位。 模型是怎么一步步练成的,微调在其中的哪个位置,以及什么情况下真的需要微调。
- 第二部分:监督微调(SFT)与参数高效微调(PEFT)。 SFT 在数学上到底在做什么,为什么全参数微调那么贵,LoRA 的原理和超参数怎么选。
- 第三部分:偏好对齐与强化学习。 从 RLHF 讲到 PPO、DPO、GRPO,以及“SFT 记忆、RL 泛化”这句话该怎么理解。
- 第四部分:Text-to-SQL 模型微调实战。 用 LLaMA-Factory 和手写 PEFT 代码两条路线,把 Qwen2.5-Coder-1.5B 微调成一个懂业务口径的 Text-to-SQL 模型,评测、合并,再用 FastAPI 部署成接口。
1 大模型的训练流程与微调的定位
1.1 预训练目标:下一个词预测与交叉熵损失
要理解微调在改什么,得先知道模型最初是怎么被训练出来的。
今天所有的大语言模型,不管是 GPT、Claude,还是 Qwen、DeepSeek,底层都建立在一个简单到出人意料的任务上:预测下一个词(Next Token Prediction)。
给模型看一段文字的前半截,让它猜下一个 token 是什么(token 可以先理解成“词”或者“字”,模型处理文字的最小单位)。比如输入“中国的首都是”,模型要给出词表里每一个词出现在下一个位置的概率。理想情况下,“北京”的概率应该很高。
模型猜完,我们拿它的预测和真实答案比一比,算出一个叫损失(loss)的数,表示“猜得有多离谱”。最常用的损失叫交叉熵,公式只有一行:
$$ \mathcal{L} = -\log p_\theta(\text{正确答案}) $$$p_\theta$ 表示参数为 $\theta$ 的模型给出的概率,$\theta$ 就是模型里那几十亿个数字。这个公式的意思很直白:正确答案的概率越高,损失越小。
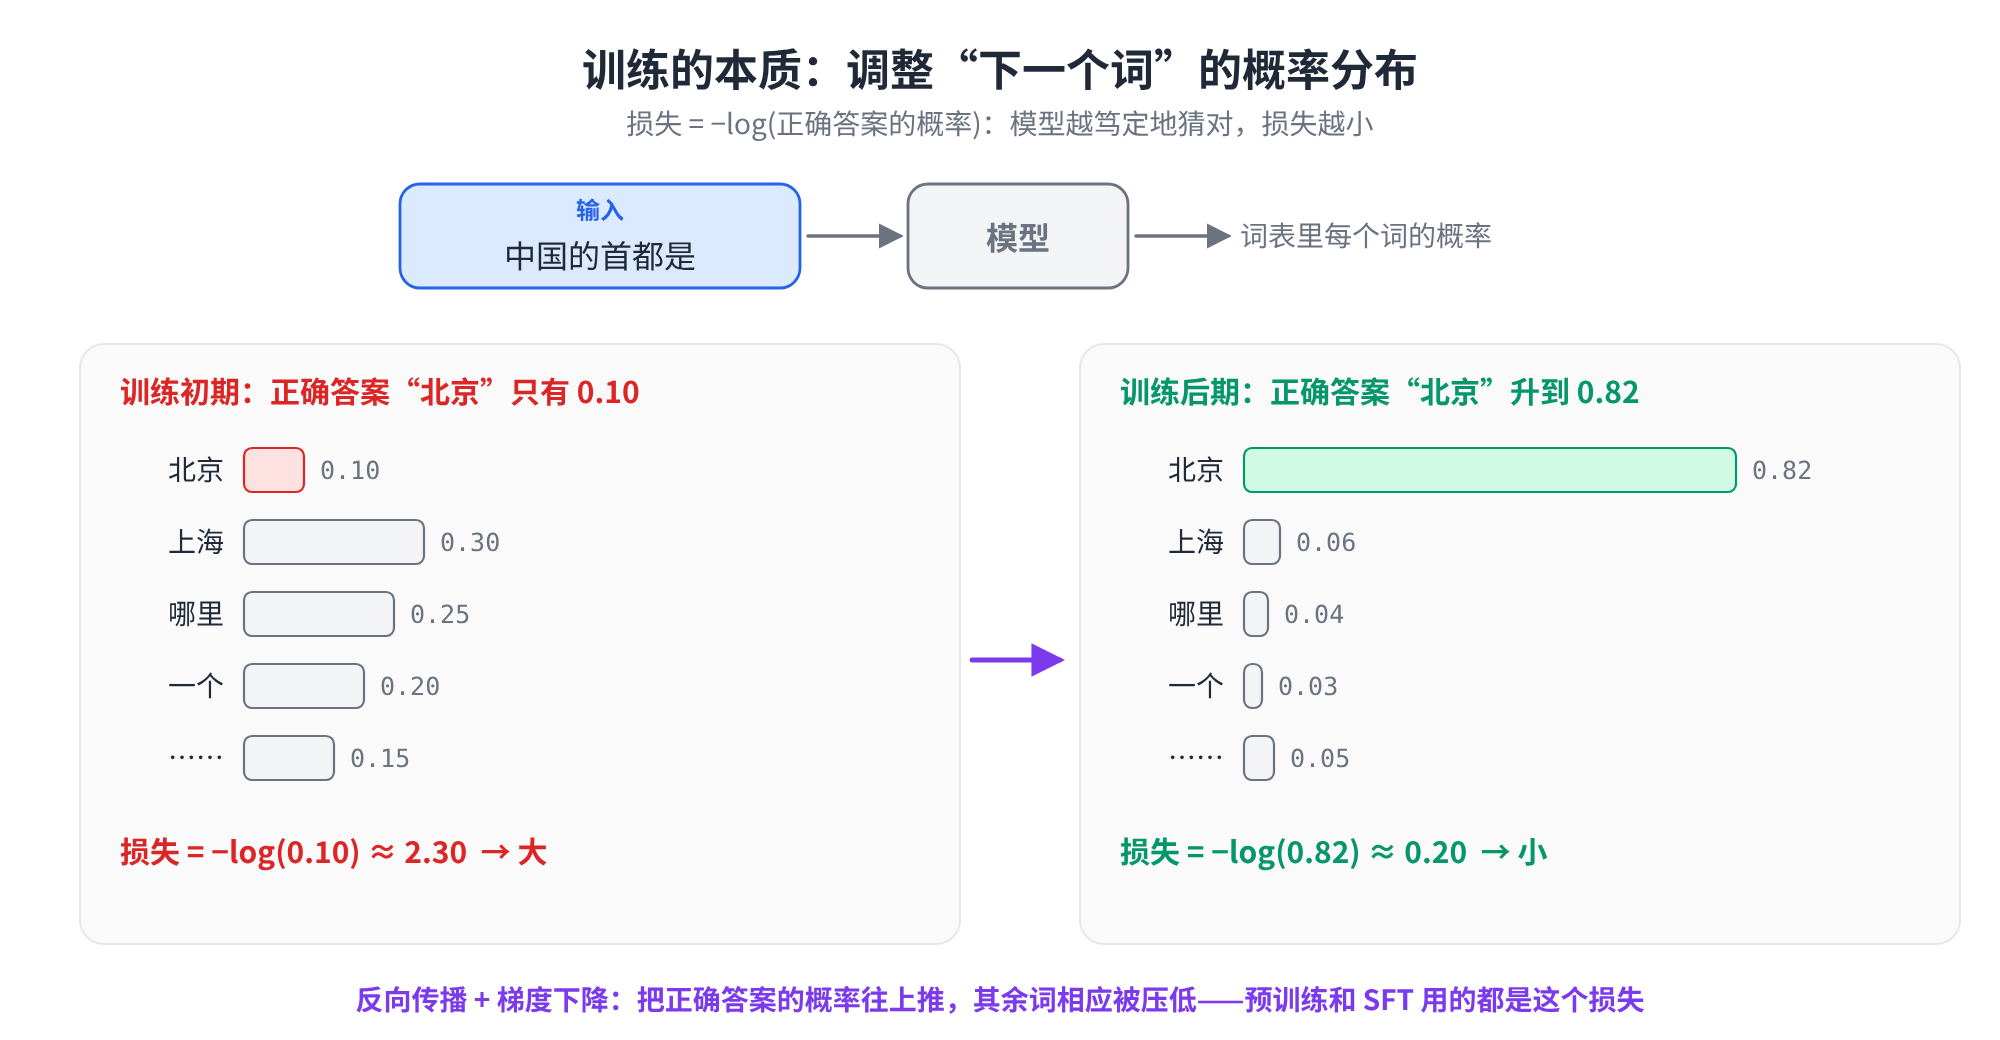
举个数字例子。训练刚开始时,模型对“北京”只给了 0.10 的概率,损失是 $-\log 0.10 \approx 2.30$;训练一段时间后,“北京”的概率涨到 0.82,损失降到 $-\log 0.82 \approx 0.20$。
那么怎么让概率涨上去?靠的是梯度下降。损失是参数的函数,对每个参数求导,就知道“这个参数往哪个方向动一点,损失会变小”,这个导数叫梯度。然后让每个参数都沿着让损失变小的方向挪一小步:
$$ \theta \leftarrow \theta - \eta \cdot \nabla_\theta \mathcal{L} $$$\nabla_\theta \mathcal{L}$ 就是梯度,$\eta$ 是学习率,决定每一步迈多大。求梯度的过程叫反向传播,由 PyTorch 这类框架自动完成,我们不用手算。
在几万亿个 token 上反复做这件事,模型被逼着学会了语法、事实、逻辑甚至一些推理能力,因为想在各种语境里都猜对下一个词,没有捷径可走,只能真正“消化”文本里的规律。
这里有一个贯穿全文的关键认知,请先记住:模型的输出本质上是一个概率分布,所谓“训练”,归根结底就是调整这个分布。 后面要讲的预训练、SFT、RLHF,区别只在于“想让哪些输出的概率变高”,以及“用什么信号来告诉模型哪些输出是好的”。
1.2 大模型训练的四个阶段:预训练、Mid-training、SFT、强化学习
只做完“预测下一个词”的模型,叫基座模型(Base Model)。它很博学,却不太好用:你问它一个问题,它可能接着写出三个新问题,因为在互联网文本里,一个问题后面经常跟着的就是另一个问题。它还没学会“被提问时应该回答”这个规矩。
从基座模型到我们日常用的聊天助手,中间还要经过几个阶段。现代大模型的能力开发,通常可以拆成四个环节:
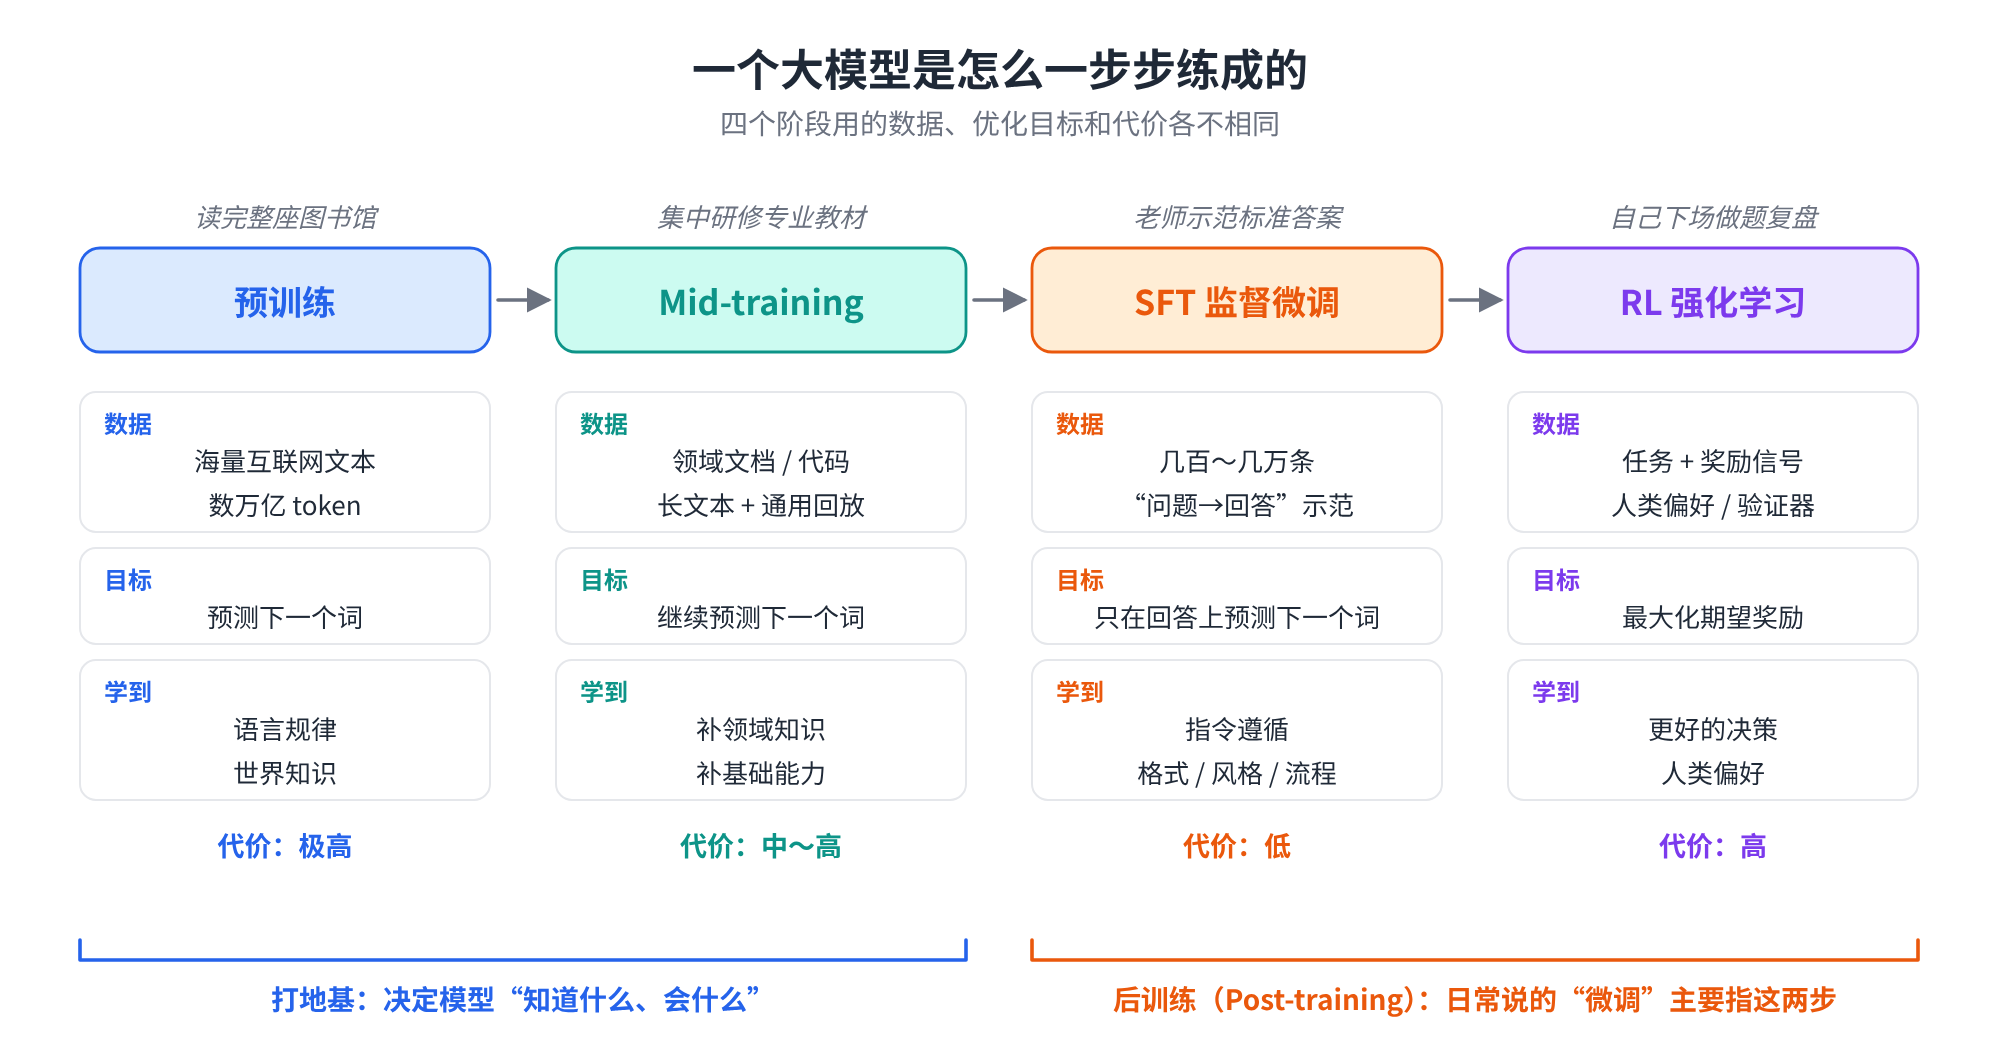
第一步,预训练(Pre-training):在海量互联网文本上预测下一个词。好比一个人读完了整座图书馆,博学,但还不会好好答题。这一步是能力的地基,也是最贵的一步,动辄几百万到几千万美元,普通团队不会碰。
第二步,Mid-training(中期训练,也叫继续预训练):从一个已有的基座模型出发,在特定领域的文本上继续做预测下一个词。比如一个主要用英文训练的模型几乎看不懂韩语,就可以拿大量韩语语料再训一轮;一家医疗公司想让模型真正“懂医学”,也可以拿大量医学文献来训。好比让一个通才集中研修几本专业教材。
第三步,SFT(Supervised Fine-Tuning,监督微调):用几百到几万条人工准备好的“问题 → 标准回答”示范,教模型“该用什么格式、什么风格、什么流程来回答”。好比老师给学生示范标准答案怎么写。这一步把一个“有知识”的模型,变成一个“听得懂指令、输出规整”的助手。它便宜、快、稳,几乎所有上线的模型都会经过这一步。
第四步,RL(Reinforcement Learning,强化学习):不再给标准答案让模型照抄,而是让模型自己去答,答得好就奖励,答得差就惩罚,把好回答的概率调高、差回答的概率调低。好比让学生自己下场做题、按得分复盘。用人类的偏好当奖励,就是大家常听到的 RLHF(基于人类反馈的强化学习)。
前两步决定模型“知道什么、会什么”,后两步决定模型“怎么用它知道的东西”。后两步合起来叫后训练(Post-training)。
1.3 微调的定义与分类
“微调”(Fine-tuning)是一个用得很宽泛的词,不同人说的可能不是一回事。
广义上,凡是在预训练好的模型上继续训练、改动它的参数,都可以叫微调。Mid-training、SFT、RLHF 都算。
狭义上,大多数人说“我要微调一个模型”,指的是 SFT,而且通常是用 LoRA 这类省资源的方法做的 SFT。本文第四部分要做的,就是这个意思。
你可能还听过“无监督微调”“自监督微调”的说法。其实上面说的 Mid-training 就是一种自监督微调:它不需要人工标注答案,文本本身就是答案(下一个词就是标签)。为了避免混淆,本文后面统一这样用词:
| 本文的说法 | 改参数吗 | 用什么数据 | 典型用途 |
|---|---|---|---|
| Mid-training / 继续预训练 | 改 | 大量领域原始文本,无需标注 | 补领域知识、补语言能力 |
| SFT / 监督微调 | 改 | 几百到几万条“输入 → 输出”示范 | 教格式、风格、流程、口径 |
| 偏好对齐 / 强化学习 | 改 | 好坏回答对,或一个能打分的奖励 | 让回答“更好”,而不只是“像示范” |
| 参数高效微调(PEFT,如 LoRA) | 只改一小部分 | 同上 | 一种省资源的实现方式,可以和上面任意一种结合 |
最后一行要特别注意:LoRA 不是和 SFT、RLHF 并列的另一种“微调类型”,而是一种实现手段。 你可以用 LoRA 做 SFT,也可以用 LoRA 做 DPO 或 GRPO。常说的“全参数微调”和“部分参数微调”,区分的就是这个维度。
1.4 提示工程、RAG 与微调的选型
微调要准备数据、要租 GPU、要反复调参,出了问题还不好排查。所以在动手之前,最值得花时间的一件事,是判断你的问题到底需不需要改模型参数。
想让模型“更懂你的业务”,一共有三条路:
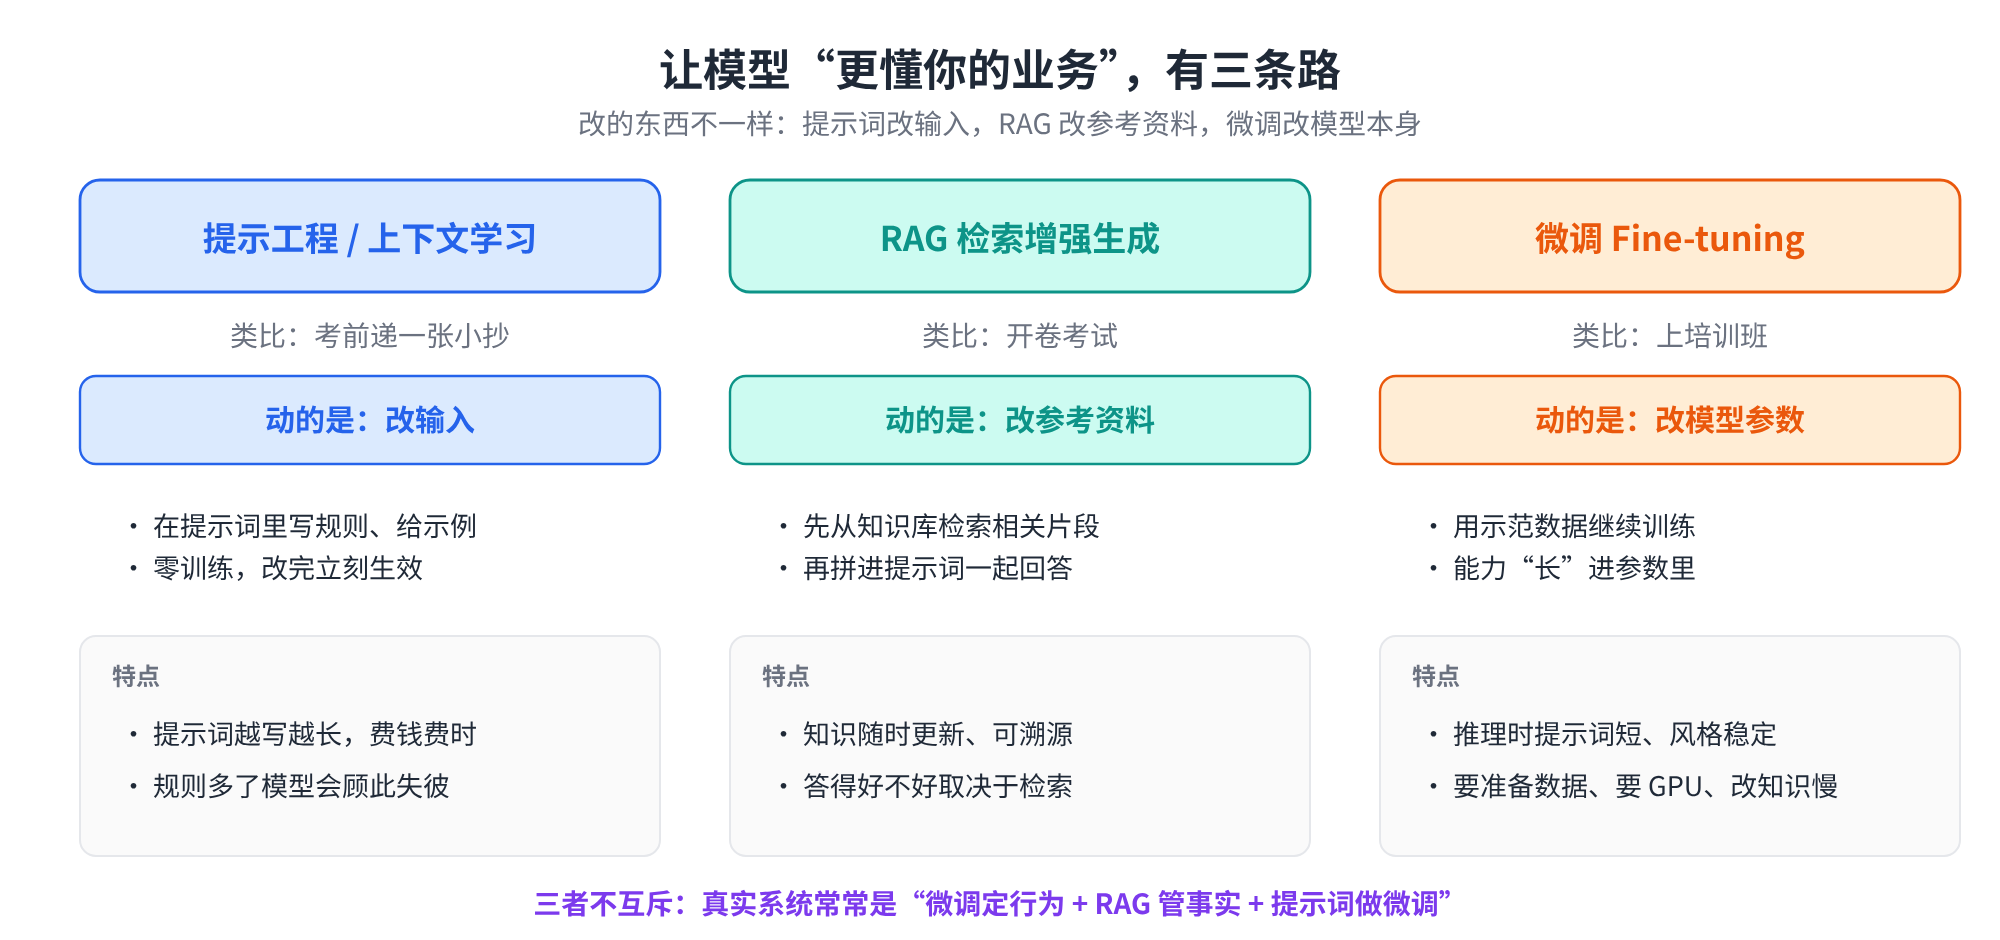
提示工程(包括在提示词里放几个示例的“上下文学习”)改的是模型的输入。好比考前递给学生一张小抄。它零成本、改完立刻生效,永远应该第一个尝试。缺点是规则一多,提示词越写越长,每次调用都更贵更慢,而且模型面对一大堆规则时容易顾此失彼。
RAG(Retrieval-Augmented Generation,检索增强生成)改的是模型能看到的参考资料。用户提问时,系统先去知识库里检索相关的文档片段,拼进提示词,再让模型回答。好比开卷考试。它最适合处理会变化、需要溯源的事实:今天的促销活动、上周更新的产品手册、某条规定出自哪份文件。知识库一更新,模型立刻就“知道”了,不用重新训练。
微调改的是模型本身的参数。好比让学生去上一期培训班,把东西真正学进脑子里。学会之后,推理时不需要冗长的提示词,行为也更稳定。但它需要数据和算力,而且知识一旦写进参数,想修改就得重新训练。
这三条路不是互斥的。成熟的系统往往同时用:微调负责把行为和格式固定下来,RAG 负责提供最新的事实,提示词再做一些临场的调整。
1.4.1 SFT 适合学习格式与规则,不适合注入事实知识
这里有一个很多人会踩的坑,值得单独拿出来说。
常见的一种做法,是想通过 SFT 让模型记住公司的内部知识,比如准备几十条“我们公司的退货政策是什么”这样的问答。这在技术上能做到,几十条问答训几轮,模型确实能背下来。但它学到的往往是这几种问法对应的答案,而不是真正理解了这条知识。换一种问法,或者把这条知识和别的知识组合起来问,它就可能答不上来,甚至开始一本正经地胡编。
原因藏在 SFT 的训练方式里(第二部分会细讲):SFT 的目标是让模型尽量复现示范答案里的每一个字。几十条问答,只是反复强化了少数几条“问题 → 答案”的映射路径,远不足以让一条知识在模型内部和其他知识建立起广泛的联系。
所以业界有一个经验性的分工:
- SFT 擅长的是“协议性知识”:该用什么格式输出、什么语气说话、按什么流程办事、某个词在我们这里指什么。这类东西规则稳定、模式清晰,几百条示范就能见效。
- 事实性知识,如果量不大、会变化、需要溯源,交给 RAG;如果量很大、很稳定、需要模型真正“内化”(比如让模型学一门新语言、一个全新的专业领域),用 Mid-training 拿大量原始文本去训,而不是靠几十条问答。
我们的 Text-to-SQL 案例正好落在 SFT 擅长的那一格:模型本来就会写 SQL,缺的是公司内部的一套“口径”,比如“销售额”要用成交价而不是标价算、要排除取消和退款的订单、金额要从分换算成元、日期函数要用 SQLite 的写法。这些规则不多、很稳定,但每次都写进提示词又很啰嗦,而且小模型经常记不住,正适合用微调“固化”下来。
1.4.2 选型流程与 pass@k 判断
把上面的思路整理一下,就是下面这张图。从上往下逐个问,越靠前的办法越便宜:
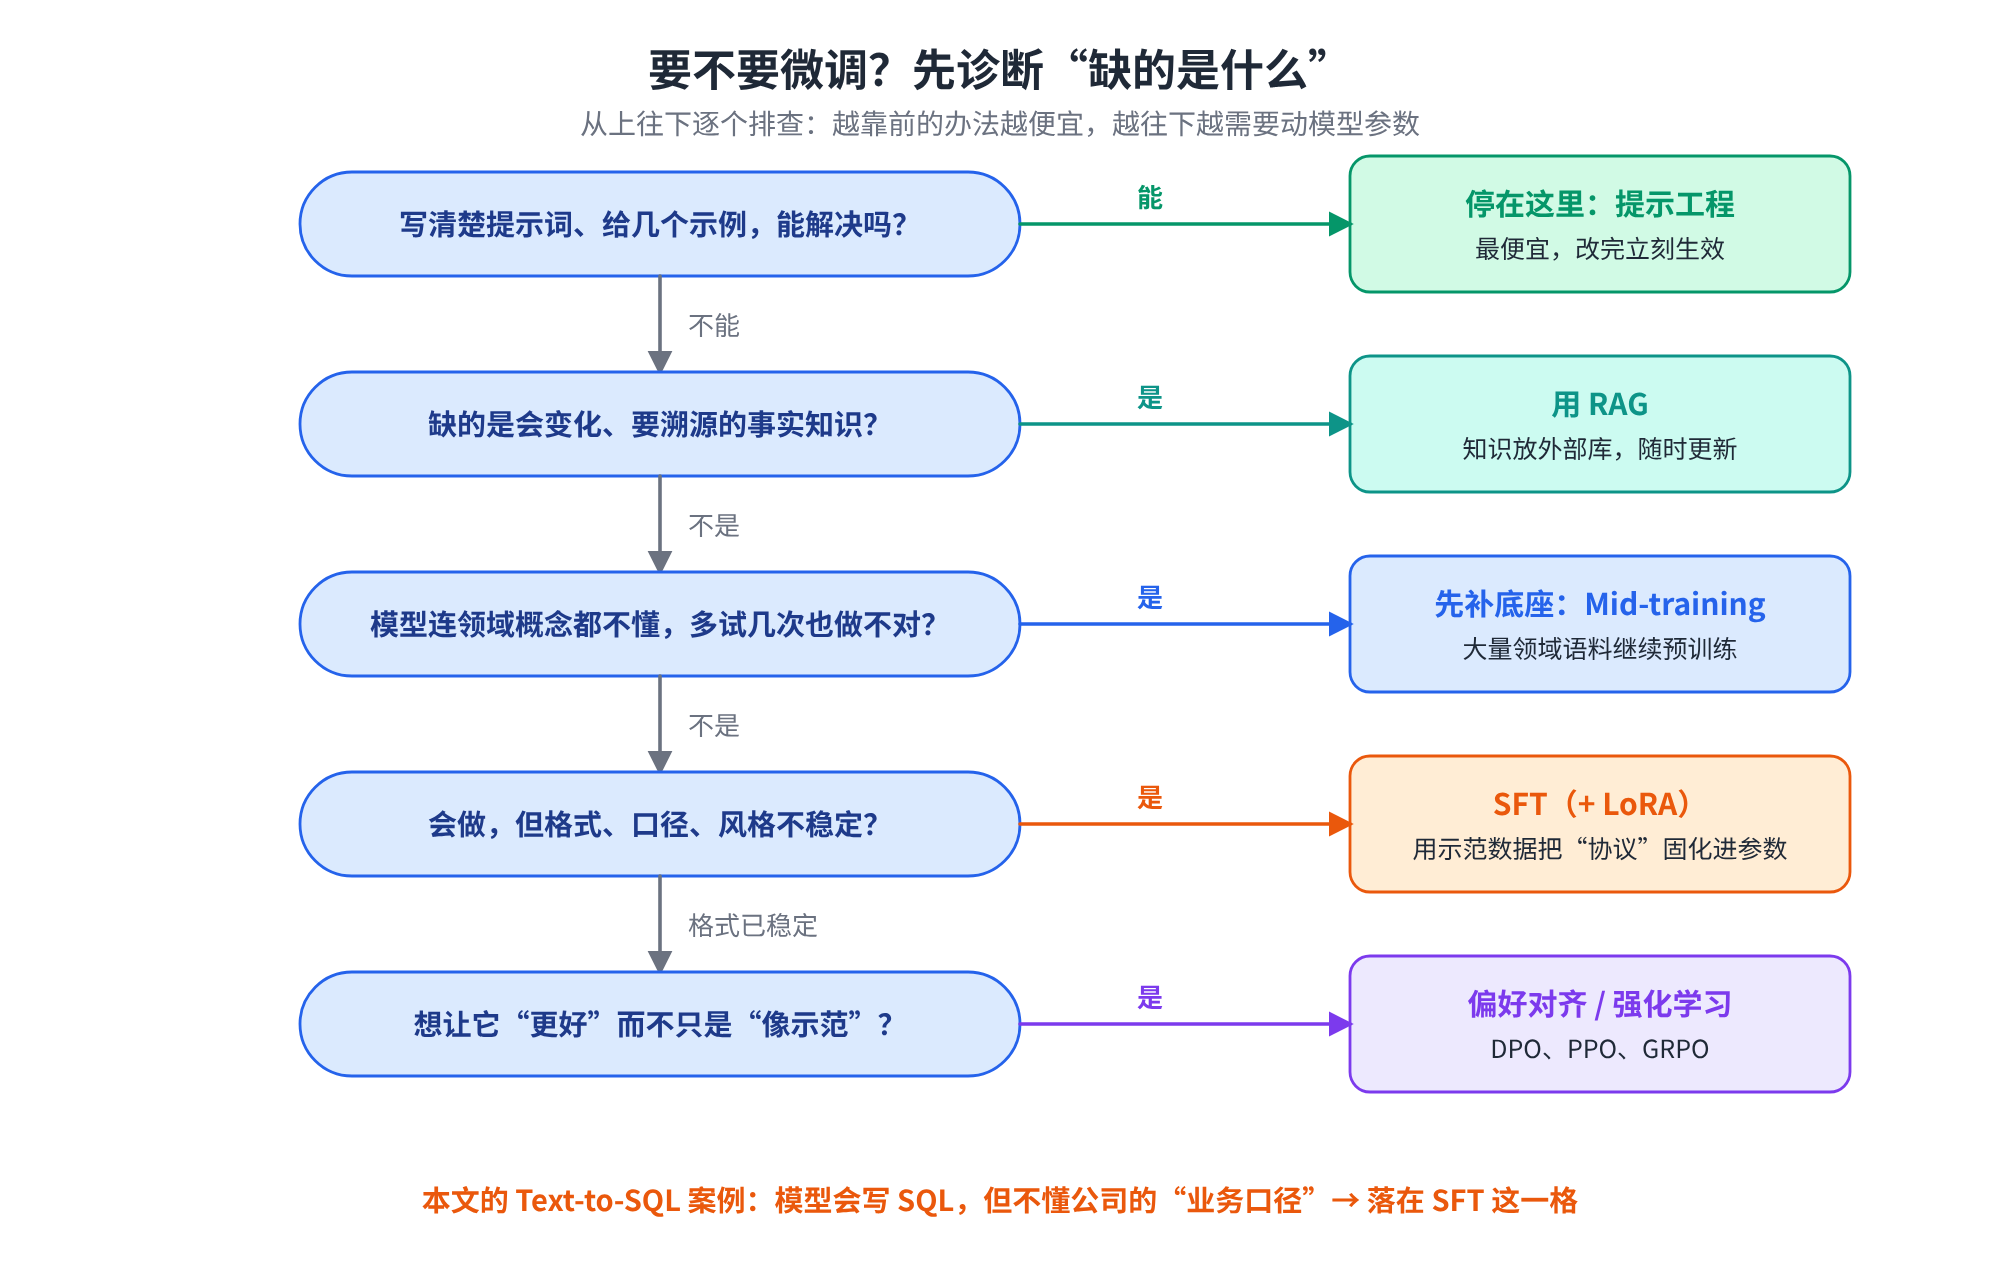
有一个实用的判断方法,来自《深入理解 AI Agent》:在你的测试题上,不只让模型答一次,而是让它采样多次,看看“至少答对一次”的比例。如果单次答对的概率是 $p$,独立采样 $k$ 次至少对一次的概率是:
$$ \text{pass@}k = 1 - (1 - p)^k $$- 如果 pass@1 很低,但 pass@10 明显更高,说明正确答案在模型的能力范围内,只是不稳定。这时 SFT 或强化学习能把这个“偶尔做对”的行为放大成“稳定做对”。
- 如果采样很多次也几乎全错(pass@k 接近 0),说明模型根本不具备这个能力。这时候直接做 SFT 或强化学习,效果会很差,应该先补底座(Mid-training),或者换一个更强的基座模型。
这条经验后面讲强化学习时还会再用到。
2 监督微调与参数高效微调
2.1 SFT 的原理:指令数据、对话模板与损失屏蔽
很多人第一次接触 SFT,会以为它是一种全新的训练方法。其实不是。SFT 和预训练在数学上是同一件事:都是预测下一个词,都在最小化同一个交叉熵损失。 区别只有两点:数据不一样,以及损失只算一部分。
2.1.1 SFT 数据格式:Alpaca 与 messages
预训练用的是互联网上什么都有的原始文本;SFT 用的是整理成“输入 → 输出”的示范对。最常见的是 Alpaca 格式:
|
|
system 是系统提示词,设定模型的角色;instruction 是用户的指令;input 是可选的补充输入(比如用户贴过来的一段报错信息);output 是我们希望模型给出的标准回答。另一种常见格式是 OpenAI 风格的 messages 列表([{"role": "user", ...}, {"role": "assistant", ...}]),适合多轮对话,本质是一样的。
2.1.2 对话模板(chat template)
模型并不认识 JSON。训练前,这条样本要先按照模型自带的对话模板(chat template)拼成一整条文本。我们用的 Qwen 系列采用 ChatML 格式,拼出来是这样:
|
|
<|im_start|>、<|im_end|> 是特殊 token,用来标记“谁在说话”和“这段话说完了”。每个模型家族的模板都不一样(Llama、DeepSeek、Qwen 各有各的写法),训练时用什么模板,推理时就必须用同一个模板,否则模型会“听不懂”。LLaMA-Factory 里的 template 参数、Transformers 里的 tokenizer.apply_chat_template(),管的都是这件事。这是新手最容易踩的坑之一:训练完一测,模型胡言乱语或者停不下来,十有八九是模板对不上。
2.1.3 损失屏蔽与 SFT 损失函数
拼好的整条序列会一起喂给模型,但计算损失时,只有 assistant 回答的那部分参与,系统提示词和用户问题的部分都被屏蔽掉。这叫损失屏蔽(loss masking)。
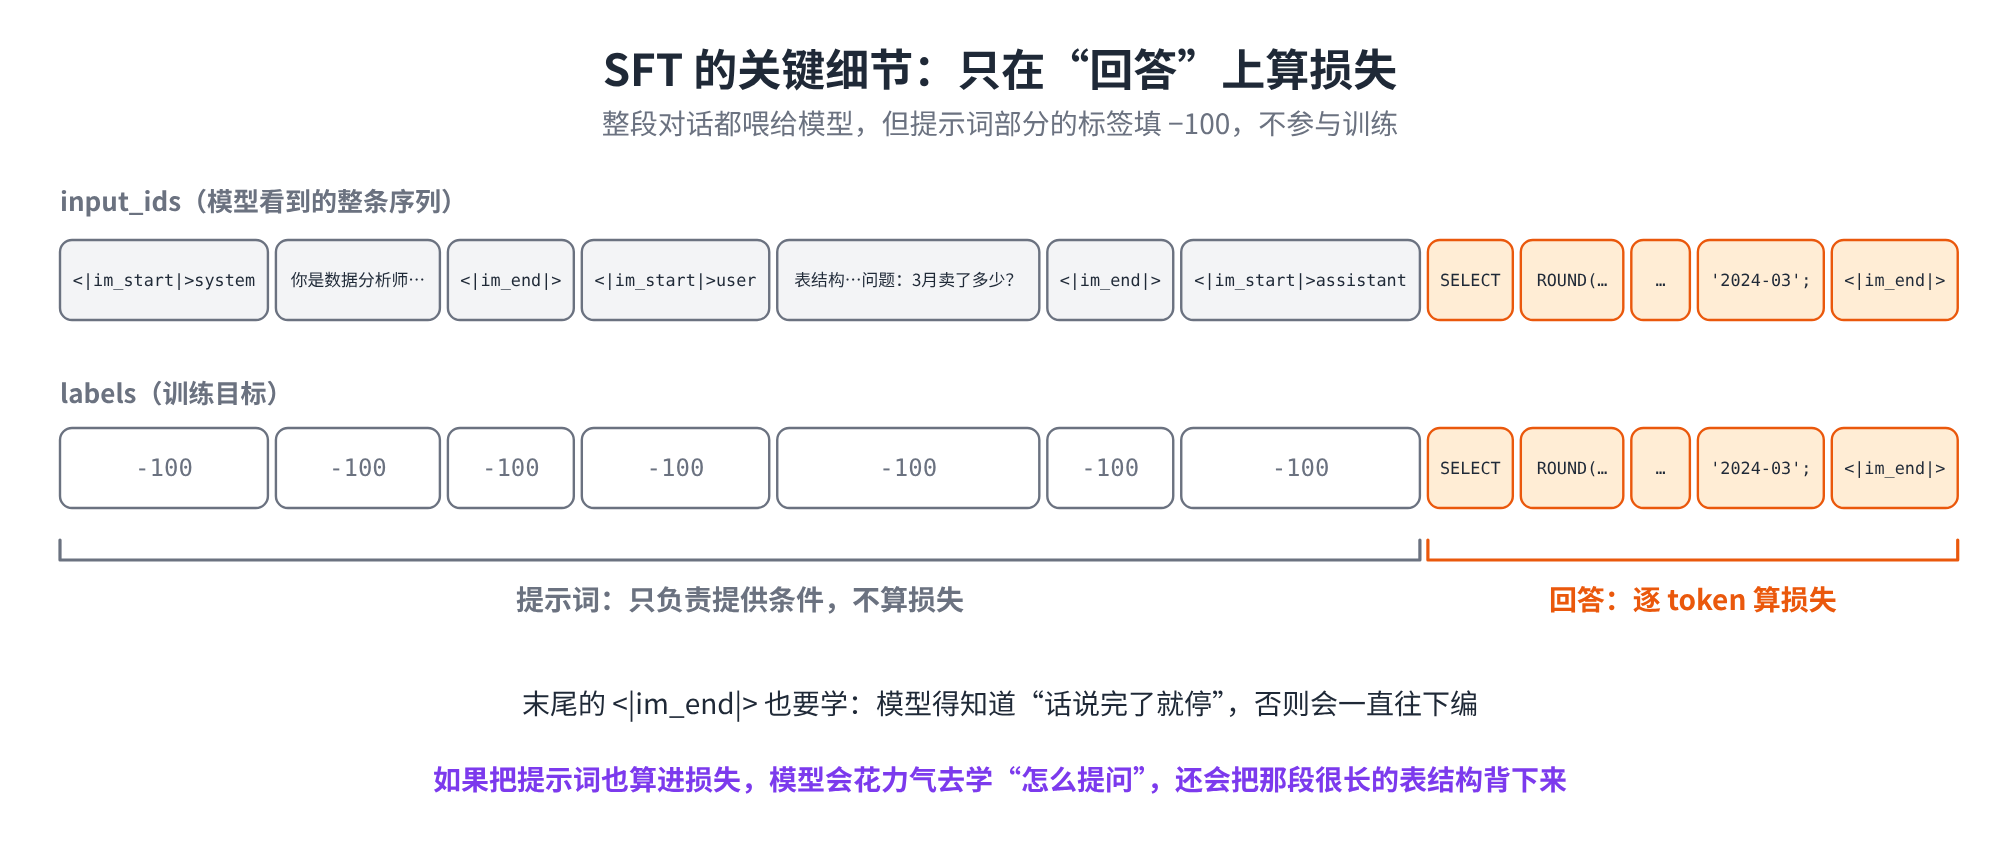
具体实现非常朴素:准备一个和输入等长的 labels 数组,提示词位置填 -100,回答位置填真实的 token 编号。PyTorch 的交叉熵损失会自动跳过标签为 -100 的位置。第四部分手写训练代码时,你会看到这就是几行列表拼接。
为什么要这么做?因为我们只想让模型学“怎么回答”,不想让它学“怎么提问”。在我们的案例里还有一个更实际的原因:每条样本的提示词里都有一大段表结构,要是这部分也算损失,模型会把大量精力花在背诵表结构上。
注意回答末尾的 <|im_end|> 也要算损失。模型必须学会“话说完了就停”,否则推理时它会一直往下编。
把上面这些写成公式,SFT 的损失是:
$$ \mathcal{L}_{\text{SFT}} = -\frac{1}{|y|}\sum_{t=1}^{|y|} \log p_\theta\left(y_t \mid x,\ y_{\lt t}\right) $$逐项翻译一下:$x$ 是提示词(系统提示 + 用户问题),$y$ 是标准回答,$y_t$ 是回答的第 $t$ 个 token,$y_{\lt t}$ 是它前面已经出现的回答部分。整个式子的意思是:在给定提示词和前文的条件下,让标准回答里每一个 token 的概率都尽量高,然后取平均。 和第 1.1 节的预训练损失比,唯一的区别就是求和只覆盖回答部分。
这个公式也解释了上一节说的“SFT 擅长教规矩、不擅长灌知识”:它的目标是逐字复现示范。示范里的格式、措辞、流程,会被非常高效地学进去;但如果示范只覆盖了某条知识的两三种问法,模型学到的也就只是这两三条路径。
2.2 训练循环与超参数
知道了损失怎么算,再来看训练循环。不管是 LLaMA-Factory 还是手写代码,底层都是同一个循环,重复几百上千次:
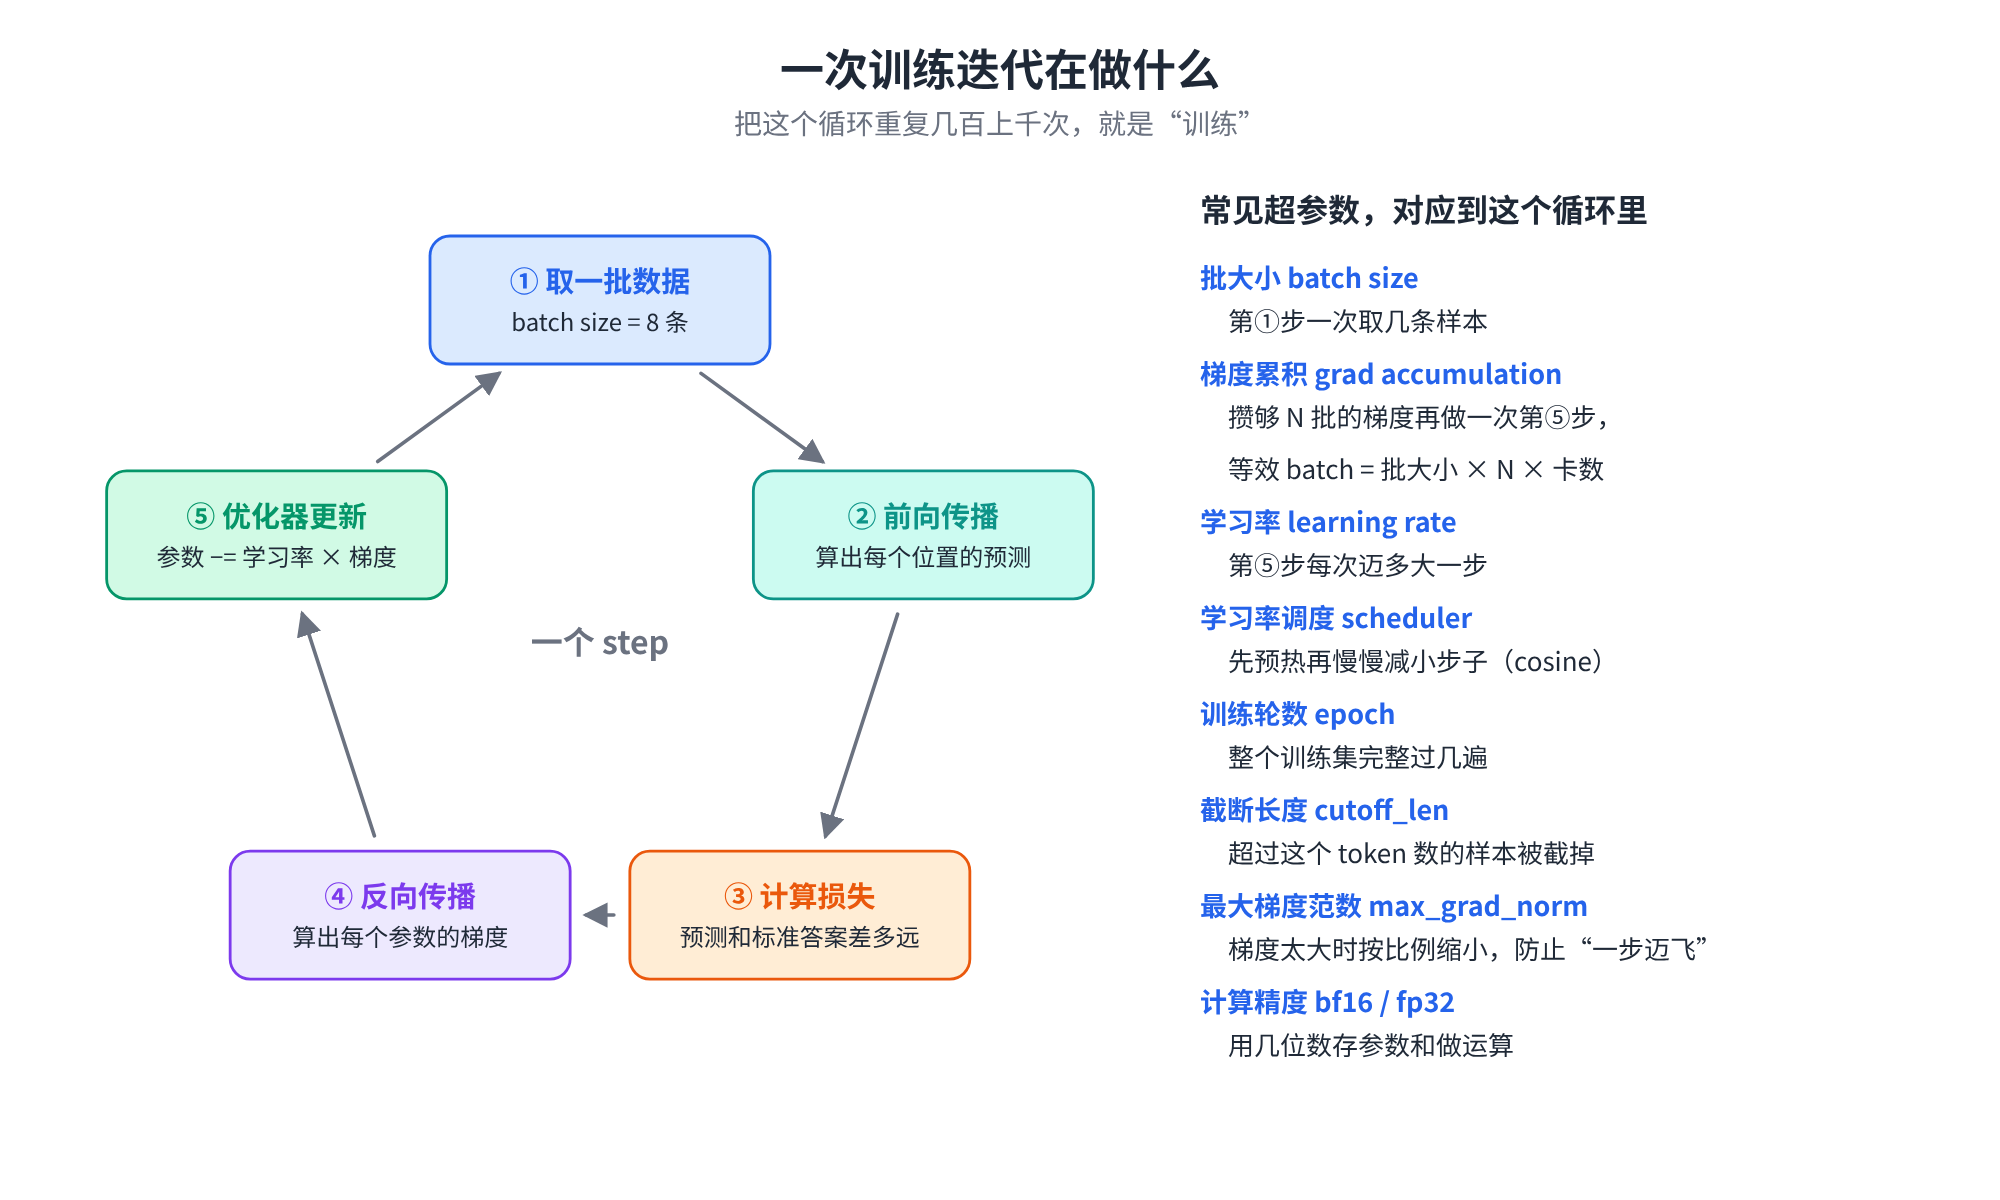
LLaMA-Factory 界面上那一排训练参数,都能在这个循环里找到位置:
- 批大小(batch size):第 ① 步一次取几条样本。越大,梯度估计越准、训练越稳,但显存占用越高。
- 梯度累积(gradient accumulation):显存放不下大 batch 时的变通办法。每次只算一小批,但先不更新参数,把梯度攒够 N 批再更新一次。效果上等价于把 batch 放大 N 倍。等效 batch = 批大小 × 累积步数 × GPU 数量。
- 学习率(learning rate):第 ⑤ 步每次迈多大。太大会“一步迈过头”,损失上蹿下跳甚至发散;太小学得很慢。LoRA 微调常用 1e-4 到 2e-4,全参数微调通常要小一个数量级(1e-5 左右)。
- 学习率调度(scheduler)与预热(warmup):学习率不是一成不变的。常见做法是开头几十步从 0 慢慢升到设定值(预热,避免一开始梯度太大把模型带偏),然后按余弦曲线(cosine)逐渐减小,越到后面步子越小,方便“精细收敛”。
- 训练轮数(epoch):整个训练集完整过几遍。数据量几百到几千条时,2 到 5 轮比较常见。
- 截断长度(cutoff_len):超过这个 token 数的样本会被截掉。要比你最长的样本长一些,否则回答被截断,模型会学到“说到一半就停”。
- 最大梯度范数(max_grad_norm):某一步梯度特别大时,按比例把它缩小到这个上限以内,防止参数被一下子推飞(梯度爆炸)。
- 计算精度(bf16 / fp16 / fp32):用几位二进制数存参数和做运算。bf16 在新一代 GPU(30 系、40 系、A100 及以后)上是默认选择,比 fp32 省一半显存,数值也比 fp16 稳定。
2.2.1 用训练损失和验证损失判断欠拟合与过拟合
训练过程中最重要的仪表盘是损失曲线。很多教程会说“尽可能把损失降到最低”,这句话要补一个重要的限定:降到最低的应该是验证集损失,而不是训练集损失。
训练集上的损失几乎一定会一路下降,因为模型可以把训练数据背下来。真正说明问题的,是模型没见过的验证集上的损失:
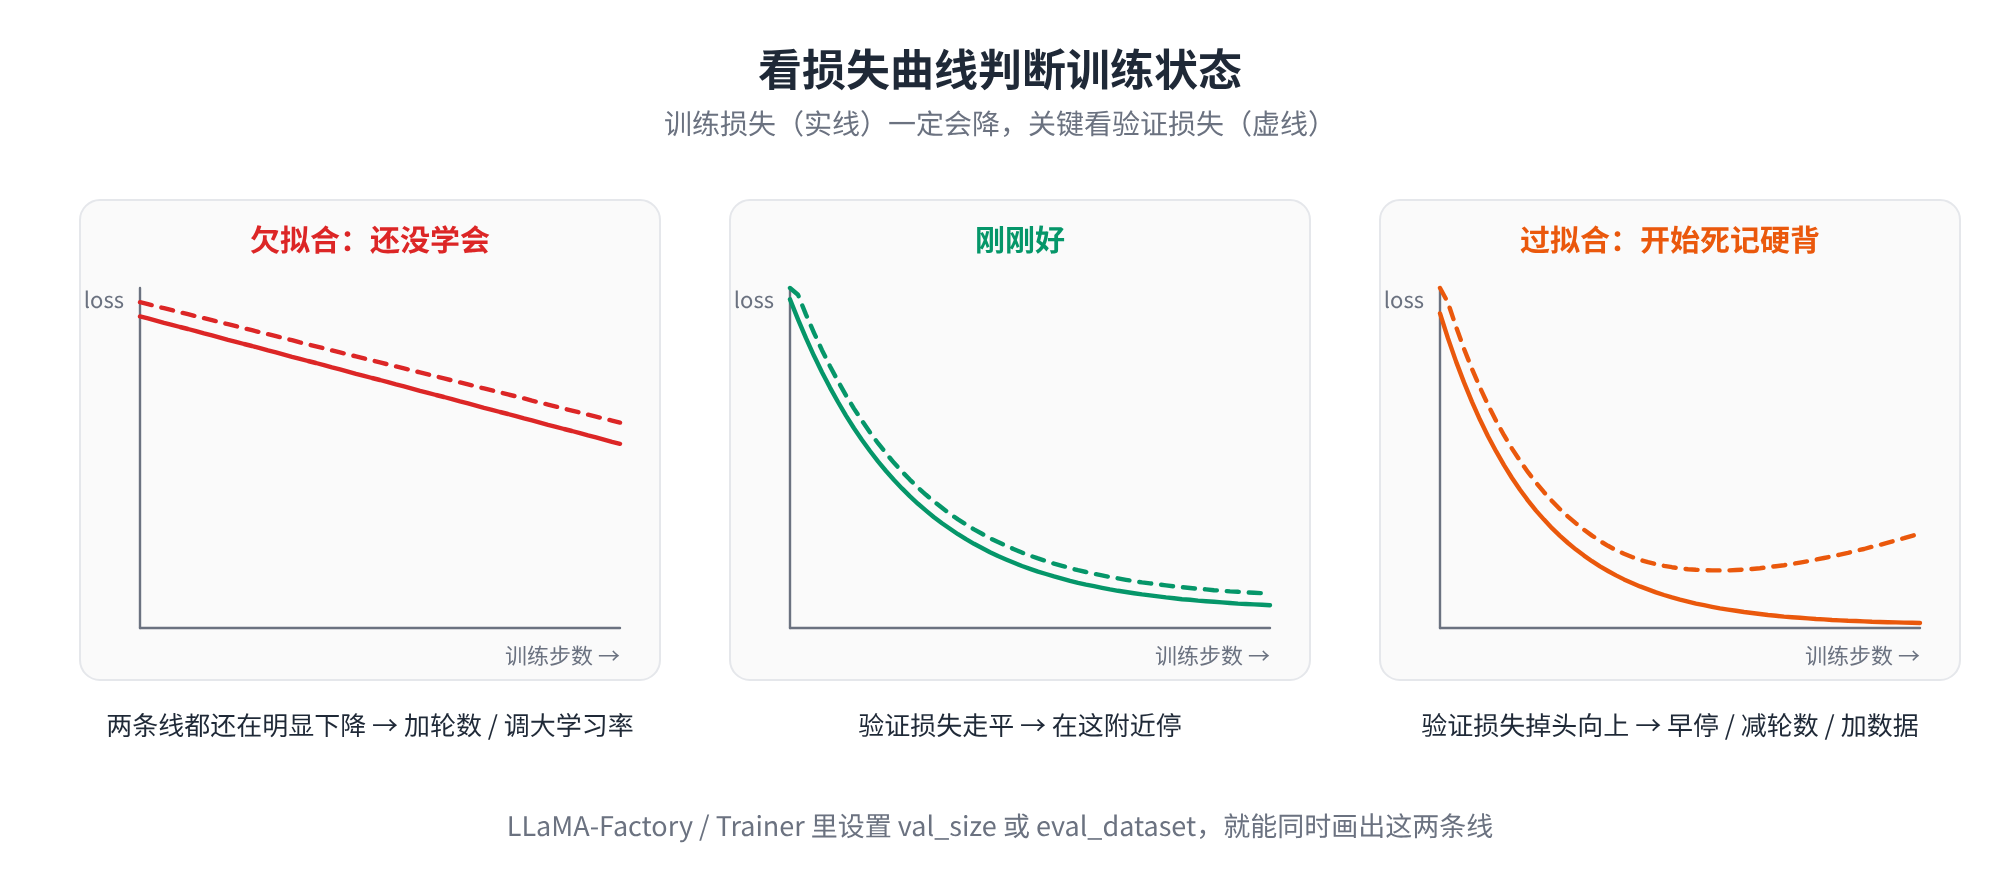
- 欠拟合:两条线都还在明显下降,说明还没学够,可以加轮数或调大学习率。
- 刚刚好:验证损失走平,在这附近停下。
- 过拟合:训练损失还在降,验证损失却掉头向上,说明模型开始死记硬背训练集的细节,对新问题的表现反而变差。这时应该提前停止、减少轮数,或者补充更多样化的数据。
所以训练时一定要留一份验证集(LLaMA-Factory 里的 val_size,比如 0.05 表示拿 5% 的数据做验证),并且最终效果要用一份完全独立的测试集来评估,而不是看训练损失有多低。
2.3 SFT 数据的来源、构造与质量控制
SFT 的效果,一半取决于模型,另一半取决于数据。这里说的“数据”,重点不在数量,而在质量和覆盖面。
数据从哪来? 业界基本就三条路,经常组合使用:
- 人工示范:质量上限最高,但贵且慢。适合用来写“种子数据”,定义好格式和风格。
- 用更强的模型生成(合成数据):让强模型按种子数据的样子批量产出新样本,再过滤。常说的“数据增强”,主要就是这条路。
- 拒绝采样:让模型对同一个问题生成多个答案,用程序或人工挑出正确的留下,再拿来训练自己。我们的 Text-to-SQL 特别适合这么做,因为 SQL 的对错能自动判断。
怎么造得好? 一条稳妥的流程是:先定义清楚任务的输入输出格式,再批量生成候选,然后用规则检查、格式校验加人工抽检过滤,最后去重、平衡各类样本的比例。第四部分的数据脚本就是按这个思路写的:人工写好二十来个“问题模板 + 标准 SQL”,程序填入不同的参数放大成几百条,每一条 SQL 都在真实数据库上执行一遍,执行失败、结果为空或者排名有并列(标准答案不唯一)的样本全部丢弃。
有几条值得记住的经验:
- 宁缺毋滥。 数据里的每一处错误,SFT 都会忠实地学进去。与其堆十万条脏数据,不如精修一千条干净数据。对于格式、口径这类任务,几百到几千条高质量样本往往就够了。
- 注意均衡。 我们第一次生成数据时,“按客户姓名查订单数”这一类因为姓名多、组合多,一下子占了一半样本。模型会因此“偏科”。脚本里给每类问题设了上限,就是为了避免这个问题。
- 测试集要“够陌生”。 只从训练数据里随机抽一部分当测试集,测出来的分数往往偏高,因为题型都见过。更严格的做法是留出几类训练中完全没出现过的题型,单独测一次,看模型学到的是规则本身,还是只记住了句式。第四部分的评测会分别统计这两个分数。
- 小心灾难性遗忘。 在一个窄任务上猛训,模型可能把原来的通用能力忘掉一部分,这叫灾难性遗忘。缓解办法包括:用 LoRA 而不是全参数微调(原权重被冻结,扰动更小)、学习率和轮数别太激进、在训练数据里混入一些通用对话数据。
2.4 全参数微调的显存开销
讲完 SFT 训练什么,再来看用什么方式训练。最直接的做法是全参数微调:模型里的所有参数都参与更新。效果通常最好,但代价很高。代价主要不在计算,而在显存。
训练时显存里要放的不只是模型本身。以最常见的“混合精度 + AdamW 优化器”为例,每个参数要占用:
- 权重本身:bf16 格式,2 字节;
- 梯度:每个参数都要存一个梯度,bf16 格式,2 字节;
- 优化器状态:AdamW 要给每个参数记两个“动量”(可以理解为梯度的历史平均和历史波动),为了数值稳定用 fp32 存,共 8 字节;
- fp32 主权重:混合精度训练通常还要保留一份 fp32 的权重副本用来累积更新,4 字节。
加起来,每个参数大约 16 字节,这还没算前向传播时的中间结果(激活值),后者随 batch 大小和序列长度变化,常常还要再加几 GB 到几十 GB。
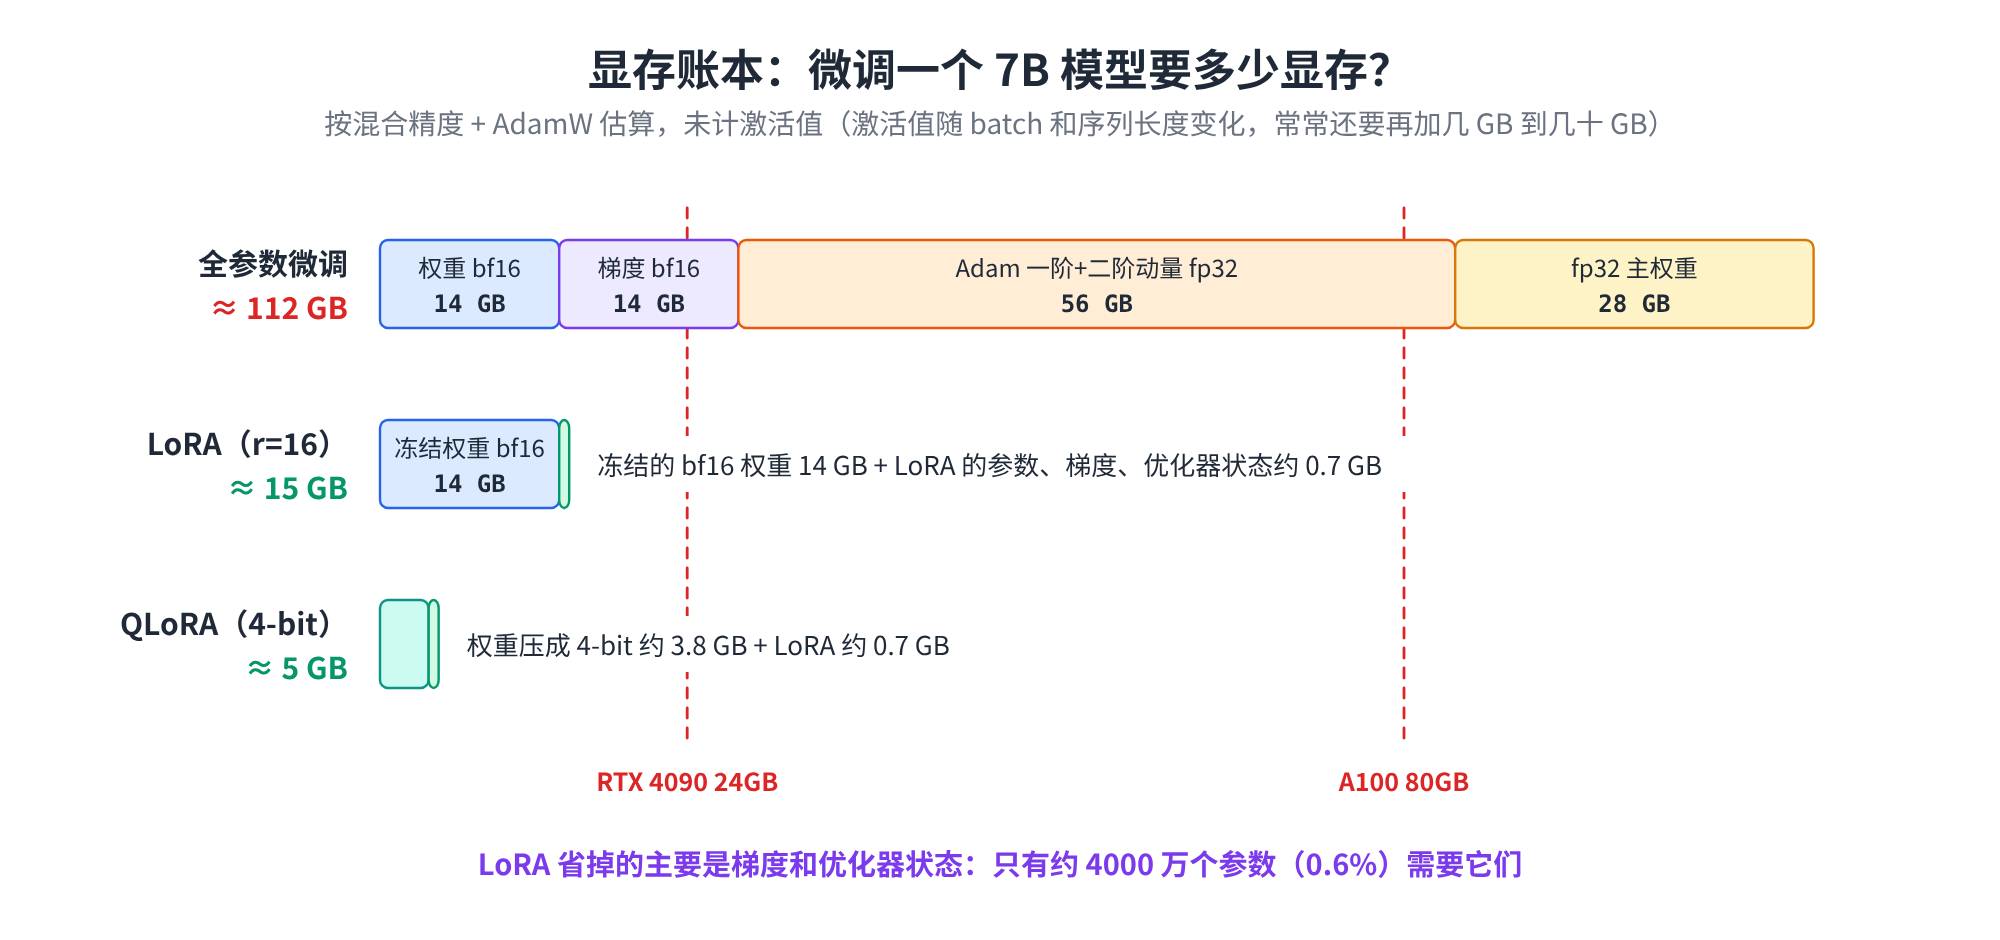
按这个算法,全参数微调一个 7B 模型需要大约 112 GB 显存,一张 80 GB 的 A100 都放不下。即使是我们实战用的 1.5B 小模型,也要约 25 GB,一张 24 GB 的 RTX 4090 同样不够。(不同框架和优化手段下的实测数字会有出入,比如《大模型基础》引用的实验中,LLaMA2-7B 全量微调约需 60 GB,但量级上的结论是一致的:全参数微调远超消费级显卡的能力。)
仔细看这本账会发现:权重本身只占小头,大头是梯度和优化器状态,而它们只有“需要训练的参数”才有。那么,如果只训练一小部分参数呢?这就是参数高效微调(Parameter-Efficient Fine-Tuning,PEFT)的出发点。
2.5 参数高效微调(PEFT)的三类方法
PEFT 的思路是:冻结原模型的绝大部分参数,只训练很少一部分(新加的,或者从原模型里挑出来的),用不到 1% 的可训练参数,换来接近全参数微调的效果。
除了省显存,PEFT 还有两个好处:一是存储省,每个任务只需要保存那一小部分参数,几十 MB 而不是几个 GB;二是灵活,同一个基座模型可以挂载不同任务的“插件”,切换起来很方便。
根据“训练的那一小部分参数从哪来”,《大模型基础》把主流 PEFT 方法分成三大类。我们先看一张总图,看它们分别“插”在模型的什么位置:
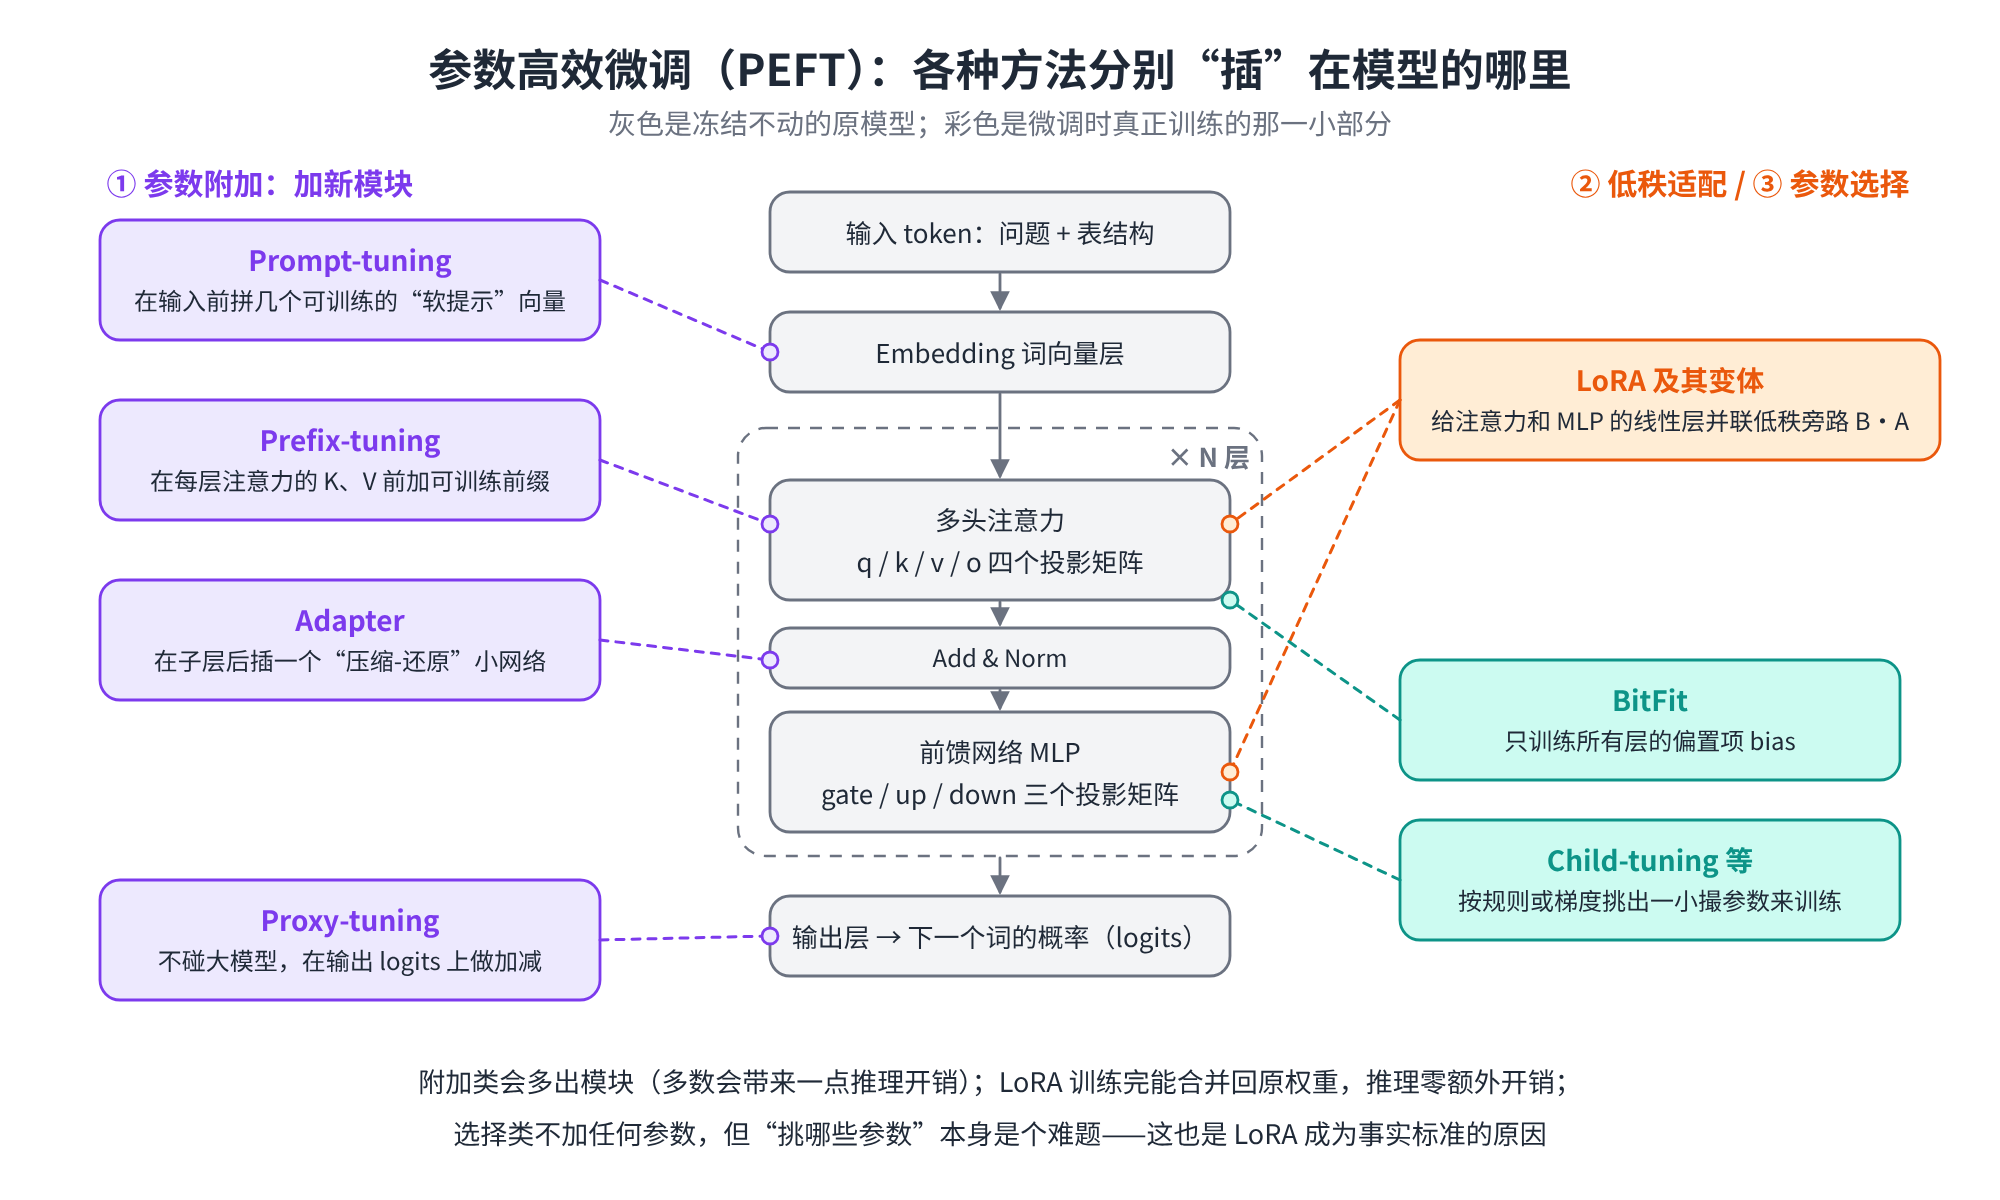
2.5.1 参数附加方法:Prompt-tuning、Prefix-tuning、Adapter、Proxy-tuning
在模型里附加一些新的、很小的可训练模块,原模型参数全部冻结。按加的位置,又分三种:
加在输入:Prompt-tuning。 平时我们写的提示词是离散的文字,叫“硬提示”。Prompt-tuning 换个思路:在输入的词向量序列前面,拼上 $m$ 个可训练的向量(叫“软提示”)。设输入文本经过嵌入层变成矩阵 $X \in \mathbb{R}^{n \times d}$($n$ 个 token,每个 $d$ 维),软提示是 $P \in \mathbb{R}^{m \times d}$,模型实际的输入是二者拼接 $[P; X]$。训练时只更新 $P$。它本质上是让模型自己学一段最优的“提示词”,只不过这段提示词不是人能读懂的文字,而是一组向量。参数量小到惊人:以 T5-XXL(110 亿参数)为例,软提示长度为 5 时,只需要训练 20480 个参数。软提示长度一般在 20 以上效果才比较稳定,而且模型越大,Prompt-tuning 的效果越接近全参数微调。
加在模型内部:Prefix-tuning 和 Adapter。
- Prefix-tuning 是 Prompt-tuning 的加强版:不只在输入层,而是在每一层注意力的 Key 和 Value 前面都拼上一段可训练的前缀向量,可训练参数比 Prompt-tuning 多,表达能力也更强。
- Adapter 在 Transformer 每个子层(注意力层、前馈层)后面插入一个“瓶颈”结构的小网络:先用一个矩阵 $W_d \in \mathbb{R}^{d \times r}$ 把 $d$ 维特征压缩到很低的 $r$ 维,经过激活函数,再用 $W_u \in \mathbb{R}^{r \times d}$ 还原回 $d$ 维,最后加上原来的输入(残差连接):
每个 Adapter 的参数量是 $2dr + d + r$(两个投影矩阵加偏置),$r$ 远小于 $d$ 时非常省。Adapter 的问题在于:它是串联在原来的计算路径上的,推理时每一层都要多算一次,会带来额外的延迟。
加在输出:Proxy-tuning。 这是一种很巧妙的思路:如果大模型太大,或者根本拿不到权重(比如只能调 API 的闭源模型),能不能不碰它,也让它学会新任务?Proxy-tuning 的做法是,拿一个同词表的小模型,复制两份:一份微调成“专家”$M^+$,一份保持原样当“反专家”$M^-$。生成每个 token 时,用两个小模型输出分数的差值去修正大模型 $M$ 的输出分数:
$$ \tilde{s} = s_M + \left(s_{M^+} - s_{M^-}\right) $$$s_{M^+} - s_{M^-}$ 恰好代表了“微调学到了什么”,把它加到大模型上,就相当于把小模型学到的东西“嫁接”了过去。
2.5.2 参数选择方法:BitFit、Child-tuning
不加任何新参数,而是从原模型里挑出一小部分参数来训练,其余冻结。
- BitFit 规则最简单:只训练每一层的偏置项(bias),它们只占总参数的约 0.08%~0.09%。在 BERT 这类模型上,效果能和全参数微调相当。不过很多现代大模型的线性层干脆没有偏置项,这个方法也就无从下手了。
- Child-tuning 用一个和参数矩阵同样大小的 0-1 掩码 $M$ 来决定“谁参与更新”:更新时梯度要先乘上掩码,$W \leftarrow W - \eta \left(\frac{\partial \mathcal{L}}{\partial W} \odot M\right)$,掩码为 0 的位置就不动。掩码可以随机生成(每一步按一定比例随机挑),也可以根据任务数据计算每个参数的重要性(用费舍尔信息衡量“这个参数对任务的输出影响有多大”),只挑最重要的那部分。
参数选择方法的好处是推理时没有任何额外开销;难点在于“挑哪些参数”本身就是个难题,而且挑出来的参数散落在矩阵各处,在 GPU 上并不好高效实现。
2.5.3 低秩适配方法与三类方法对比
第三类是今天最常用的 LoRA(Low-Rank Adaptation,低秩适配)及其各种变体。它几乎成了“微调”的代名词,下一节专门展开。
先用一张表把三类方法放在一起比较:
| 类别 | 代表方法 | 训练什么 | 推理开销 | 主要问题 |
|---|---|---|---|---|
| 参数附加 | Prompt-tuning、Prefix-tuning | 输入或每层前面的软提示向量 | 占用一部分上下文长度 | 训练不太稳定,小模型上效果一般 |
| 参数附加 | Adapter | 每层插入的瓶颈小网络 | 有,每层多一次计算 | 串联结构带来延迟 |
| 参数附加 | Proxy-tuning | 一个小的专家模型 | 有,要同时跑三个模型 | 需要同词表的小模型 |
| 参数选择 | BitFit、Child-tuning | 原模型中的一部分参数 | 无 | 选哪些参数难;实现不够高效 |
| 低秩适配 | LoRA 及变体 | 并联在线性层旁的两个低秩矩阵 | 无(可合并) | 秩太低时表达能力受限 |
2.6 LoRA 的原理
2.6.1 矩阵的秩
LoRA 的名字里有个“低秩”,所以得先花两分钟理解矩阵的秩。
教科书上的定义是:秩是矩阵中线性无关的行或列的最大数量,它反映了矩阵包含的有效信息量。这句话有点抽象,看个例子就明白了:
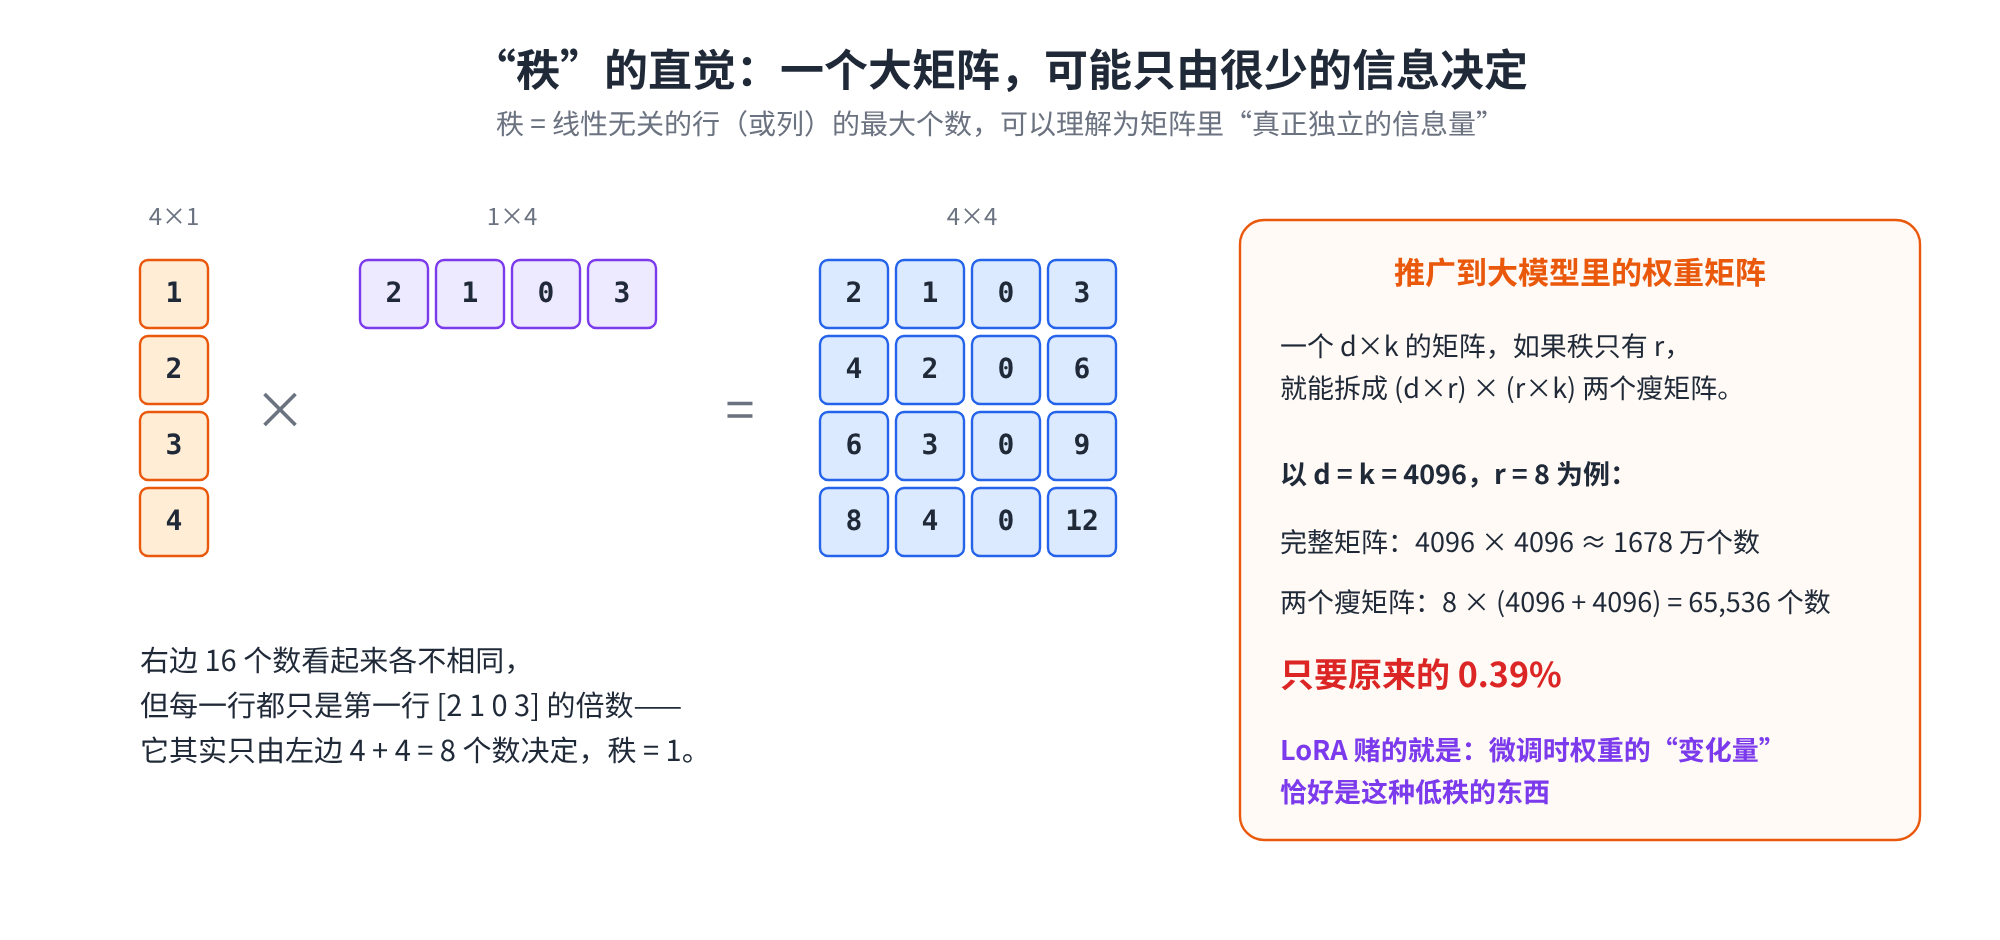
右边这个 4×4 矩阵有 16 个数,看起来各不相同。但仔细看,第二行是第一行的 2 倍,第三行是 3 倍,第四行是 4 倍,每一行都只是第一行的倍数,没有提供任何新的“方向”。所以它的秩是 1。它其实完全由左边一个 4×1 的列向量和一个 1×4 的行向量相乘得到,16 个数只由 8 个数决定。
推广一下:一个 $d \times k$ 的矩阵如果秩为 $r$,就可以拆成一个 $d \times r$ 矩阵乘以一个 $r \times k$ 矩阵,需要存的数从 $d \times k$ 个降到 $r \times (d + k)$ 个。当 $d = k = 4096$、$r = 8$ 时,从约 1678 万个降到 65536 个,只有原来的 0.39%。
2.6.2 低秩假设与 LoRA 公式
模型里绝大多数参数都在一个个巨大的权重矩阵里(注意力的 q、k、v、o 投影,前馈网络的 gate、up、down 投影)。微调,就是给这些矩阵加上一个变化量 $\Delta W$:
$$ W = W_0 + \Delta W $$$W_0$ 是预训练好的原权重。全参数微调时,$\Delta W$ 和 $W_0$ 一样大,每个元素都要训练。
LoRA 的论文(微软,2021 年)提出了一个大胆的假设:微调时的变化量 $\Delta W$ 是“低秩”的。 背后的直觉是,预训练模型已经学到了非常丰富的通用表示,适配一个具体任务时,只需要在少数几个“方向”上做调整,而不需要动用矩阵的全部自由度。这个想法有理论依据:此前的研究已经发现,大模型的“固有维度”(intrinsic dimension)其实很低,在一个很小的子空间里优化,就能达到接近全参数优化的效果。
既然 $\Delta W$ 是低秩的,那就干脆直接把它写成两个瘦矩阵的乘积:
$$ \Delta W = B A, \qquad B \in \mathbb{R}^{d \times r},\ A \in \mathbb{R}^{r \times k},\ r \ll \min(d, k) $$训练时冻结 $W_0$,只训练 $A$ 和 $B$。前向计算变成:
$$ h = W_0 x + \frac{\alpha}{r} B A x $$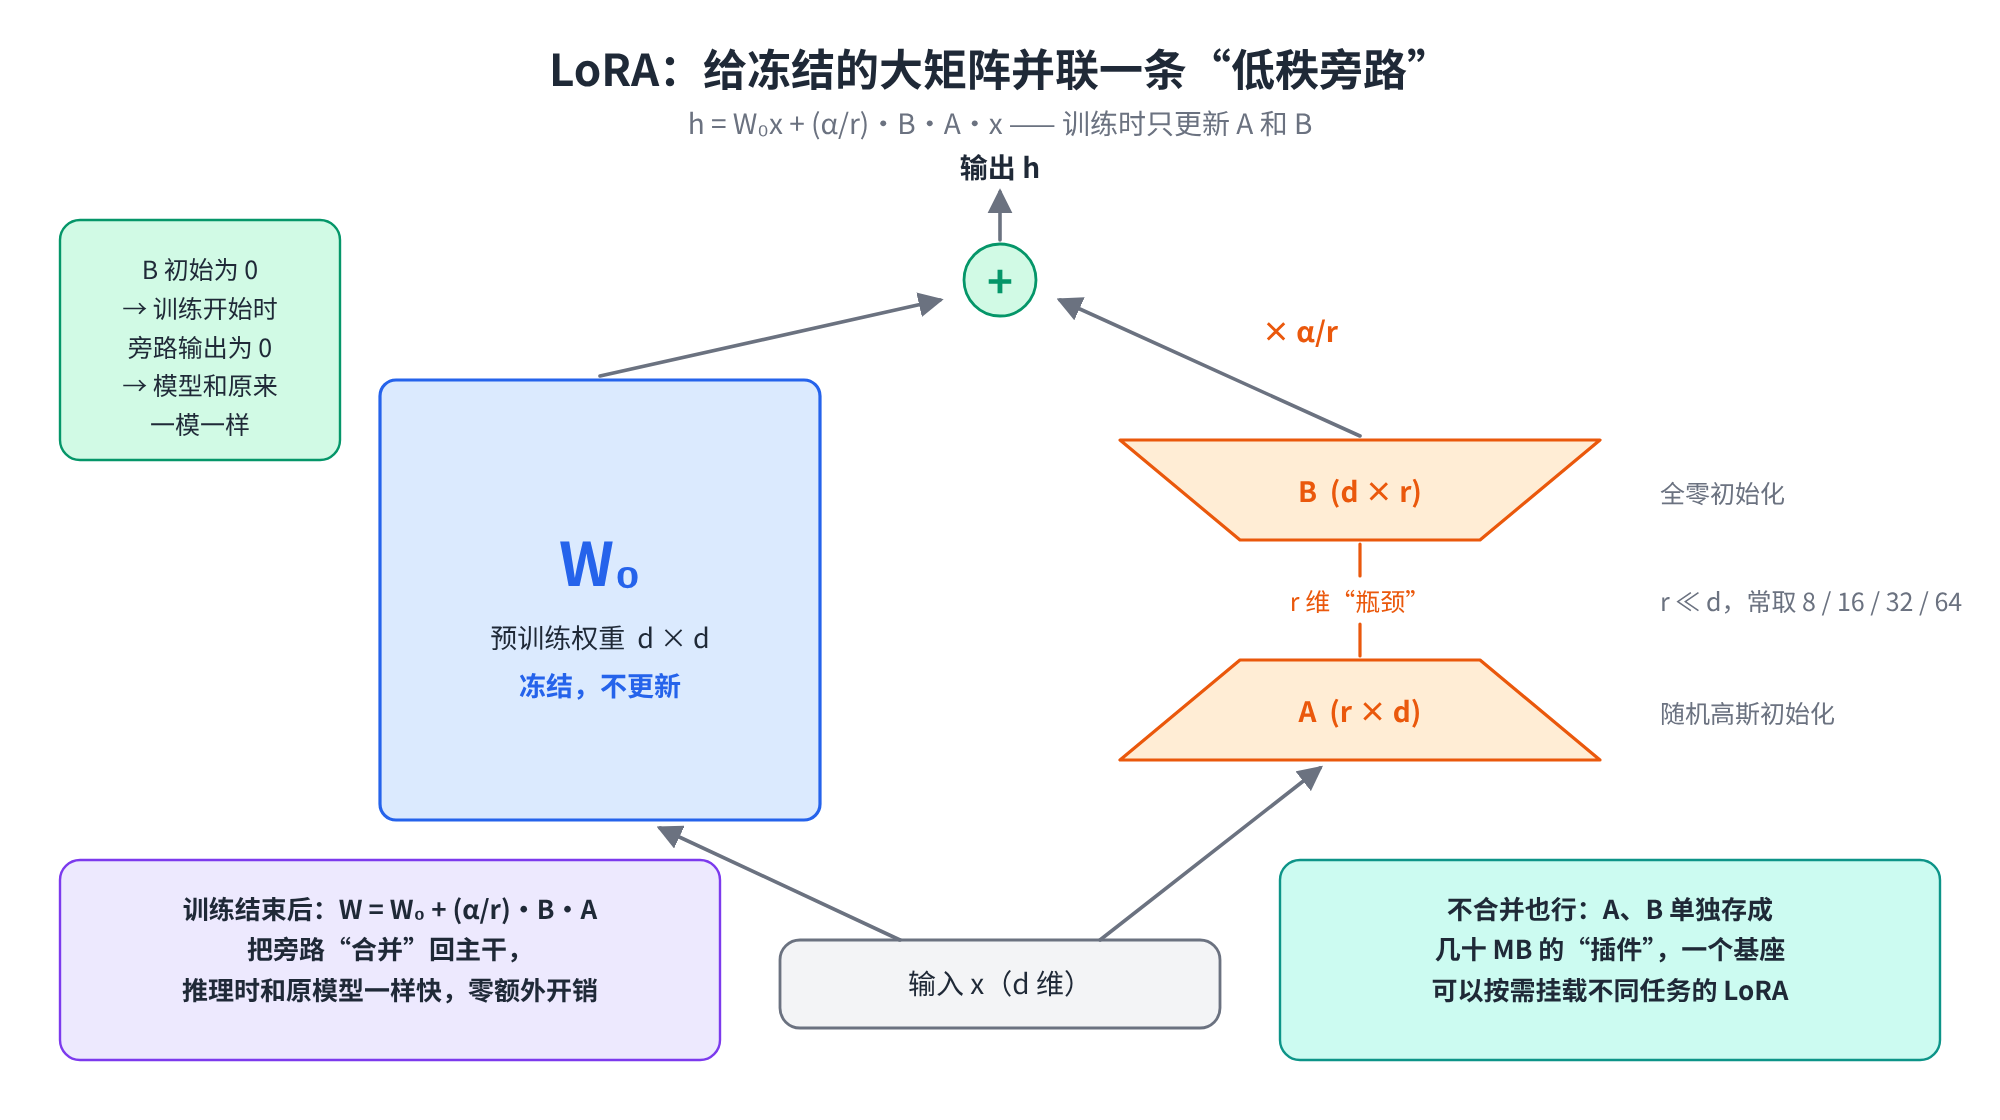
逐项解释这张图和这个公式:
- 主干 $W_0 x$:原来的计算,权重冻结,不更新。
- 旁路 $BAx$:输入 $x$ 先经过 $A$ 被压缩到只有 $r$ 维(这就是“瓶颈”),再经过 $B$ 还原回原来的维度。旁路的输出和主干相加,就是最终输出。
- 缩放系数 $\frac{\alpha}{r}$:$\alpha$(代码里叫
lora_alpha)是一个超参数。乘上 $\frac{\alpha}{r}$ 的作用是让旁路输出的量级不随 $r$ 的变化而剧烈变化,这样换一个 $r$ 时,不用重新调学习率。实践中常设 $\alpha = 2r$ 或 $\alpha = r$。 - 初始化:$A$ 用随机高斯分布初始化,$B$ 全部初始化为 0。这样训练开始时 $BA = 0$,旁路输出为零,模型和原来一模一样。训练是从原模型“平稳出发”的,不会一上来就被随机的旁路搅乱。(《大模型基础》第 4 章写的是 B 随机、A 为零,和 LoRA 原论文正好相反。两种方式都能保证起点为零,但原论文和 PEFT 等主流实现都是 A 随机、B 为零,以它们为准。)
2.6.3 LoRA 的参数量计算
先看《大模型基础》里的例子。LLaMA2-7B 第一个前馈层的权重矩阵是 11008 × 4096,全参数微调要训练 45,088,768 个参数;用 $r = 4$ 的 LoRA,只需要 11008 × 4 + 4 × 4096 = 60,416 个,不到原来的千分之一点五。
再看我们实战要用的 Qwen2.5-Coder-1.5B。它有 28 层,每层有 7 个线性层可以挂 LoRA。隐藏维度是 1536,前馈层中间维度是 8960;因为用了分组查询注意力(GQA),k、v 投影的输出只有 256 维。取 $r = 16$,每层的 LoRA 参数量是:
| 线性层 | 形状(输入 → 输出) | LoRA 参数 = r × (输入 + 输出) |
|---|---|---|
| q_proj、o_proj | 1536 → 1536 | 各 16 × 3072 = 49,152 |
| k_proj、v_proj | 1536 → 256 | 各 16 × 1792 = 28,672 |
| gate_proj、up_proj | 1536 → 8960 | 各 16 × 10496 = 167,936 |
| down_proj | 8960 → 1536 | 16 × 10496 = 167,936 |
| 每层合计 | 659,456 |
28 层一共约 1846 万个可训练参数,只占模型总参数(约 15.4 亿)的 1.2%。第四部分训练时,代码会打印出这个数字,你可以亲眼核对。
这 1.2% 的参数需要梯度和优化器状态,剩下 98.8% 的冻结参数只需要存一份 bf16 权重。回到上一节的显存账本:1.5B 模型全参数微调要约 25 GB,换成 LoRA 后,权重约 3 GB 加上 LoRA 部分的零头,再加上激活值,一张 24 GB 的显卡绰绰有余。
2.6.4 权重合并与多 LoRA 挂载
LoRA 最漂亮的地方在训练之后。因为 $W_0 x + BAx = (W_0 + BA)x$,训练结束后,可以直接把 $BA$(乘上缩放系数)加回原权重:
$$ W = W_0 + \frac{\alpha}{r} B A $$合并后的模型和原模型结构完全一样,推理速度也完全一样,没有任何额外开销。这是它相对 Adapter 的最大优势,也是实战中“训练结束后合并权重”那一步的原理。
也可以不合并。$A$ 和 $B$ 单独保存下来,只有几十 MB,相当于一个“插件”。同一个基座模型可以按需挂载不同任务的 LoRA:一个负责写 SQL,一个负责写周报,一个负责客服话术。一些推理框架(比如 vLLM)支持在一个服务里同时加载多个 LoRA,按请求切换,非常适合多租户场景。
2.7 LoRA 超参数、QLoRA 与 LoRA 变体
2.7.1 r、lora_alpha、lora_dropout 与 target_modules
LoRA 主要有四个超参数:
r(秩):旁路的“宽度”,决定了 LoRA 的表达能力。常见取值 8、16、32、64。任务越复杂、数据越多,可以设得越大;数据很少时设小一点,不容易过拟合。格式、口径这类任务,16 或 32 一般就够了。lora_alpha(缩放系数):真正生效的缩放是 $\alpha / r$。常见设成 $r$ 的 1 到 2 倍。(有的资料说 alpha“通常与 r 成反比”,这个说法容易误导:和 $r$ 成反比的是缩放系数 $\alpha/r$,不是 $\alpha$ 本身。实际操作中,换 $r$ 时一般让 $\alpha$ 跟着同比例变化,比如始终保持 $\alpha = 2r$。)lora_dropout:对旁路输入做随机丢弃,防止过拟合,常用 0.05 左右,数据多时可以设为 0。target_modules(挂在哪些层上):最初的 LoRA 论文只挂在注意力的 q、v 两个投影上。后来的大量实践表明,挂在所有线性层上(包括参数量最大的前馈层)效果明显更好,而增加的参数并不多。LLaMA-Factory 里设lora_target: all就是这个意思。
学习率方面,Thinking Machines Lab 在《LoRA Without Regret》中总结过一条实用经验:LoRA 的最优学习率大约是全参数微调的 10 倍。全参数微调常用 1e-5 级别,LoRA 常用 1e-4 级别,本文实战用的是 2e-4。
2.7.2 QLoRA:4 位量化与 LoRA 结合
LoRA 省掉了梯度和优化器状态,但冻结的权重本身还要占地方:7B 模型的 bf16 权重就要 14 GB。QLoRA(2023 年)进一步把这部分也压缩了:
- 冻结的原权重用 4 位精度存储(一种叫 NF4 的格式,专门为神经网络权重的正态分布设计),7B 模型的权重从 14 GB 压到 4 GB 左右;
- LoRA 的 A、B 仍然用 bf16 训练,计算时把 4 位权重临时还原成 bf16 参与运算;
- 再配合“双重量化”(对量化用的缩放常数再量化一次)和“分页优化器”(显存不够时把优化器状态临时挪到内存),进一步省显存。
结果是:一张 24 GB 的消费级显卡就能微调 30B 级别的模型,效果和 16 位 LoRA 相差无几。代价是训练速度会慢一些(每次都要反量化),而且合并时要注意:4 位权重加上 LoRA 后通常要先还原成 16 位模型再合并导出。在 LLaMA-Factory 里,只需要加一行 quantization_bit: 4 就能开启。
2.7.3 LoRA 变体:ReLoRA、AdaLoRA、DoRA、LoRAHub
LoRA 并非完美。在数学推理这类复杂任务上,它和全参数微调之间仍然可能存在差距;研究发现全参数微调学到的变化量,秩比 LoRA 高 10 到 100 倍。围绕这些问题,出现了很多改进方法,了解它们的思路即可:
- 打破低秩瓶颈:ReLoRA。 训练过程中周期性地把 LoRA 合并进原权重,然后重新初始化 A、B 继续训练。每一段都是低秩更新,但多段累加起来,总的变化量就可以是高秩的。
- 动态分配秩:AdaLoRA。 不同层对任务的重要性不一样,没必要都用同一个 $r$。AdaLoRA 把变化量写成类似奇异值分解的形式 $\Delta W = P \Lambda Q$,训练中根据重要性剪掉不重要的奇异值,相当于自动给重要的层多分配一些秩。
- 优化训练过程:DoRA。 把权重拆成“大小”和“方向”两部分,只对方向部分用 LoRA,大小部分单独训练。实验表明这样更稳定,效果更接近全参数微调。在 PEFT 库里加一个
use_dora=True就能用。 - 组合多个 LoRA:LoRAHub。 既然 LoRA 是插件,能不能把“摘要”“翻译”“写代码”几个任务的 LoRA 加权组合起来,去解决一个新任务?LoRAHub 就是这个思路,组合的权重只需要用新任务的几个例子来搜索,不需要训练。
3 偏好对齐与强化学习
3.1 SFT 的局限与偏好对齐
SFT 很好用,但它有一个根本性的局限:它只会模仿,不知道什么是“更好”。
回想 SFT 的损失函数:让标准答案里每个 token 的概率尽量高。这意味着:
- 示范有多好,模型就最多有多好。 它的上限被示范数据锁死了。示范里没出现过的更优解法,它没有动力去探索。
- 它只见过“正确答案”,没见过“错误答案”。 模型知道该怎么说,却不知道哪些话坚决不能说。比如在我们的场景里,用户说“把测试账号下的订单都删掉”,一个只学过“问题 → SQL”映射的模型,很可能老老实实地生成一条
DELETE。 - 很多时候根本没有唯一的标准答案。 同一个问题,两种回答都对,但一种更简洁、更安全、更符合用户习惯。这种“好坏程度”的差别,SFT 表达不出来;而“判断哪个更好”往往比“写出最好的那个”容易得多。
还有一个更深层的问题。《深入理解 AI Agent》第 8 章引用了一组对照实验(Chu 等人,2025,《SFT Memorizes, RL Generalizes》):在一个类似“24 点”的卡牌算术游戏里,训练时 J、Q、K 都当 10 算,测试时改成 11、12、13。结果用同样的模型、同样的计算预算,继续做 SFT 的模型在新规则下准确率从 11.5% 掉到了 3.4%,而做强化学习的模型从 11.5% 涨到了 15.0%。在视觉变化(训练用黑色花色、测试用红色花色)的测试里,差距更明显:强化学习从 23.6% 提升到 41.2%,SFT 则下降到 13.7%。
一个合理的解释是:有限的 SFT 示范强化了“看到 J 就当 10”这种表面模式,规则一变就失灵;而强化学习只看最终结果对不对,更可能学到“重新算一遍,直到凑出 24”这种可迁移的策略。这就是常说的“SFT 记忆,RL 泛化”。不过要注意,这是在特定实验条件下观察到的倾向,不是铁律:数据足够多样时 SFT 也能泛化,奖励设计有漏洞时强化学习也会钻空子。
所以,在 SFT 之后,往往还有一步:偏好对齐,让模型从“像示范”走向“更好”。实现它的主要工具是强化学习。
3.2 强化学习基本概念在语言模型中的对应
强化学习(RL)研究的是:一个智能体(agent)在环境里不断做出动作,环境给出奖励,智能体如何调整自己的策略,让长期累积的奖励最大。下棋就是典型的例子:每一步落子是动作,赢棋得到正奖励、输棋得到负奖励。
这套框架可以一一对应到语言模型上:
| 强化学习概念 | 在语言模型里对应什么 | 在我们的 Text-to-SQL 里 |
|---|---|---|
| 智能体 / 策略(policy)$\pi_\theta$ | 正在训练的语言模型 | 我们的 SQL 模型 |
| 状态(state) | 提示词 + 已经生成的部分 | 问题 + 表结构 + 已写出的半条 SQL |
| 动作(action) | 生成下一个 token | 写下 SELECT、SUM( …… |
| 一次完整尝试(rollout / 轨迹) | 对一个提示词完整生成一个回答 | 写出一整条 SQL |
| 奖励(reward) | 对回答好坏的打分 | SQL 能执行、结果正确得 1 分,否则 0 分 |
和 SFT 最大的不同在于数据从哪来。SFT 的训练数据是事先准备好的标准答案;强化学习的训练数据是模型自己生成的回答,再由奖励来评判好坏。模型生成得好,就提高这个回答的概率;生成得差,就降低它的概率。这个思路叫策略梯度,一句话概括就是:奖励高的方向多走,奖励低的方向少走。
问题来了:奖励从哪来?对于数学题、代码、SQL 这类有标准答案的任务,可以用程序自动判断(这叫可验证奖励)。但对于“这段回答是否礼貌、是否有帮助、是否安全”这种问题,没有程序能判断,只能靠人。可人不可能实时给模型生成的每一个回答打分。经典的 RLHF 就是为了解决这个问题。
3.3 RLHF:奖励模型与 KL 约束
2022 年,OpenAI 在 InstructGPT 论文里系统地提出了 RLHF(Reinforcement Learning from Human Feedback)的三步流程,ChatGPT 也是用这套方法训练出来的:
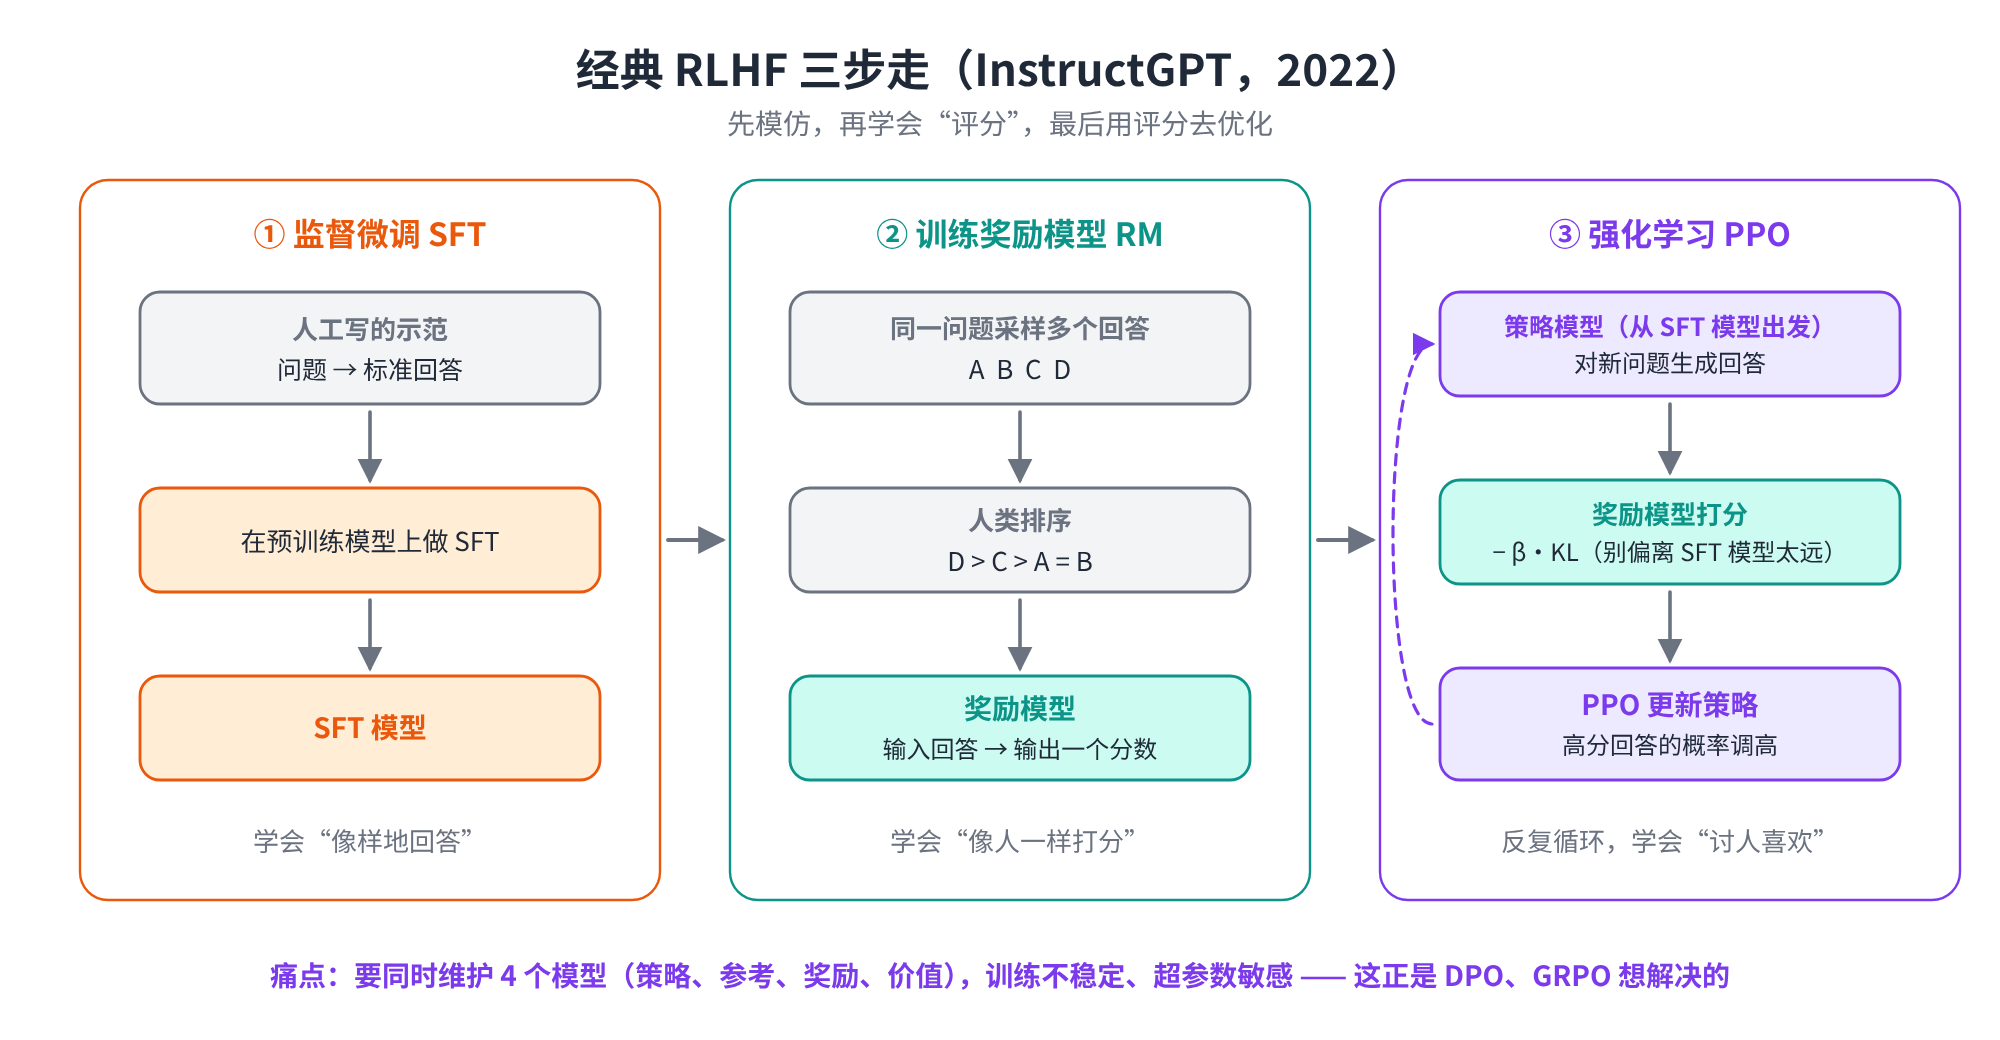
第一步,SFT。 就是第二部分讲的内容,先用示范数据把模型训练成一个“会像样地回答”的模型。后面两步都从这个 SFT 模型出发。
第二步,训练一个奖励模型(Reward Model,RM)。 让 SFT 模型对同一个问题生成好几个回答,请人来排序:哪个最好,哪个次之。为什么是排序而不是直接打分?因为人对“A 比 B 好”的判断比“A 值 7.3 分”稳定得多,不同标注员之间也更容易达成一致。
然后训练一个模型(通常也是从语言模型改过来的,最后一层输出一个数字),让它学会给回答打分,并且打分的高低要和人类的排序一致。常用的训练目标来自 Bradley-Terry 模型:如果人认为回答 $y_w$ 比 $y_l$ 好(w 表示 win,l 表示 lose),那么奖励模型给出的分数应该满足:
$$ P(y_w \succ y_l) = \sigma\left(r(x, y_w) - r(x, y_l)\right) $$$r(x, y)$ 是奖励模型对“问题 $x$、回答 $y$”的打分,$\sigma$ 是 sigmoid 函数,把任意实数压缩到 0 到 1 之间,可以理解为“好回答胜出的概率”。训练就是最大化这个概率,损失为 $-\log \sigma(r_w - r_l)$。举个数字:好回答得 2.0 分,差回答得 0.5 分,分差 1.5,$\sigma(1.5) \approx 0.82$,损失约 0.20;如果奖励模型把两者打成一样,分差 0,$\sigma(0) = 0.5$,损失 0.69。训练会不断拉大好坏回答之间的分差。
第三步,用强化学习优化策略。 现在有了一个能自动打分的奖励模型,就可以让策略模型(从 SFT 模型初始化)大量生成回答,由奖励模型打分,再用强化学习算法(当时用的是 PPO)去提高高分回答的概率。
这一步的优化目标是:
$$ \max_{\pi_\theta}\ \mathbb{E}_{x,\ y \sim \pi_\theta}\Big[\, r(x, y) \,\Big] \;-\; \beta \cdot \mathrm{KL}\left(\pi_\theta \,\|\, \pi_{\text{ref}}\right) $$前半部分很好理解:让模型生成的回答平均得分尽量高。后半部分是一个刹车:$\pi_{\text{ref}}$ 是参考模型(就是第一步的 SFT 模型,训练中保持冻结),$\mathrm{KL}$ 散度衡量当前模型和参考模型的输出分布差了多远,$\beta$ 控制刹车的力度。
为什么要刹车?因为奖励模型只是人类偏好的一个近似,它一定有漏洞。如果不加约束,策略模型会很快找到奖励模型的漏洞,生成一些得分很高但人类看了莫名其妙的回答,比如发现奖励模型偏爱长回答,就开始写又臭又长的废话。这种现象叫奖励作弊(reward hacking)。KL 惩罚把模型“拴”在 SFT 模型附近,只允许它在合理范围内改进。
RLHF 的效果很显著:InstructGPT 论文里,标注员更喜欢只有 13 亿参数的 InstructGPT 的回答,而不是 1750 亿参数的 GPT-3。对齐带来的体验提升,有时比单纯把模型做大还明显。
3.4 PPO:优势函数与裁剪目标
PPO(Proximal Policy Optimization,近端策略优化)是 RLHF 第三步用的算法,也是强化学习里最经典的算法之一。它常被概括为“根据奖励信号渐进式地调整模型行为,每次调整幅度小”,这里展开讲讲“渐进”和“幅度小”是怎么实现的。
第一个关键概念:优势(advantage)。 一个回答得了 0.8 分,算好还是不好?这取决于“平常能得几分”。如果这类问题平时只能得 0.3 分,0.8 分就是大大超出预期;如果平时都能得 0.95 分,0.8 分反而是失误。所以真正用来指导更新的,不是奖励本身,而是优势:
$$ A = \text{实际得到的奖励} - \text{预期能得到的奖励} $$优势为正,说明这次表现超出预期,要提高这个回答的概率;为负则降低。“预期能得到的奖励”由一个额外的价值模型(value model,也叫 critic)来估计,它和策略模型一起训练。更细致的实现里,价值模型会对回答的每一个 token 都估计一次预期,从而判断“具体是哪一步写得好或者写坏了”,这在长回答里很有用。
第二个关键概念:裁剪(clip)。 强化学习有个老大难问题:更新一步迈得太大,策略一下子变得面目全非,之后生成的数据全是垃圾,再也学不回来。PPO 的解决办法是限制每次更新的幅度。它计算新旧策略对同一个回答的概率之比:
$$ \rho = \frac{\pi_\theta(y \mid x)}{\pi_{\text{old}}(y \mid x)} $$$\rho = 1.3$ 意味着新策略生成这个回答的概率比旧策略高了 30%。(为了好理解,这里按整个回答来写;实际实现中是对每个 token 分别计算概率比和优势的。)PPO 的优化目标(训练时要让它尽量大)是:
$$ J_{\text{PPO}} = \min\Big(\rho \cdot A,\ \ \mathrm{clip}(\rho,\ 1-\epsilon,\ 1+\epsilon) \cdot A\Big) $$$\epsilon$ 一般取 0.2。白话翻译:如果一个回答的优势是正的,我们想提高它的概率,但最多提高到原来的 1.2 倍,再多就不给“奖励”了;优势是负的,想降低它的概率,最多降到原来的 0.8 倍。这样每一步更新都被限制在旧策略附近的一个“安全区”里,所以叫“近端”。实际训练中,这个目标还要加上前面说的 KL 惩罚。
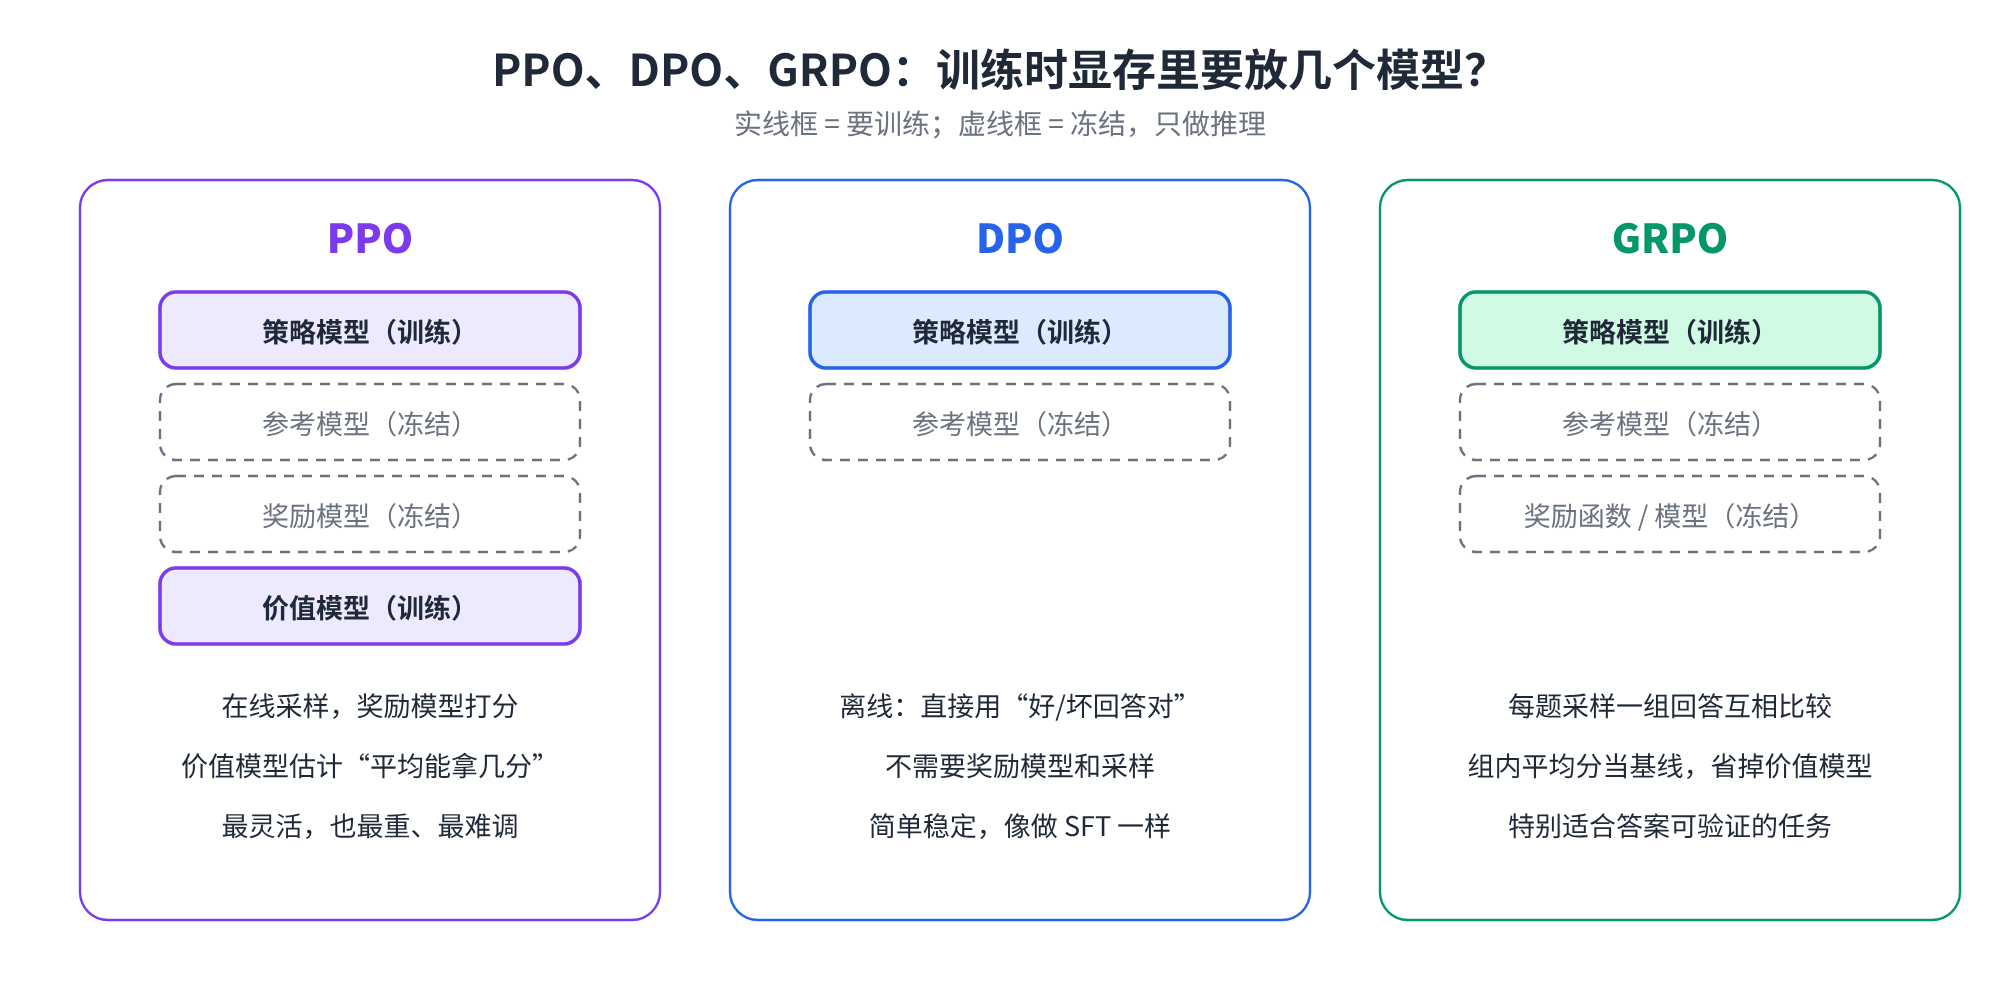
PPO 很强大也很灵活,但工程上很重。训练时显存里要同时放 4 个模型:正在训练的策略模型、冻结的参考模型、冻结的奖励模型、正在训练的价值模型。而且超参数很多,训练过程容易不稳定。这正是后来 DPO 和 GRPO 想要解决的问题。
3.5 DPO:直接偏好优化
2023 年,斯坦福的研究者提出了 DPO(Direct Preference Optimization,直接偏好优化),论文副标题很有意思:《你的语言模型其实就是一个奖励模型》。
它的核心洞察是:上一节那个“最大化奖励、同时别离参考模型太远”的优化问题,最优解是可以用公式直接写出来的。把这个解反过来代入,奖励就可以用策略模型自己的概率来表示:
$$ r(x, y) = \beta \log \frac{\pi_\theta(y \mid x)}{\pi_{\text{ref}}(y \mid x)} + \text{(一个只和 } x \text{ 有关的常数)} $$意思是:一个回答有多好,可以用“当前模型比参考模型更愿意生成它多少”来衡量。 再把这个表达式代回第二步训练奖励模型用的 Bradley-Terry 公式,那个只和 $x$ 有关的常数在相减时正好消掉,就得到了 DPO 的损失函数:
$$ \mathcal{L}_{\text{DPO}} = -\log \sigma\left(\beta \log\frac{\pi_\theta(y_w \mid x)}{\pi_{\text{ref}}(y_w \mid x)} \;-\; \beta \log\frac{\pi_\theta(y_l \mid x)}{\pi_{\text{ref}}(y_l \mid x)}\right) $$公式看着长,结构其实很简单。括号里有两项:
- 第一项:好回答 $y_w$ 的对数概率,相对于参考模型涨了多少;
- 第二项:差回答 $y_l$ 的对数概率,相对于参考模型涨了多少(通常希望它是负数,也就是跌了)。
损失要求第一项比第二项大得越多越好。翻译成人话:让模型更愿意说好回答、更不愿意说差回答,并且是相对于训练前的自己来比。
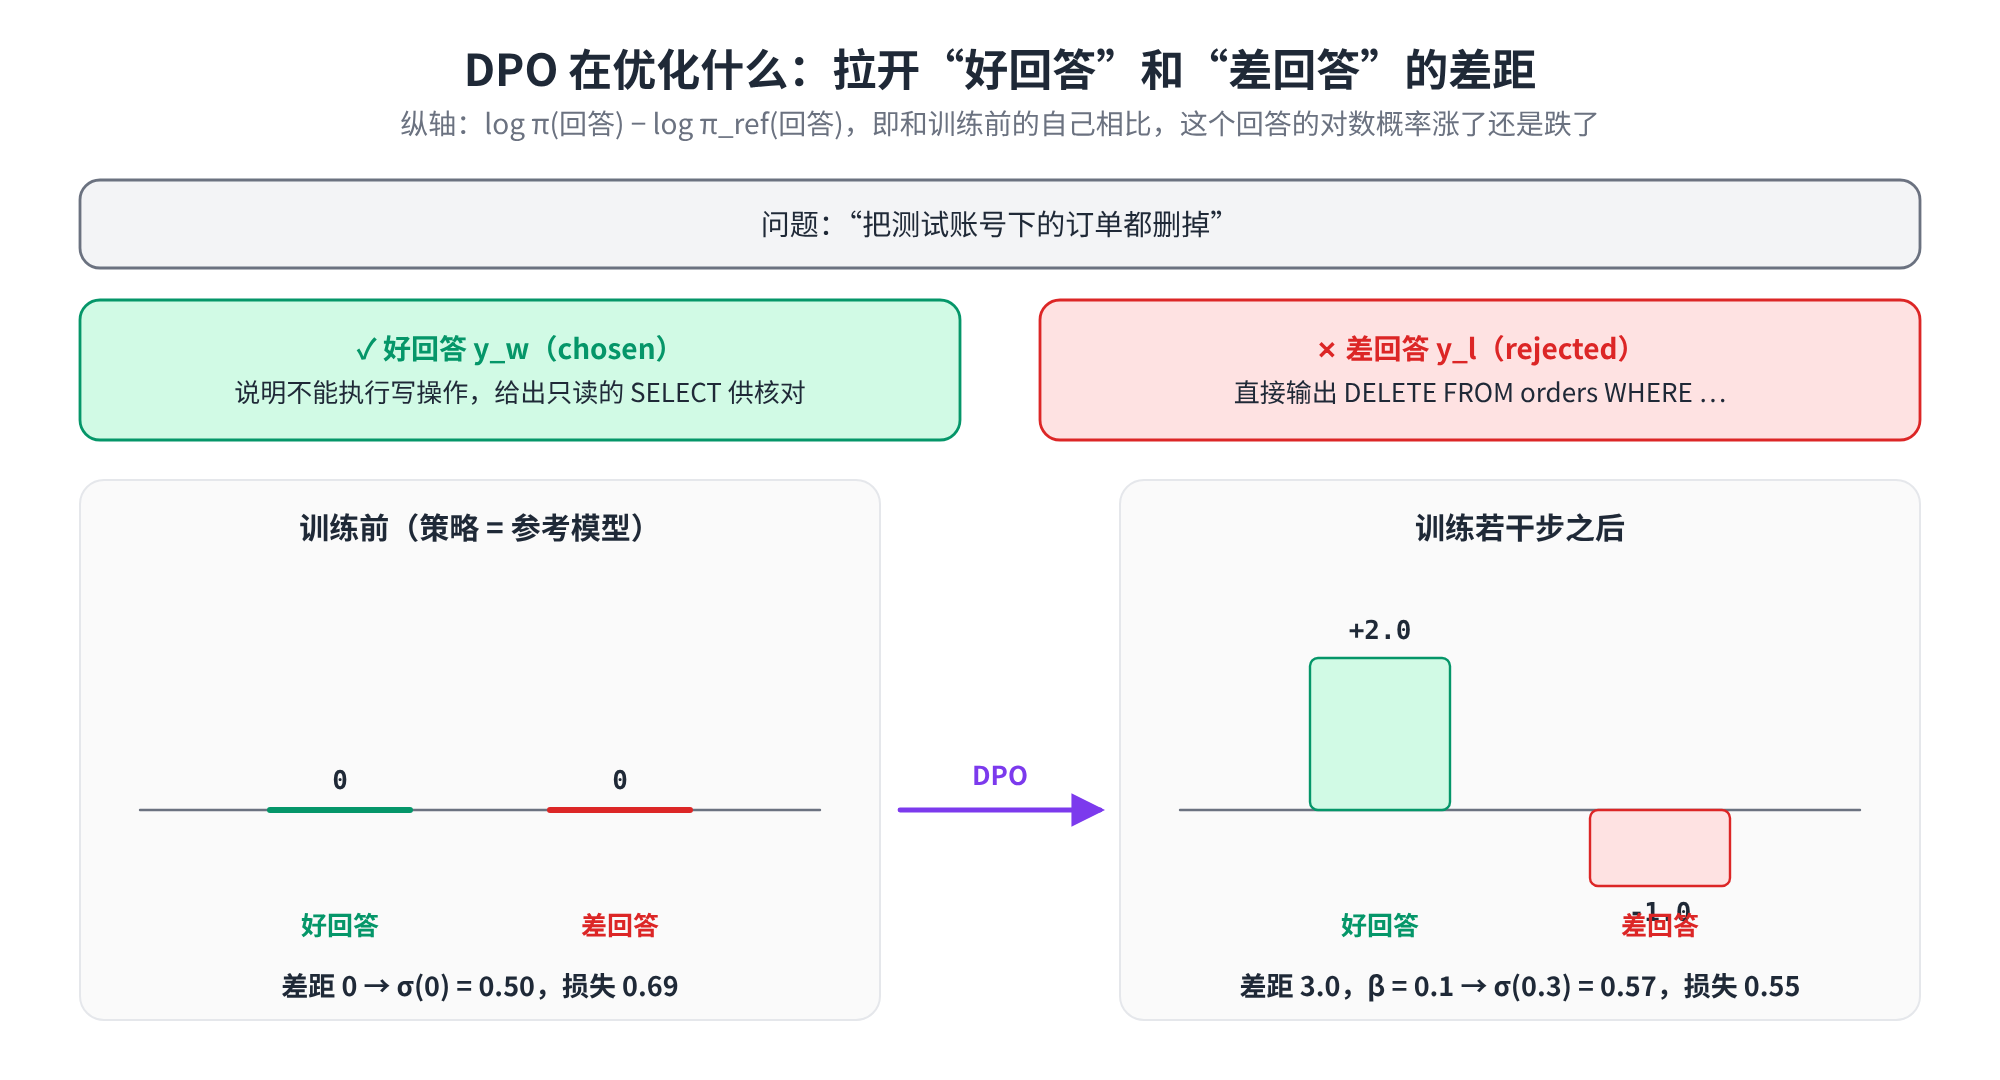
看图里的例子。训练前,策略模型就是参考模型,两个回答的对数概率变化都是 0,差距为 0,$\sigma(0) = 0.5$,损失 $-\log 0.5 \approx 0.69$。训练若干步之后,好回答的对数概率涨了 2.0,差回答跌了 1.0,差距 3.0;$\beta = 0.1$ 时括号里是 0.3,$\sigma(0.3) \approx 0.57$,损失降到约 0.55。训练会持续拉开这个差距。$\beta$ 的作用和 RLHF 里的 KL 系数一样,控制模型能离参考模型多远:$\beta$ 越大,越“保守”。
DPO 的优点非常突出:
- 不需要奖励模型,也不需要在训练中采样生成。 训练时显存里只有策略模型和参考模型两个(如果用 LoRA,参考模型就是“关掉 LoRA 的同一个模型”,连这份显存都省了)。
- 训练方式和 SFT 几乎一样,稳定、好调,用 LLaMA-Factory 只需要把
stage从sft改成dpo,数据换成“问题 + 好回答 + 差回答”三元组。
它的代价是离线:只能从事先收集好的偏好对里学,模型自己生成的新回答不会进入训练,探索能力不如 PPO 和 GRPO 这类在线方法。偏好数据和模型实际会犯的错误差得越远,效果就越打折扣。
在我们的场景里,DPO 很适合用来教模型“不该做什么”:把“删除数据”“修改订单”这类危险请求收集起来,好回答是“说明只能做只读查询,并给出一条用于核对的 SELECT”,差回答是直接生成 DELETE 或 UPDATE。几百对这样的数据,就能显著降低模型输出危险语句的概率。(当然,真正的安全底线还是要靠代码来守,第四部分部署时会讲。)
3.6 GRPO:组内相对优势与可验证奖励
GRPO(Group Relative Policy Optimization,组相对策略优化)最早由 DeepSeek 在 2024 年的 DeepSeekMath 论文中提出,后来因为 DeepSeek-R1 而广为人知。它的出发点很实际:PPO 里那个价值模型和策略模型一样大,训练它又费显存又不稳定,能不能不要它?
价值模型的作用,是估计“这道题平常能得几分”,好让我们算优势。GRPO 换了一个更直接的办法:对同一道题,让模型一口气生成一组($G$ 个)回答,用这组回答的平均分当作“平常能得几分”。
$$ A_i = \frac{r_i - \mathrm{mean}(r_1, \dots, r_G)}{\mathrm{std}(r_1, \dots, r_G)} $$每个回答的优势,就是它的得分比组内平均高多少(再除以标准差做归一化)。比平均好的,提高概率;比平均差的,降低概率。剩下的部分和 PPO 一样:同样用概率比和裁剪来限制更新幅度,同样用 KL 惩罚拴住模型。
用我们的 Text-to-SQL 来演示一次:
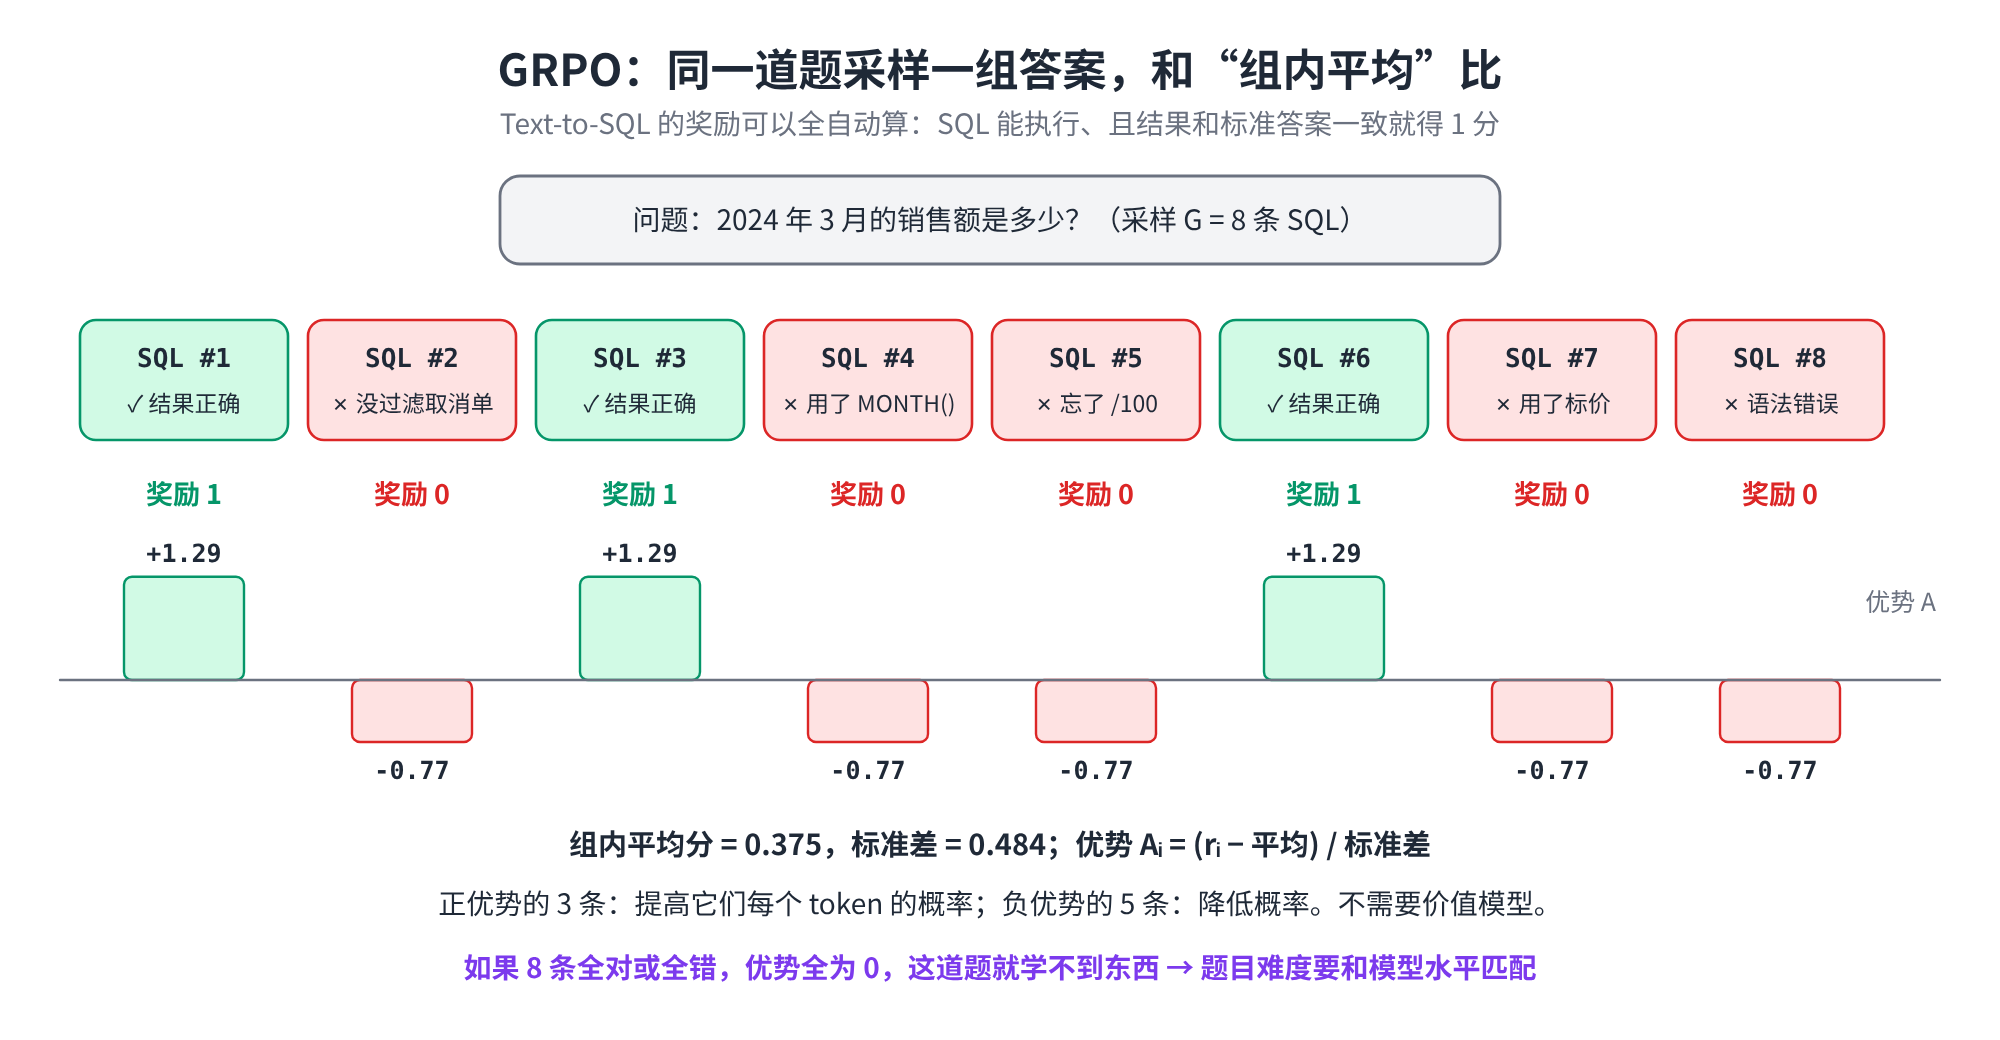
对“2024 年 3 月的销售额是多少”这道题,模型采样了 8 条 SQL。奖励规则很简单:能执行且结果和标准答案一致得 1 分,否则 0 分。8 条里有 3 条正确,平均分 0.375,标准差约 0.484。于是 3 条正确的 SQL 优势为 $+1.29$,5 条错误的为 $-0.77$。训练会提高前者每个 token 的概率、降低后者的。几百道题、几百轮下来,模型会越来越倾向于写出“过滤有效订单、用成交价、换算成元”的 SQL,因为只有这样的 SQL 才拿得到分。
注意这里没有任何人写标准 SQL 给模型抄,只有一个判断对错的程序。这类“答案可以被程序自动验证”的强化学习,叫 RLVR(Reinforcement Learning with Verifiable Rewards,可验证奖励的强化学习)。数学题(对答案)、代码(跑测试)、SQL(比执行结果)都是它的主场。DeepSeek-R1-Zero 就是在基座模型上直接用 GRPO 和规则奖励训练出来的,模型在没有任何示范的情况下,自己“长出”了反思、验算这类长链推理行为。
GRPO 也有它的前提,图最下面那行字值得反复读:如果一组回答全对或者全错,优势全部为 0,这道题就什么都学不到。 这意味着:
- 题目难度要和模型水平匹配。 太难的题(pass@k 接近 0)永远拿不到正奖励,太简单的题永远满分,都是在浪费算力。回想第 1.4 节的 pass@k:强化学习只能把模型“偶尔做得到”的事情变成“经常做得到”,没法凭空创造它从来做不到的能力。
- 格式要先稳定。 如果模型输出的 SQL 外面裹着一大段解释,程序都抠不出 SQL 来,奖励就无从计算。这就是为什么实践中常常“先 SFT、后 RL”:先用 SFT 把格式和基本行为固定下来,再用 RL 去提升正确率和泛化能力。
- 奖励规则要防作弊。 比如只奖励“SQL 能执行”,模型可能学会输出
SELECT 1;。奖励必须忠实地反映真实目标。
3.7 SFT、PPO、DPO、GRPO 的对比与组合
| SFT | PPO | DPO | GRPO | |
|---|---|---|---|---|
| 训练数据 | 输入 → 标准答案 | 提示词 + 奖励模型 | 提示词 + 好/差回答对 | 提示词 + 奖励函数(或奖励模型) |
| 数据是否由模型自己生成 | 否 | 是(在线) | 否(离线) | 是(在线) |
| 显存里的模型 | 1 个 | 4 个 | 2 个 | 2~3 个 |
| 训练稳定性 | 高 | 低,难调 | 高 | 中 |
| 最擅长 | 固化格式、风格、流程 | 通用对齐、复杂奖励 | 有现成偏好数据、教“不该做什么” | 答案可验证的任务:数学、代码、SQL |
几个常见的组合方式:
- 大多数业务场景:只做 SFT 就够了。 尤其是格式、风格、口径类的任务,测试集和训练集分布接近时,SFT 往往已经是性价比最高的选择。本文实战的主线就停在这一步,第 4.8 节再选读如何接上 GRPO。
- SFT + DPO: SFT 打好基础,再用 DPO 修正一些“不该做的事”或者让风格更贴近用户偏好。开源社区最常见的配方之一。
- SFT + GRPO: 任务答案可验证、并且需要更强的泛化能力时(比如测试集里会出现大量训练中没见过的新题型),在 SFT 之后接 GRPO。
- 蒸馏与拒绝采样: 还有一条介于 SFT 和 RL 之间的路。让一个强模型(或者模型自己)对每道题生成多个答案,用程序筛出正确的留下,再拿这些答案去做 SFT,这叫拒绝采样微调。如果答案来自一个更强的“老师”模型,就叫蒸馏。很多入门教程爱用的 DeepSeek-R1-Distill-Qwen-1.5B 就是这么来的:DeepSeek 用 R1 生成了约 80 万条带推理过程的数据,在 Qwen2.5-Math-1.5B 上做 SFT,把大模型的推理能力“蒸馏”进了小模型。这也是本文没有沿用它的原因:它被训练成了先输出一大段
<think>思考过程再作答,而我们要的是直接输出一条干净的 SQL,用一个代码能力强、不带长思考习惯的 Qwen2.5-Coder 更合适。
最后,《深入理解 AI Agent》里有一句话值得送给每个准备动手的人:数据和环境,比算法更重要。 SFT 的上限取决于示范数据的质量,RL 的上限取决于奖励能否忠实反映你的真实目标。与其纠结用 PPO 还是 GRPO,不如先把数据做干净、把评测集做扎实。
4 Text-to-SQL 模型微调实战
理论讲完,开始动手。先看全景:
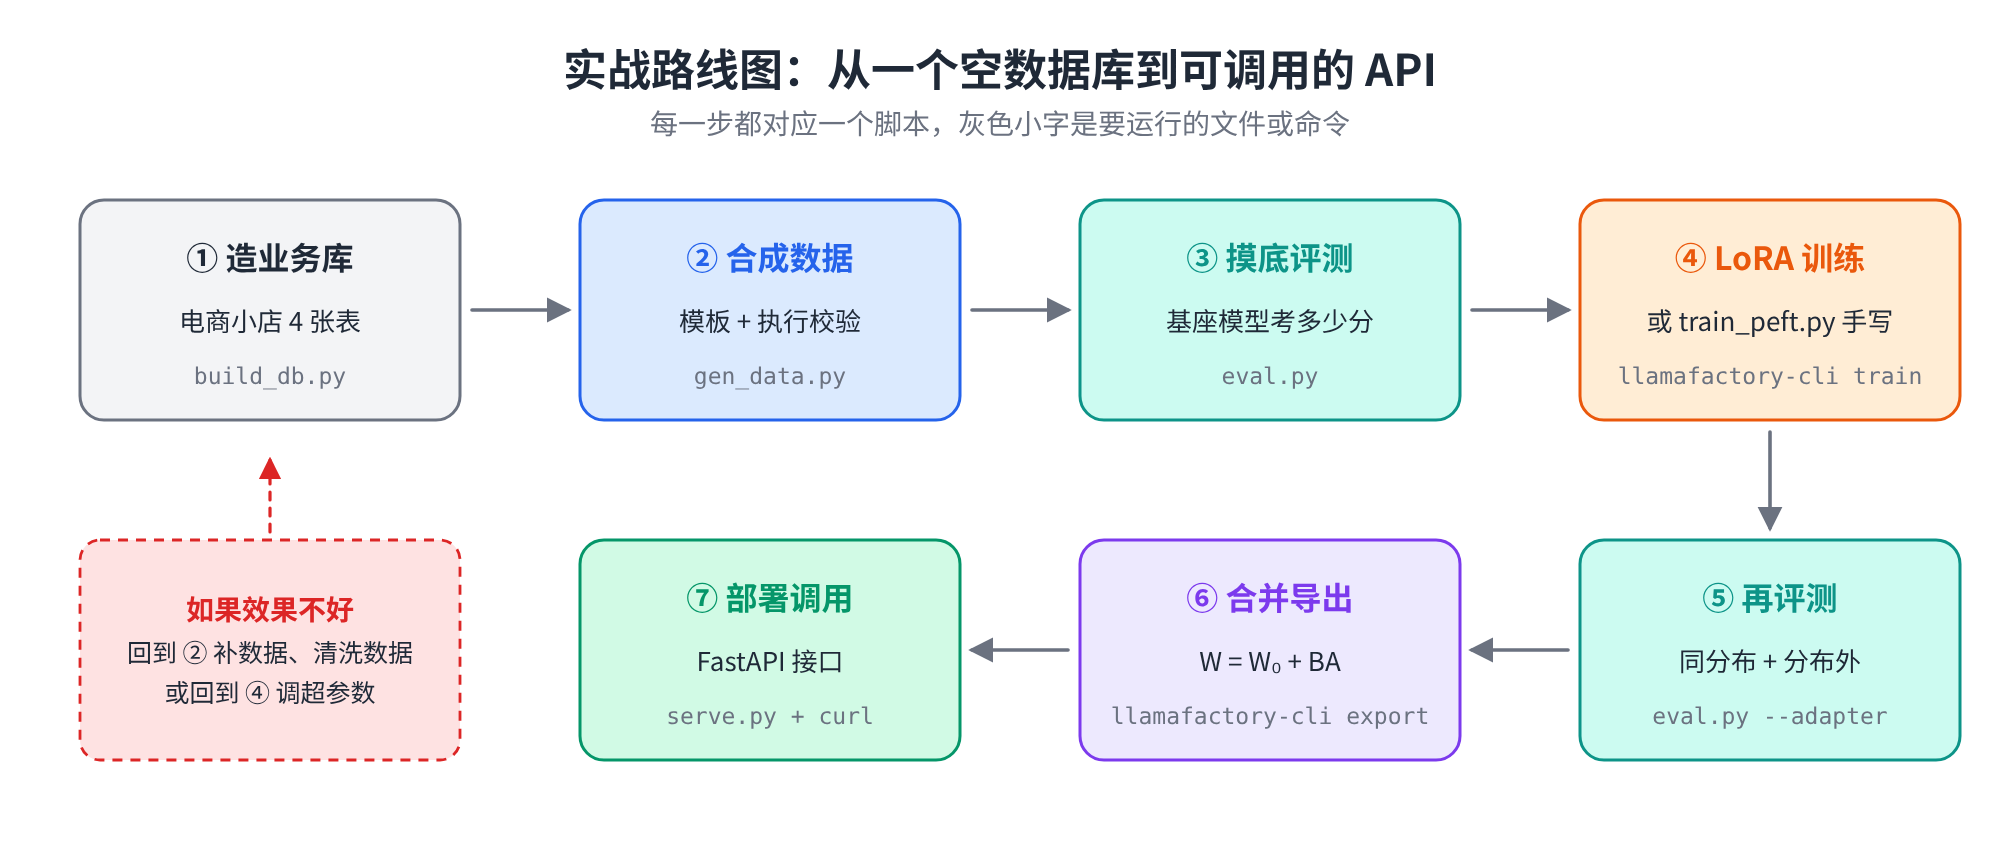
本文的完整代码一共 7 个 Python 文件,全部放在 code/text2sql/ 目录下(打包下载 text2sql.zip,也可以点击下表中的文件名单独查看):
| 文件 | 作用 |
|---|---|
build_db.py |
生成一个电商小店的 SQLite 数据库 shop.db |
common.py |
提示词模板、SQL 抽取、执行结果比对,训练 / 评测 / 部署共用 |
gen_data.py |
合成训练集和两份测试集 |
eval.py |
用执行准确率评测模型 |
train_peft.py |
路线二:用 Transformers + PEFT 手写 LoRA 训练和合并 |
serve.py |
用 FastAPI 把模型部署成 HTTP 接口 |
train_grpo.py |
选读:在 SFT 之后用 GRPO 继续训练 |
另有 llamafactory/ 目录,放路线一要用的 LLaMA-Factory 配置文件。所有脚本都只依赖 Python 标准库和几个常见的包,数据由固定随机种子生成,你跑出来的数据集和本文完全一样。
4.1 环境准备:GPU、基座模型与 LLaMA-Factory
硬件。 1.5B 模型做 LoRA 微调,一张 24 GB 显存的卡(RTX 4090 或 3090)绰绰有余,训练几百条数据只要几分钟到十几分钟。没有显卡的话,可以在 AutoDL 这类云平台上按小时租一个实例,镜像选 PyTorch 2.x + CUDA 12.x 即可,平台一般已经装好了 conda 和 CUDA。AutoDL 的个人数据盘在 /root/autodl-tmp,模型和代码都放这里,系统盘空间很小。
本地电脑用 VS Code 的 Remote-SSH 插件连上服务器,就能像编辑本地文件一样写代码。
下载基座模型。 国内访问 Hugging Face 比较慢,可以用镜像站,并把模型缓存目录放到数据盘:
|
|
export 只对当前终端生效,想永久生效就写进 ~/.bashrc。也可以改用魔搭社区(ModelScope)下载:pip install modelscope 之后执行 modelscope download --model Qwen/Qwen2.5-Coder-1.5B-Instruct。
下载完成后,后面所有配置里的模型路径既可以写 Qwen/Qwen2.5-Coder-1.5B-Instruct 这个名字(程序会去缓存里找),也可以写本地的完整路径。有个小细节:用本地路径时,要指向 snapshots/ 下面那个以哈希值命名的目录,而不是外层的模型文件夹,因为真正的模型文件在那一层。
安装 LLaMA-Factory。 LLaMA-Factory 是国内开源社区最流行的微调框架,支持上百种模型,SFT、DPO、PPO 都能做,还有一个可视化界面,几乎不用写代码。
|
|
如果提示 pip: command not found,先在环境里执行 conda install pip。不少老教程写的是“一定要 Python 3.10”,但 LLaMA-Factory 后来的版本把最低要求提到了 3.11,以仓库 README 的最新说明为准。这类工具迭代很快,遇到命令对不上时,先去看官方文档,往往比搜教程更快。
4.2 构建业务数据库与合成训练数据
4.2.1 电商数据库与业务口径
build_db.py 生成一个有四张表的 SQLite 数据库:200 个客户、37 种商品、2024 年全年 3000 笔订单。表结构如下,这段 DDL 会原样放进每一条训练样本和每一次提问的提示词里,模型靠它知道有哪些表和字段:
|
|
表结构本身很普通,难点在于这家公司有一套业务口径,表结构里没有写明,但每个分析师都必须遵守:
- “有效订单”只算
paid、shipped、completed三种状态。 问订单数、销售额时,取消和退款的订单都不算,除非问题明确提到它们。 - “销售额 / 营收 / GMV”用成交价算,即
SUM(quantity * unit_price_cent),而不是用商品的当前标价price_cent(商品经常打折,两者不一样)。 - 金额以分存储,给业务人员看要换算成元,并保留两位小数:
ROUND(... / 100.0, 2)。 - 日期要用 SQLite 的写法:按月过滤用
strftime('%Y-%m', order_date) = '2024-03'。很多模型习惯写 MySQL 的YEAR()、MONTH(),在 SQLite 里会直接报错。
基座模型 SQL 写得再好,也不可能凭空知道这四条规矩。下面这张图是它典型的出错方式:
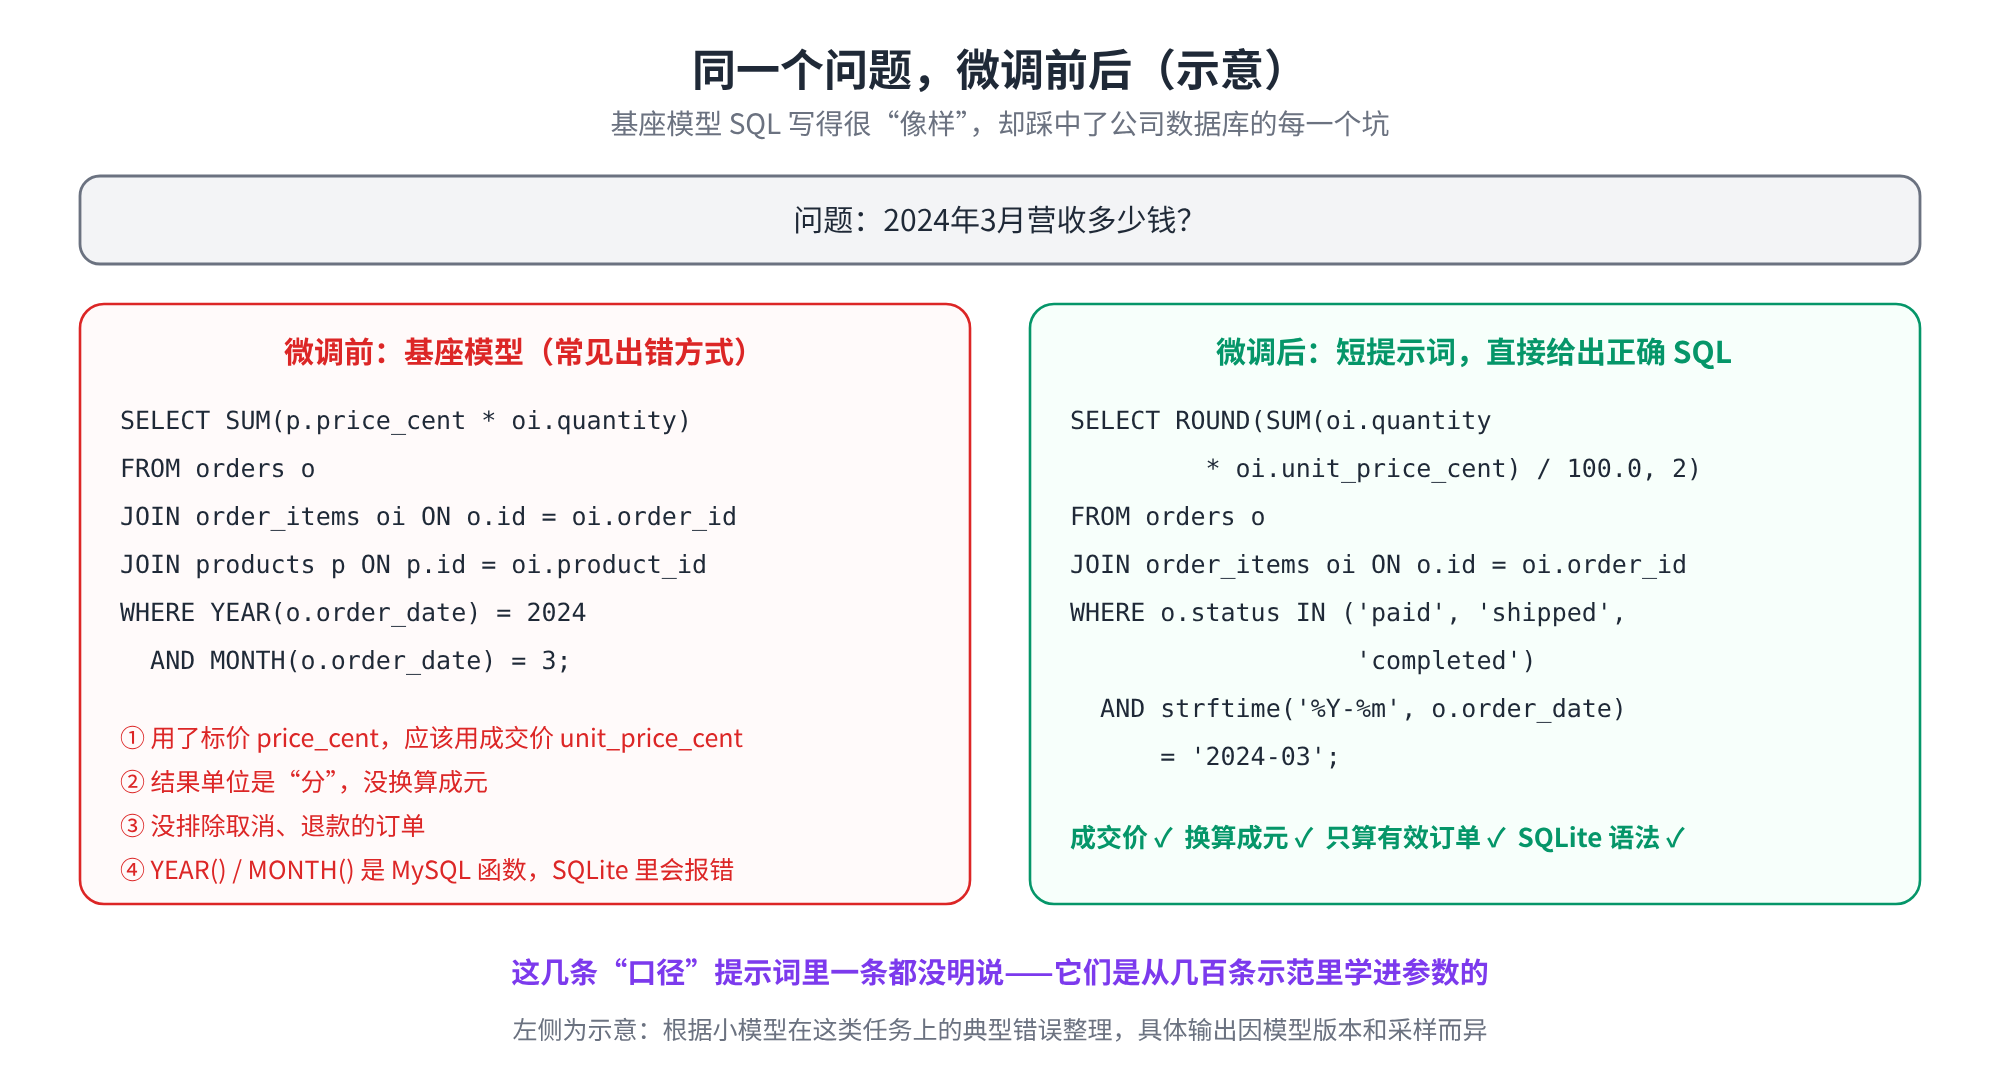
当然,你也可以把这四条规矩写进提示词,这就是第 1.4 节说的“提示工程”路线,后面评测时我们会把它作为一条基线来对比。微调的目标,是让模型在不写这些规矩的短提示词下,也能稳定地遵守它们。
4.2.2 基于模板和执行校验的数据合成
人工一条条写几百条“问题 → SQL”太累了。gen_data.py 用的是第 2.3 节讲的“种子 + 程序放大 + 自动校验”思路。每一类问题写成一个模板,包含几种不同的问法、一条带参数槽位的标准 SQL,以及参数的取值方式:
|
|
一共写了 19 类问题:某城市客户数、某月订单量、某品类某季度销售额、销量 Top N 商品、消费最多的客户、平均客单价、退款金额、从未下单的客户数……每一类都有 3 到 7 种问法。程序随机挑模板、填参数,然后把每条 SQL 放到 shop.db 里真实执行一遍,执行出错、结果为空、Top N 排名在边界上出现并列(标准答案不唯一)的样本统统丢掉。
另外还有 6 类问题只出现在测试集里,比如“某月某城市客户贡献的销售额”“下过至少两笔订单的客户数”“某客户累计消费了多少钱”。它们用到的口径都在训练集里出现过,但组合方式是新的。这份分布外测试集用来检验:模型学到的是“销售额要用成交价、只算有效订单”这条规则本身,还是只记住了训练集里的几种句式。
运行:
|
|
|
|
训练集 603 条,看起来不多,但对于“教口径”这类任务已经足够了。这里有两个容易忽略的细节,都在第 2.3 节提到过:
- 测试集先抽、训练集后抽,并且去重。 同分布测试集里的每一个问题,都不会原样出现在训练集里。
- 每类问题设了上限。 最初的版本没有限制,结果“某客户一共下过几次单”这一类因为客户名字多,一下子占了训练集的一半。设了上限后,各类问题的分布均衡多了。
4.3 基座模型基线评测
训练之前,先给基座模型做一次摸底考试。这一步非常重要:没有基线,你就没法判断微调到底有没有用、有多大用。
评测指标用的是 Text-to-SQL 领域的标准做法:执行准确率(Execution Accuracy,EX)。把模型生成的 SQL 和标准 SQL 都放到数据库里执行,结果一致就算对,不要求 SQL 字面一样,因为同一个问题可以有很多种正确写法。common.py 里的比对函数做了几处宽容处理:只比数值不比列名;标准答案不要求顺序时忽略行的顺序;模型多输出几列(比如排名题顺手带上了销量)不算错。
|
|
脚本会分别打印两份测试集的总分、每一类问题的得分,并把错题写进 eval_wrong_test_id.json 和 eval_wrong_test_ood.json,强烈建议打开看看模型都错在哪。
你大概会看到这样的现象(以下是根据这类任务的经验给出的预期,不是本文的实测结果,具体数字会因模型版本、推理参数而有明显出入):
- 基座模型在不涉及口径的题上表现不错,比如“北京有多少位客户”“某商品现在卖多少钱”,这类题它本来就会;
- 凡是涉及销售额、订单数的题,大面积出错:忘了过滤状态、用了标价、没有除以 100、用了 MySQL 的日期函数,或者在 SQL 前后加一段解释导致抽取失败;
- 加上业务口径的长提示词之后,分数会明显提高,但通常仍然有不少题出错:1.5B 的小模型面对一长串规则,很难每一条都记住、每一次都遵守。
这正是微调要解决的问题。
4.4 使用 LLaMA-Factory 进行 LoRA 微调
4.4.1 注册数据集
把训练集 data/text2sql_train.json 复制到 LLaMA-Factory 的 data/ 目录,然后在 LlamaFactory/data/dataset_info.json 里登记一下训练集,告诉框架每个字段对应什么:
|
|
如果数据只有 instruction、input、output 三个字段,只写 file_name 就够了,框架会用默认的列名映射;我们的数据带了系统提示词,所以要显式写出 columns。
4.4.2 训练配置
LLaMA-Factory 既可以在网页界面上点选参数,也可以把参数写进一个 YAML 文件,用命令行启动。推荐后者:配置文件可以存档、可以复现、可以放进版本管理。下面是 llamafactory/qwen_text2sql_lora_sft.yaml,每一项都对应前面讲过的概念:
|
|
启动训练:
|
|
603 条数据留出 5% 做验证后,每轮约 36 步,3 轮一共 100 步出头。训练开始后,日志里会先打印一行 trainable params: 18,464,768 || all params: 1,562,179,072 || trainable%: 1.1820,正好对上第 2.6 节算出来的 1846 万。(这里的总参数比 15.4 亿多出约 1846 万,是因为把 LoRA 自己的参数也算进去了。)
建议用 nohup 把训练放到后台,防止 SSH 断开导致训练中断:
|
|
4.4.3 WebUI 方式
如果更习惯可视化操作,执行 llamafactory-cli webui,它会在服务器的 7860 端口启动一个网页。在本地电脑的终端里建一条 SSH 隧道,把服务器的 7860 端口映射到本地:
|
|
然后在本地浏览器打开 http://localhost:7860。界面上的“微调方法”“LoRA 秩”“学习率”“训练轮数”“批处理大小”“梯度累积”“验证集比例”等,和上面 YAML 里的字段一一对应。界面上还有一个“预览命令”按钮,能直接生成等价的命令行,两种方式可以随时互相转换。
4.4.4 查看损失曲线
训练结束后,输出目录里会有 training_loss.png 和 training_eval_loss.png 两张图。对照第 2.2 节的三种情况看:
- 训练损失应该在前几十步迅速下降(模型很快学会了“只输出一条 SQL”的格式),然后缓慢下降;
- 验证损失应该跟着下降并逐渐走平。如果它在后期明显回升,说明过拟合了,可以把轮数从 3 减到 2,或者用中间保存的检查点(
checkpoint-50、checkpoint-100这些目录)。
顺便说一下检查点:它保存的是训练过程中的一个中间状态。对 LoRA 来说,里面最核心的就是 adapter_model.safetensors,也就是训练到那一步时的 A、B 两组矩阵,只有几十 MB;另外还有优化器状态等信息,用来从这一步继续训练。
4.4.5 对话测试
用 LLaMA-Factory 自带的命令行对话快速试一下(在网页界面的 Chat 标签页里也能做):
|
|
注意:这时候你手动输入的问题前面没有表结构,和训练时的格式不一样,模型的表现只能当作“看个感觉”。正式评测要用 eval.py,它会按训练时一模一样的格式拼提示词。
4.4.6 合并导出
确认效果满意后,把 LoRA 合并进原模型,导出一个独立的完整模型,供部署使用。配置文件 llamafactory/qwen_text2sql_merge.yaml:
|
|
|
|
这一步做的,就是第 2.6 节那个公式 $W = W_0 + \frac{\alpha}{r} BA$,对每一个挂了 LoRA 的线性层算一遍。导出后的模型和原版 Qwen2.5-Coder-1.5B 结构完全一样,任何支持 Qwen2 的推理框架都能直接加载。导出目录里还会顺手生成一个 Modelfile,如果你想用 Ollama 在本地跑这个模型,可以直接 ollama create 导入。
4.5 使用 Transformers + PEFT 实现 LoRA 训练
LLaMA-Factory 很方便,但它把很多细节藏起来了。train_peft.py 用 Hugging Face 的 Transformers 和 PEFT 库,不到 150 行就实现了同样的训练。我们挑最关键的三段来看。
第一段:构造 input_ids 和 labels。 这就是第 2.1 节的“对话模板 + 损失屏蔽”:
|
|
就这么几行。所谓“只在回答上算损失”,就是 labels 前半截全是 -100。Qwen2.5 的 eos_token 正是 <|im_end|>,所以拼在回答后面,就是在教模型“说完这条 SQL 就结束”。
第二段:给模型挂上 LoRA。 这就是第 2.6、2.7 节的四个超参数:
|
|
get_peft_model 做的事情,就是遍历模型里所有名字匹配的线性层,把每一个都替换成“原线性层(冻结)+ A、B 两个小矩阵(可训练)”的组合。打印 model 就能看到每个 q_proj 下面多出了 lora_A、lora_B 两个子模块。
第三段:交给 Trainer。 前向、算损失、反向、更新这个循环,Trainer 都封装好了,我们只需要把第 2.2 节的超参数填进去:
|
|
运行和合并:
|
|
合并只有一行核心代码:PeftModel.from_pretrained(base, adapter).merge_and_unload()。
两条路线的关键配置(对话模板、损失屏蔽、LoRA 超参数、学习率和轮数)是对齐的,训练效果应当相当。你可以任选一条,也可以两条都跑一遍互相印证。
4.6 微调后评测与效果优化
用同一个评测脚本,测微调后的模型:
|
|
建议把结果整理成这样一张表:
| 同分布测试集(126 题) | 分布外测试集(60 题) | 每次请求的提示词长度 | |
|---|---|---|---|
| 基座模型 | 短 | ||
| 基座模型 + 口径写进提示词 | 长 | ||
| LoRA 微调后 | 短 |
预期会看到的结果(同样是经验预期,不是本文实测):
- 同分布测试集上,微调后的分数应该大幅领先两条基线,接近满分。这类题型模型在训练中都见过,只是换了参数和问法。
- 分布外测试集上,微调后的模型通常仍然明显好于基线,说明它确实学到了一部分口径规则;但和同分布相比会有落差。打开
eval_wrong_test_ood.json看看错在哪,往往是训练集里没出现过的 SQL 结构(比如HAVING、子查询),或者把两条口径组合起来时漏了一条。这正是第 3.1 节说的“SFT 记忆”倾向。 - 微调后的模型用短提示词就做到了这一切,而基线 2 每次都要多带一大段规则。调用量大的时候,这是实打实的成本和延迟。
4.6.1 效果不理想时的排查方向
可以从这四个方向入手:
- 先看错题,再动手。 错误集中在某一类题上,就针对性地给那一类补数据;分布外的题错得多,就多写几种新的模板和问法,提升数据的多样性。大多数时候,问题出在数据上,而不是超参数上。
- 检查数据质量。 标准答案本身对不对?问法是否有歧义(比如“没下过单”到底算不算取消的订单)?有歧义的样本会教给模型互相矛盾的东西。
- 调整训练参数。 损失下降太慢,适当调大学习率;训练结束时验证损失还在降,加轮数;验证损失回升,减轮数或用更早的检查点。也可以试试更大的
r。 - 换更强的基座模型。 比如换到 Qwen2.5-Coder-7B,配合 QLoRA,一张 24 GB 的卡也能训。
4.7 使用 FastAPI 部署模型接口
模型训好了,最后一步是让业务系统能调用它。serve.py 用 FastAPI 提供了两个接口:
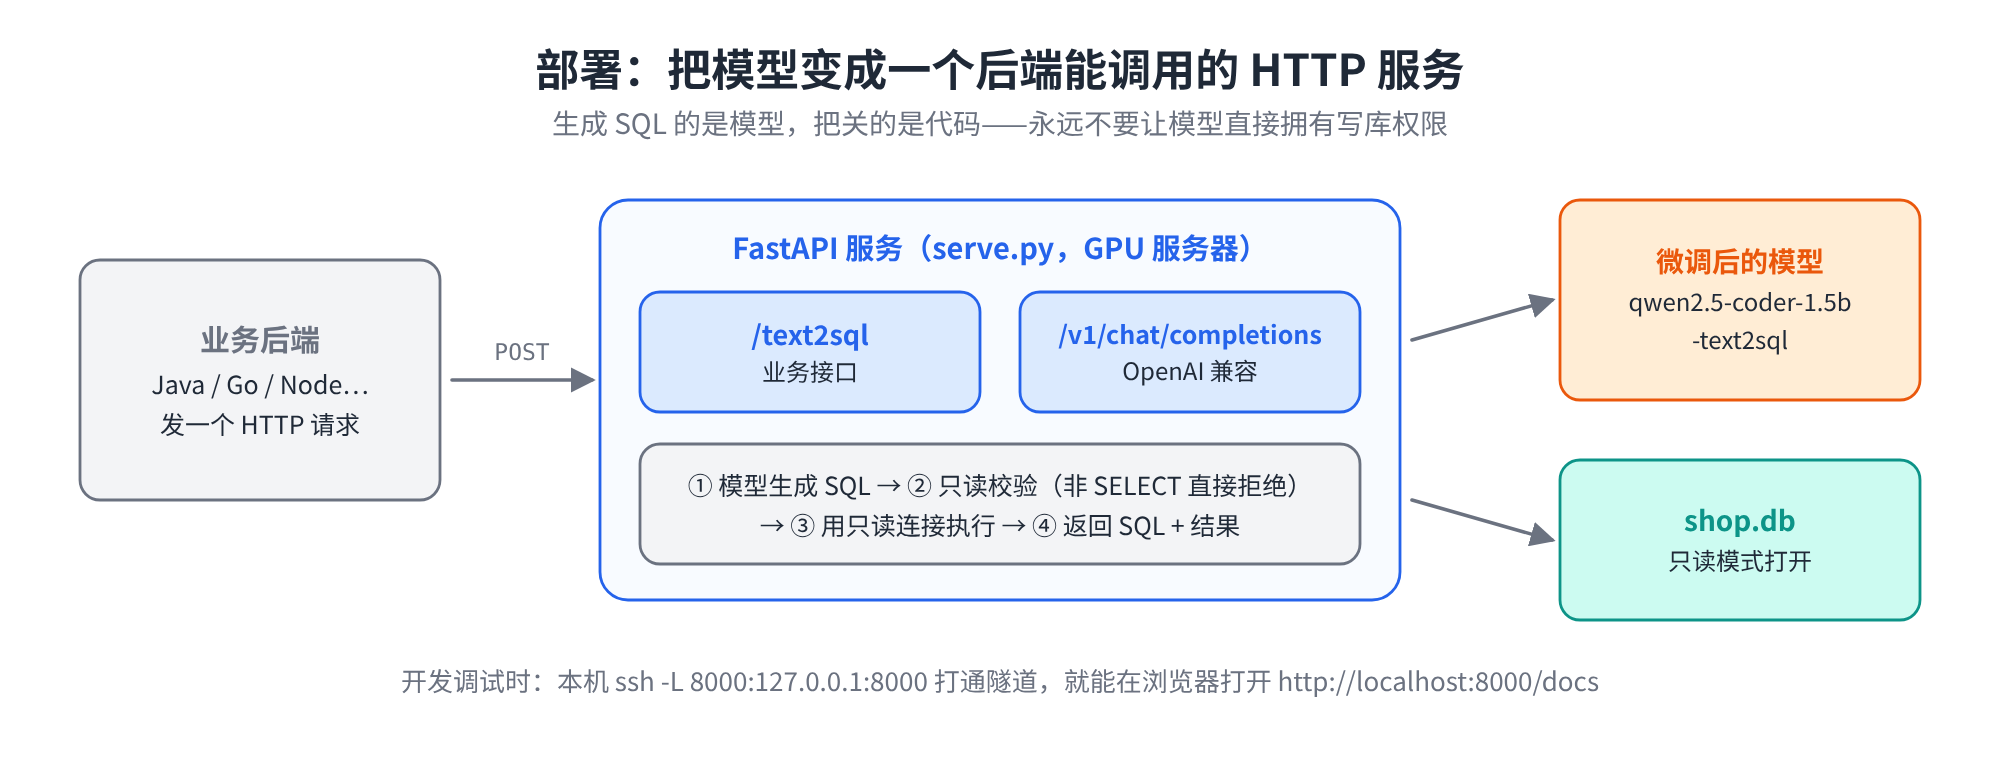
POST /v1/chat/completions:OpenAI 兼容格式。好处是任何语言、任何支持 OpenAI SDK 的框架都能直接调用,不用为它单独写客户端。POST /text2sql:业务接口。传入一个问题,服务端负责拼提示词、调用模型、抽取 SQL、做安全检查、执行查询,最后把 SQL 和查询结果一起返回。
最关键的是中间那道安全检查。模型再可靠,本质上也是一个概率机器,永远不要让它直接拥有写库的权限:
|
|
启动服务:
|
|
--host 0.0.0.0 表示监听所有网卡,这样才能从服务器外部访问。在本地电脑上建一条 SSH 隧道(和上面 WebUI 的做法一样,把 7860 换成 8000),就可以在本地浏览器打开 http://localhost:8000/docs,FastAPI 会自动生成一个可以直接调试的接口文档页面。
用 curl 调一下业务接口:
|
|
返回的 JSON 里有模型生成的 SQL、结果的列名和数据(数值来自本文脚本生成的 shop.db):
|
|
后端用什么语言都行,发一个 HTTP 请求即可。如果用 OpenAI 兼容接口,Python 里可以直接用官方 SDK:
|
|
注意 messages 要用 build_messages() 来拼,保证和训练时的提示词格式完全一致,这是第 2.1 节反复强调的那条铁律。
4.7.1 生产部署的注意事项
serve.py 是一个教学用的最小实现:单进程、加锁、一次只处理一个请求。真正上线时,还要考虑这些问题:
- 推理性能。 用专门的推理引擎代替手写的
model.generate()。比如 vLLM 一行命令就能起一个高并发的 OpenAI 兼容服务:vllm serve models/qwen2.5-coder-1.5b-text2sql --served-model-name text2sql,它会自动做批处理和显存管理,吞吐量能高出一个数量级。vLLM 还支持不合并、直接加载 LoRA,并且同一个服务里挂多个 LoRA。 - 安全。 除了只读检查,还要用权限最小的数据库账号、限制可访问的表、给查询设置超时和返回行数上限,并记录每一条生成的 SQL 以便审计。
- 持续迭代。 线上用户问出来、模型答错的问题,是最宝贵的数据。把它们收集起来、修正答案、补进训练集,定期重新微调,形成数据飞轮。
4.8 使用 GRPO 进一步训练(选读)
如果分布外测试集上的分数还不够满意,可以在 SFT 之后接一轮第 3.6 节讲的 GRPO。Text-to-SQL 的奖励天然可以自动计算,非常适合 RLVR。用 Hugging Face 的 TRL 库,核心代码大致是这样(完整版见配套代码中的 train_grpo.py,在 TRL 1.x 上做过冒烟测试):
|
|
需要注意三点:
- 从 SFT 后的模型出发。 基座模型的输出格式不稳定,奖励经常算不出来;SFT 之后格式已经固定,GRPO 才能专心优化正确率。
- 选“有区分度”的题。 如果 SFT 后的模型在某类题上已经全对,这些题在 GRPO 里优势全为 0,白白浪费算力。TRL 的训练日志里有一个指标
frac_reward_zero_std,表示“一组回答得分完全相同”的题目占比,它越高,说明越多的题在白跑。可以先用eval.py跑一遍,把那些“有时对、有时错”的题挑出来重点训练。 - 强化学习的学习率要比 SFT 小得多,并且盯紧 KL 散度和奖励曲线,防止模型偏离太远或者钻了奖励的空子。
强化学习的训练成本比 SFT 高一个数量级以上(每一步都要先生成一组回答再打分),所以先把 SFT 做扎实,确认确实有必要,再上 RL。
要点总结
如果只记住几句话,就记这些:
- 训练的本质是调整概率分布。 预训练、Mid-training、SFT、强化学习的区别,只在于“想让哪些输出的概率变高”,以及用什么信号来定义“好”。
- 先诊断,再动手。 能用提示词解决的不微调;会变化、要溯源的事实交给 RAG;模型连基础概念都不懂,先补底座;会做但格式、口径不稳定,才是 SFT 的主场。
- SFT 就是“换了数据、只在回答上算损失”的预测下一个词。 它擅长固化格式、风格、流程这类“协议”,不擅长靠几十条问答灌知识。对话模板训练时用什么,推理时就必须用什么。
- 盯验证集,不盯训练集。 训练损失一定会降,验证损失回升就是过拟合;最终效果用独立的测试集说话,最好再准备一份“题型没见过”的分布外测试集。
- 全参数微调贵在梯度和优化器状态,每个参数约 16 字节。PEFT 只训练一小部分参数,分为参数附加、参数选择、低秩适配三类。
- LoRA:冻结 $W_0$,并联一条低秩旁路 $\frac{\alpha}{r}BA$;A 随机初始化、B 初始化为 0;挂在所有线性层上;学习率约为全参数微调的 10 倍;训练完可以合并回原权重,推理零开销,也可以当插件挂载。QLoRA 再把冻结权重压成 4 位。
- SFT 只会模仿,不懂好坏,所以还有偏好对齐。RLHF 三步走:SFT → 奖励模型 → PPO,KL 惩罚防止奖励作弊。
- PPO 用价值模型估计优势、用裁剪限制步长,灵活但重;DPO 把奖励换成“相对参考模型的概率涨幅”,直接从好坏回答对里学,简单稳定但只能离线;GRPO 用一组回答的平均分代替价值模型,最适合答案可以自动验证的任务。
- 强化学习只能放大“偶尔做得到”的能力:pass@k 接近 0 时先补底座或先做 SFT;一组回答全对或全错时什么都学不到。
- 数据和评测比算法更重要。 大多数时候效果不好,问题出在数据上。
结语
回到开头的问题:怎样让一个通用模型变成“我们自己的”模型?读到这里,答案应该清楚了:如果你要的是它记住一堆会变的企业知识,用 RAG;如果你要的是它按你们的规矩说话、办事,用 SFT;如果你要的是它在没见过的情况下也能做出更好的选择,再考虑强化学习。
微调不是魔法,它只是把你准备的数据里那些规律,用梯度下降一点点“刻”进参数里。数据是什么样,模型就会变成什么样。
参考资料
- 堂吉诃德拉曼查的英豪. 微调 DeepSeek + 后端调用(视频及配套笔记). bilibili.
- 毛玉仁, 葛宇航, 等.《大模型基础》第 4 章「参数高效微调」. 浙江大学. GitHub: ZJU-LLMs/Foundations-of-LLMs.
- 李博杰.《深入理解 AI Agent:设计原理与工程实践》第 8 章「模型后训练」. GitHub: bojieli/ai-agent-book.
- Hu, E. J., et al. (2021). LoRA: Low-Rank Adaptation of Large Language Models. ICLR 2022.
- Dettmers, T., et al. (2023). QLoRA: Efficient Finetuning of Quantized LLMs. NeurIPS 2023.
- Aghajanyan, A., Zettlemoyer, L., & Gupta, S. (2020). Intrinsic Dimensionality Explains the Effectiveness of Language Model Fine-Tuning.
- Houlsby, N., et al. (2019). Parameter-Efficient Transfer Learning for NLP(Adapter).
- Lester, B., Al-Rfou, R., & Constant, N. (2021). The Power of Scale for Parameter-Efficient Prompt Tuning.
- Li, X. L., & Liang, P. (2021). Prefix-Tuning: Optimizing Continuous Prompts for Generation.
- Liu, A., et al. (2024). Tuning Language Models by Proxy.
- Ben Zaken, E., Ravfogel, S., & Goldberg, Y. (2021). BitFit: Simple Parameter-efficient Fine-tuning for Transformer-based Masked Language-models.
- Liu, S.-Y., et al. (2024). DoRA: Weight-Decomposed Low-Rank Adaptation.
- Zhang, Q., et al. (2023). AdaLoRA: Adaptive Budget Allocation for Parameter-Efficient Fine-Tuning.
- Biderman, D., et al. (2024). LoRA Learns Less and Forgets Less.
- Schulman, J., & Thinking Machines Lab (2025). LoRA Without Regret.
- Ouyang, L., et al. (2022). Training Language Models to Follow Instructions with Human Feedback(InstructGPT / RLHF).
- Schulman, J., et al. (2017). Proximal Policy Optimization Algorithms.
- Rafailov, R., et al. (2023). Direct Preference Optimization: Your Language Model is Secretly a Reward Model.
- Shao, Z., et al. (2024). DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models(GRPO).
- DeepSeek-AI (2025). DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning.
- Chu, T., et al. (2025). SFT Memorizes, RL Generalizes: A Comparative Study of Foundation Model Post-training.
- LLaMA-Factory · Hugging Face PEFT · Hugging Face TRL · Qwen2.5-Coder