今天你用到的几乎所有大语言模型——GPT、Claude、Llama、通义、豆包、DeepSeek——都站在同一篇 2017 年的论文上。这篇文章不堆公式,而是沿着一条主线,把 Transformer 从“为什么需要它”一路讲到“它内部每一块在干什么”。
读完你应该能回答一个问题:为什么 2017 年之前,我们没有迎来大模型时代?
写在前面
全文会反复用到视频里的一个例子:把中文 “我爱水课” 翻译成英文 “I love easy courses”。“水课”是大学生的黑话,意思是轻松好过的课。这个例子有个坑:“水”单独看是 water,只有结合后面的“课”,才知道它在这里是 easy。机器能不能跳过这个坑,正好检验它是不是真的“读懂了上下文”。
论文本身的结构是:先讲以前的模型有什么问题(第 1、2 节),再讲 Transformer 的结构(第 3 节),然后回答“为什么用自注意力”(第 4 节),最后是训练和实验结果。我们也按这个顺序走,只是在读论文之前,先把它默认你懂的那些背景补上——论文总是默认你什么都懂。
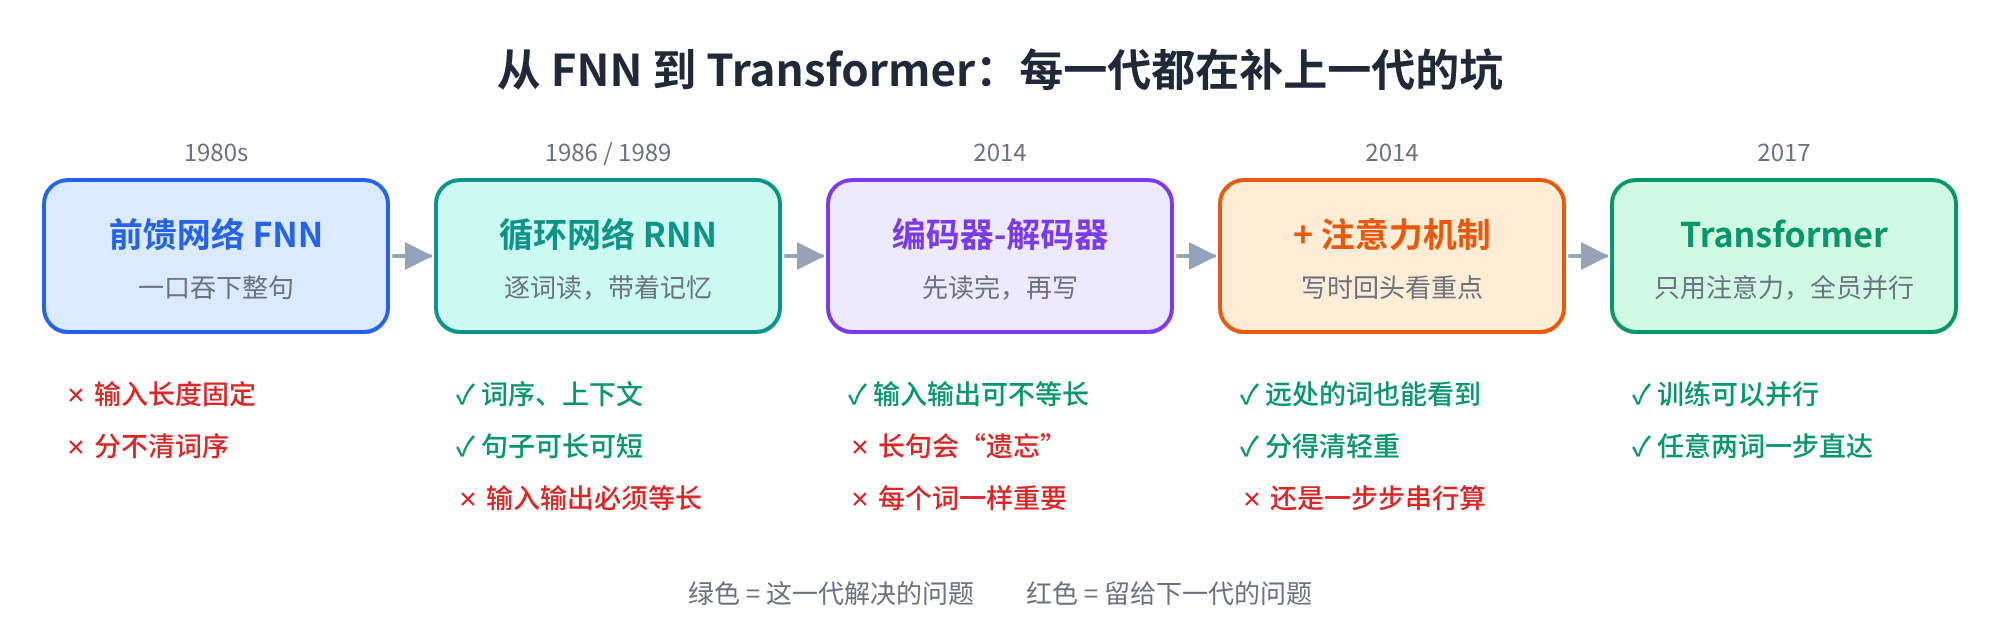
上面这张图就是前半篇的地图。每一代模型都解决了上一代的一些问题,又留下新的问题。Transformer 的出现,就是为了填上最后那个坑。
1 Transformer 出现之前
1.1 先搞清楚任务:什么是“序列转导”
论文摘要的第一句话是:
The dominant sequence transduction models are based on complex recurrent or convolutional neural networks that include an encoder and a decoder.
“序列转导模型”(sequence transduction model)听起来很玄,其实就是把一个序列变成另一个序列的模型。
什么是序列?就是顺序有意义的数据。最典型的就是语言:“水是有毒的”和“有毒的是水”用的是同样几个字,意思却完全不同。机器翻译(中文序列 → 英文序列)、对话(问题序列 → 回答序列)、文本摘要(长序列 → 短序列),都是序列转导任务。
所以这句话的意思是:在这篇论文之前,主流的序列转导模型有三个特点——
- 基于循环神经网络(RNN)或卷积神经网络(CNN),其中绝大多数是 RNN;
- 采用“编码器-解码器”结构;
- 表现最好的那些,还会用“注意力机制”把编码器和解码器连起来。
而这篇论文提出的 Transformer,完全扔掉了 RNN 和 CNN,只靠注意力机制(仍然保留了编码器-解码器的大框架)。
要理解这为什么是革命性的,我们得先看看 RNN、编码器-解码器、注意力机制分别是什么,它们各自解决了什么问题,又卡在了哪里。
1.2 机器怎么“看”文字:分词与词嵌入
在讲任何神经网络之前,有个绕不开的前置步骤:计算机只认数字,文字得先变成数字。
第一步叫分词(tokenization),把句子切成一个个小单元,叫 token。初学时你可以把 token 简单理解成“词”。比如“水是有毒的”切成 ["水", "是", "有毒", "的"]。
第二步叫词嵌入(embedding),给每个 token 分配一个向量,也就是一串数字。在 Transformer 里,这个向量有 512 个数,我们说它是“512 维”的。
为什么要用这么长的向量,而不是给每个词编个号(水=1,是=2……)?因为向量可以表达“意思上的远近”。你可以把 512 维空间想象成一张巨大的地图,每个词是地图上的一个点:
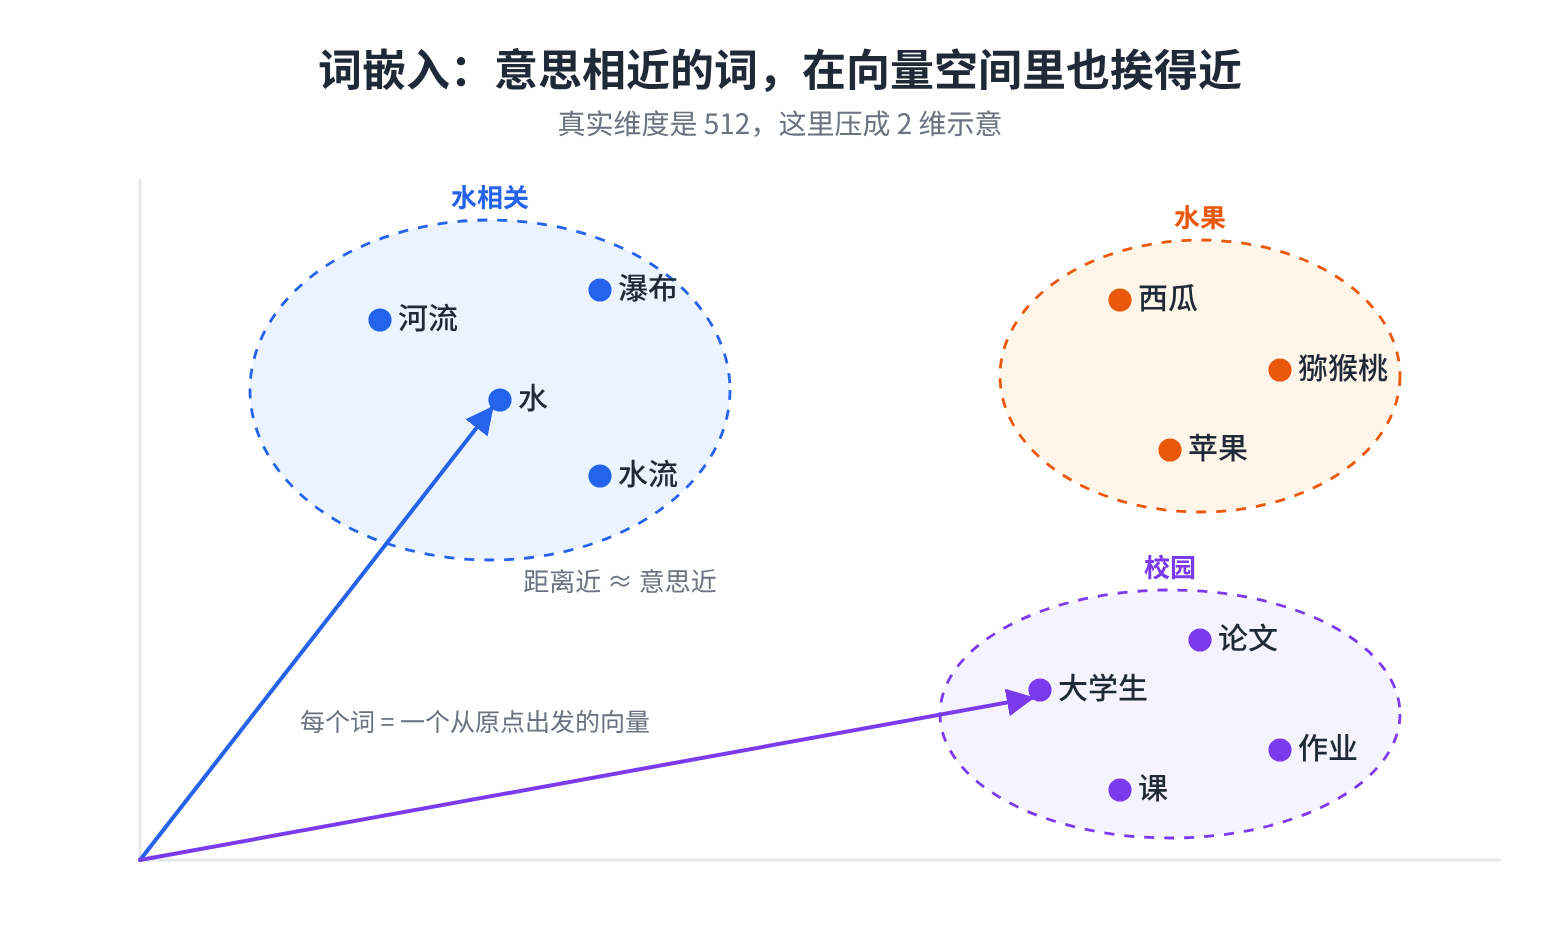
“水”“河流”“瀑布”会聚在一块,“大学生”“论文”“作业”聚在另一块。两个词的向量方向越接近,意思通常也越接近。机器就是靠这种几何关系,来“感知”词语之间的相似性。
这些向量不是人手工写的,而是在训练中学出来的。早期常用别人训练好的词向量直接拿来用;而在 Transformer 这类模型里,词嵌入表通常和整个模型一起训练、一起调整,效果更好。
好,有了词向量,我们可以开始往神经网络里喂东西了。
1.3 第一站:前馈神经网络,一口吞不下句子
学机器学习时最先接触的网络,叫前馈神经网络(Feedforward Neural Network,FNN)。结构非常简单:输入层 → 隐藏层 → 输出层,数据从左往右流一遍就结束。中间每一层都是“乘一个权重矩阵、再过一个非线性函数”。
问题在于,FNN 的输入层大小是固定的。它像一个形状固定的插槽,只能插进固定长度的向量。可句子有长有短,怎么塞进去?
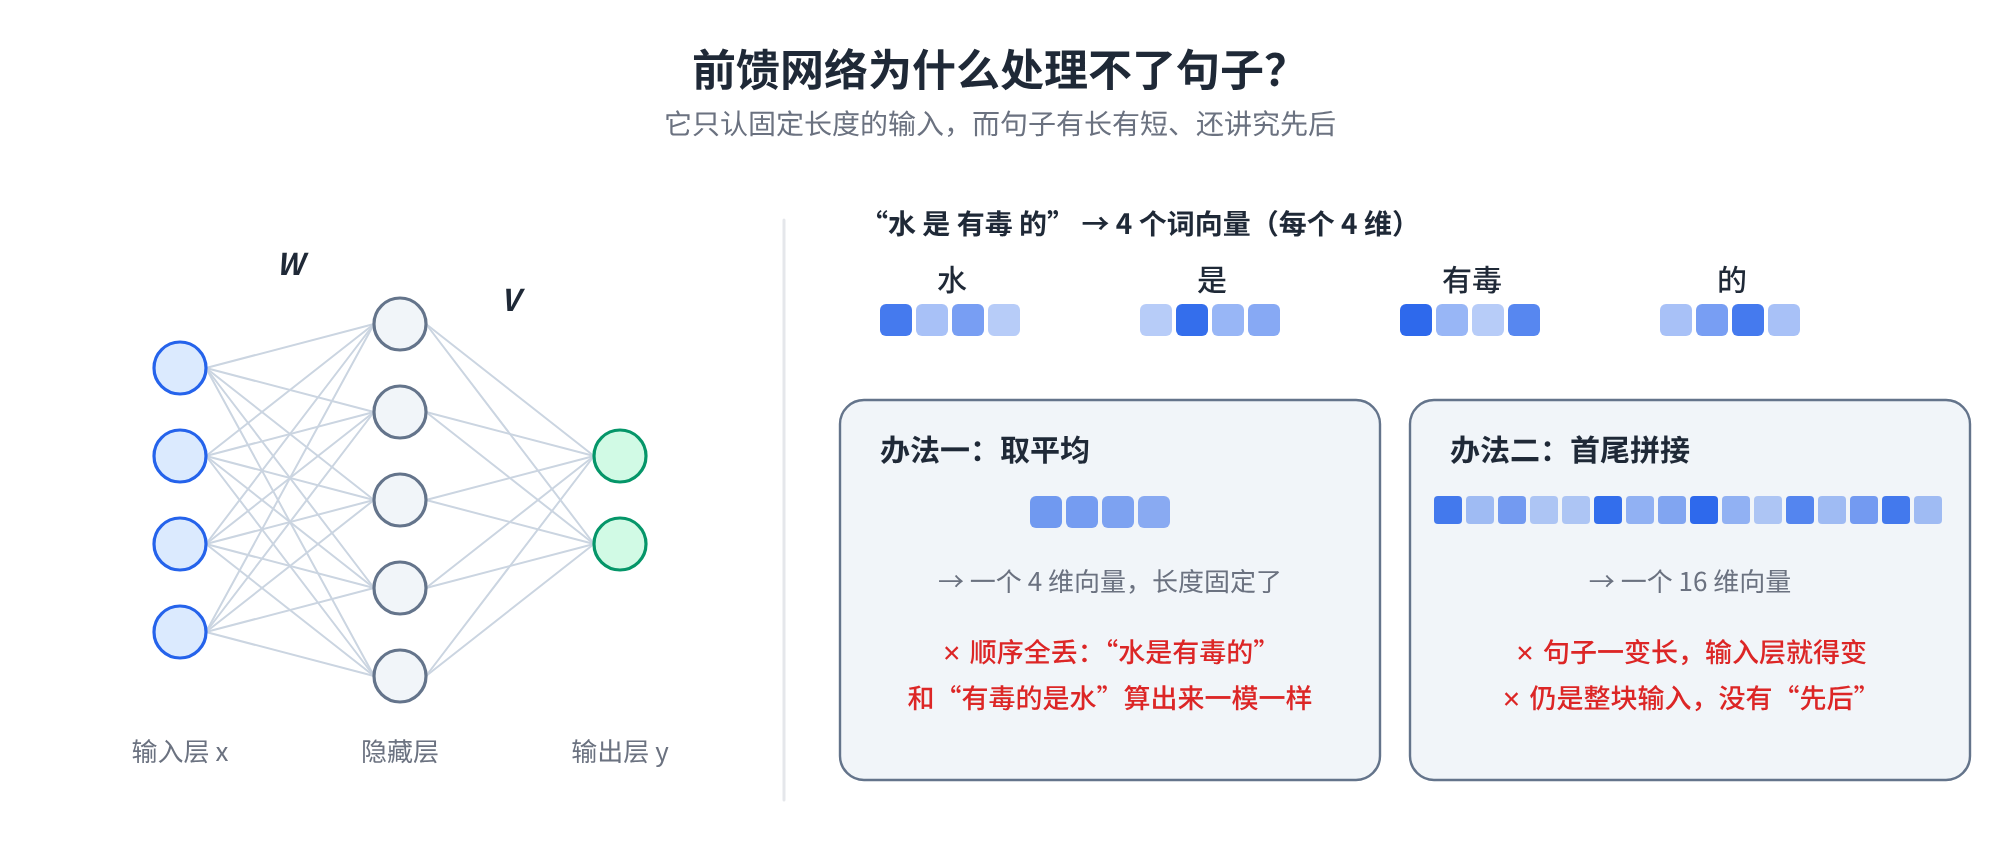
最直接的办法有两个,但都不太行:
- 取平均:把所有词向量逐位平均成一个向量。长度倒是固定了,但顺序信息全丢了——“水是有毒的”和“有毒的是水”算出来一模一样。
- 首尾拼接:把 4 个 4 维向量拼成一个 16 维的。可句子一变长,输入层就得跟着变;你总不能为了可能出现的最长句子,准备一个巨大无比的输入层。更要命的是,拼接后整句仍然是“一次性整块”塞进去的,网络并不理解谁先谁后。
所以 FNN 在序列任务面前有两个硬伤:不支持不定长的输入,也建模不了词序。
1.4 第二站:RNN,一个词一个词地读
循环神经网络(Recurrent Neural Network,RNN)的想法很像人读句子:不是一眼吞下整句,而是一个词一个词地读,边读边记。
它的结构相对 FNN 改动很小,只是在隐藏层上加了一个“圈”:这一步算出的结果,会作为下一步输入的一部分。把这个圈按时间展开,就是下面这样:
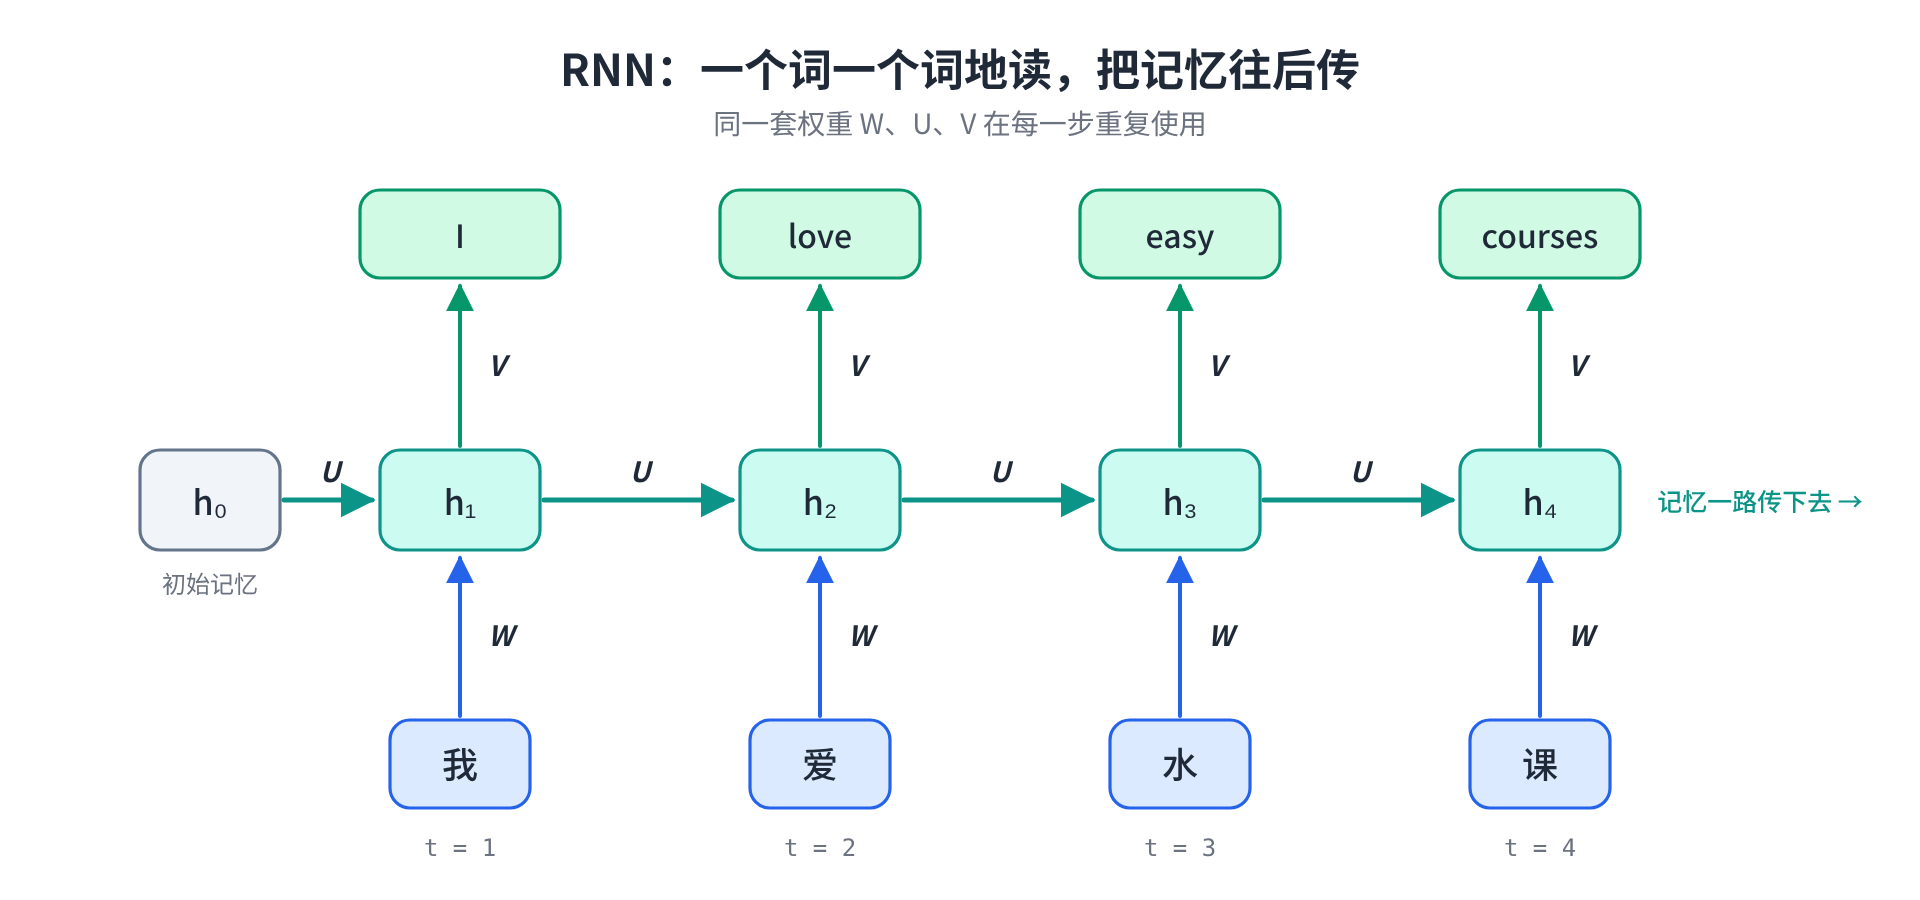
拿“我爱水课”来走一遍:
- 第 1 步,输入“我”的向量 $x_1$,和一个初始记忆 $h_0$ 一起算出新的记忆 $h_1$,再由 $h_1$ 算出这一步的输出 “I”。
- 第 2 步,输入“爱”,和上一步的记忆 $h_1$ 一起算出 $h_2$,再输出 “love”。
- 以此类推。
写成公式就是:
$$ h_t = g(W x_t + U h_{t-1}), \qquad y_t = g(V h_t) $$
$x_t$ 是第 $t$ 步的输入,$h_t$ 是第 $t$ 步的“记忆”(论文里叫隐藏状态 hidden state),$y_t$ 是输出;$W$、$U$、$V$ 是三个权重矩阵,每一步用的都是同一套;$g$ 是激活函数,给网络引入非线性。
所以每一步其实有两个产出:一个是给下一步用的记忆 $h_t$,负责把前面读过的信息往后带;一个是这一步实际的输出 $y_t$。
RNN 一口气解决了 FNN 的三个问题:
- 能建模词序:词是按顺序一个个进来的,顺序不同,算出的结果就不同;
- 能建模上下文依赖:有 $h_t$ 这条“记忆链”,读到后面时还记得前面;
- 支持不定长输入:句子多长都行,多读几步而已。
但你应该已经发现一个问题了:输入 4 个词,就输出 4 个词。可翻译哪有这么整齐?“我爱水课”是 4 个字,换个说法翻成 “I really enjoy easy courses” 就是 5 个词。输入和输出不等长时怎么办?
1.5 第三站:编码器-解码器,先读完再写
2014 年的 Seq2Seq(Sutskever 等人)给出的答案是:把 RNN 拆成两半。
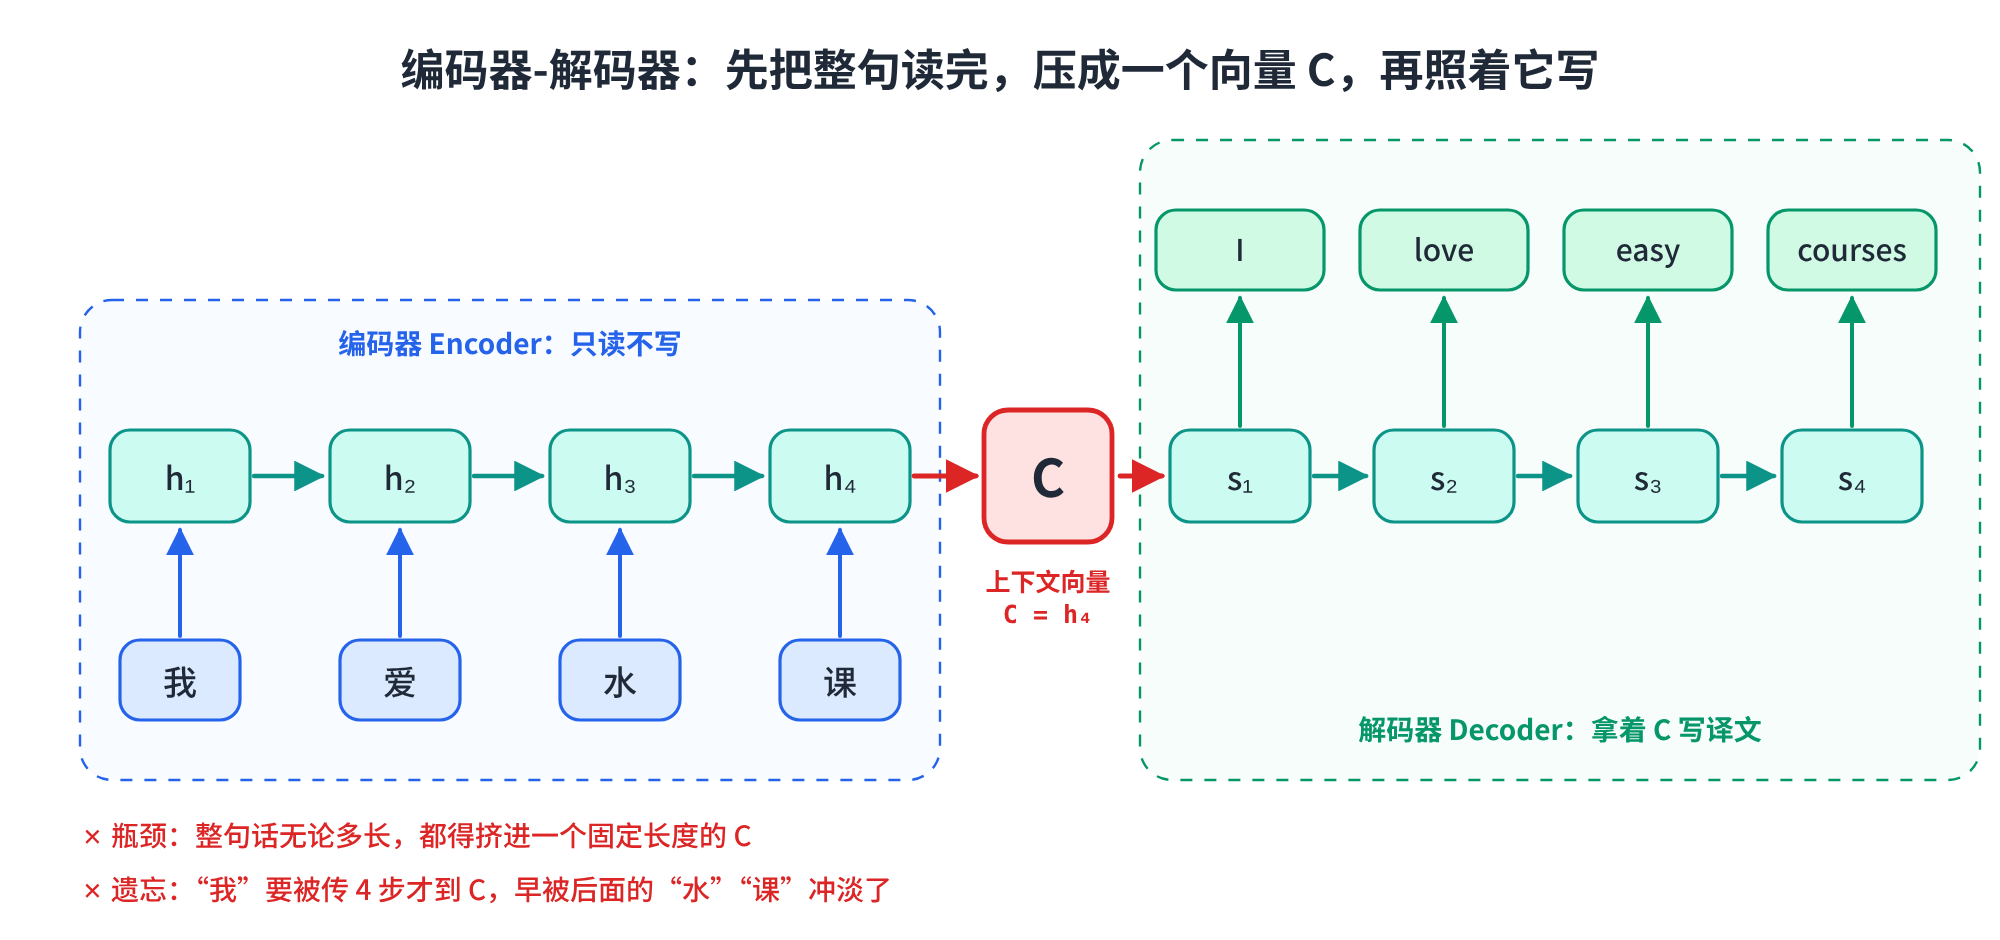
- 编码器(Encoder)只管读:它就是一个去掉了输出 $y$ 的 RNN,从头到尾把原文读一遍,最后得到一个上下文向量 $C$。最简单的做法就是直接拿最后一步的记忆当 $C$,即 $C = h_4$。
- 解码器(Decoder)只管写:它是另一个 RNN,拿着 $C$ 作为起点,一个词一个词地生成译文。每生成一个词,就把它当作下一步的输入,直到生成“结束”符号为止。
为什么 $C$ 能代表整句话?因为编码器是按顺序一步步读下来的,每一步的记忆都融合了之前所有词的信息,最后的 $h_4$ 自然就包含了整句的语义,也隐含了词序。
这样一来,读和写彻底分开,输入和输出可以不一样长了。
但新问题又来了,而且有两个。
第一个问题:遗忘。 整句话无论多长,都得挤进一个固定长度的向量 $C$ 里。而 $C = h_4$ 显然受离它近的词影响更大:“水”和“课”刚读完,印象深刻;“我”要经过好几步传递才到达 $h_4$,每传一步都被稀释一点。句子越长,开头的信息丢得越多。
第二个问题:不分轻重。 解码器写每一个词时,看的都是同一个 $C$。可写 “I” 的时候最该关注“我”,写 “easy” 的时候最该关注“水”和“课”。所有词被一视同仁,模型就很容易犯错——比如把“水课”翻成 water courses。
1.6 第四站:注意力机制,写每个词时回头看重点
2014 年,Bahdanau 等人提出了注意力机制(Attention)。要注意,注意力机制在 Transformer 之前就已经存在了;Transformer 的创新是“自注意力”,这个后面会讲。
注意力的想法很朴素:既然解码器每一步关心的重点不同,那就别给它同一个 $C$ 了,每一步单独配一个。
具体做法是,保留编码器每一步的记忆 $h_1, h_2, h_3, h_4$,解码器每写一个词时,都重新给这几个记忆分配一组权重,再加权求和,得到这一步专属的上下文:
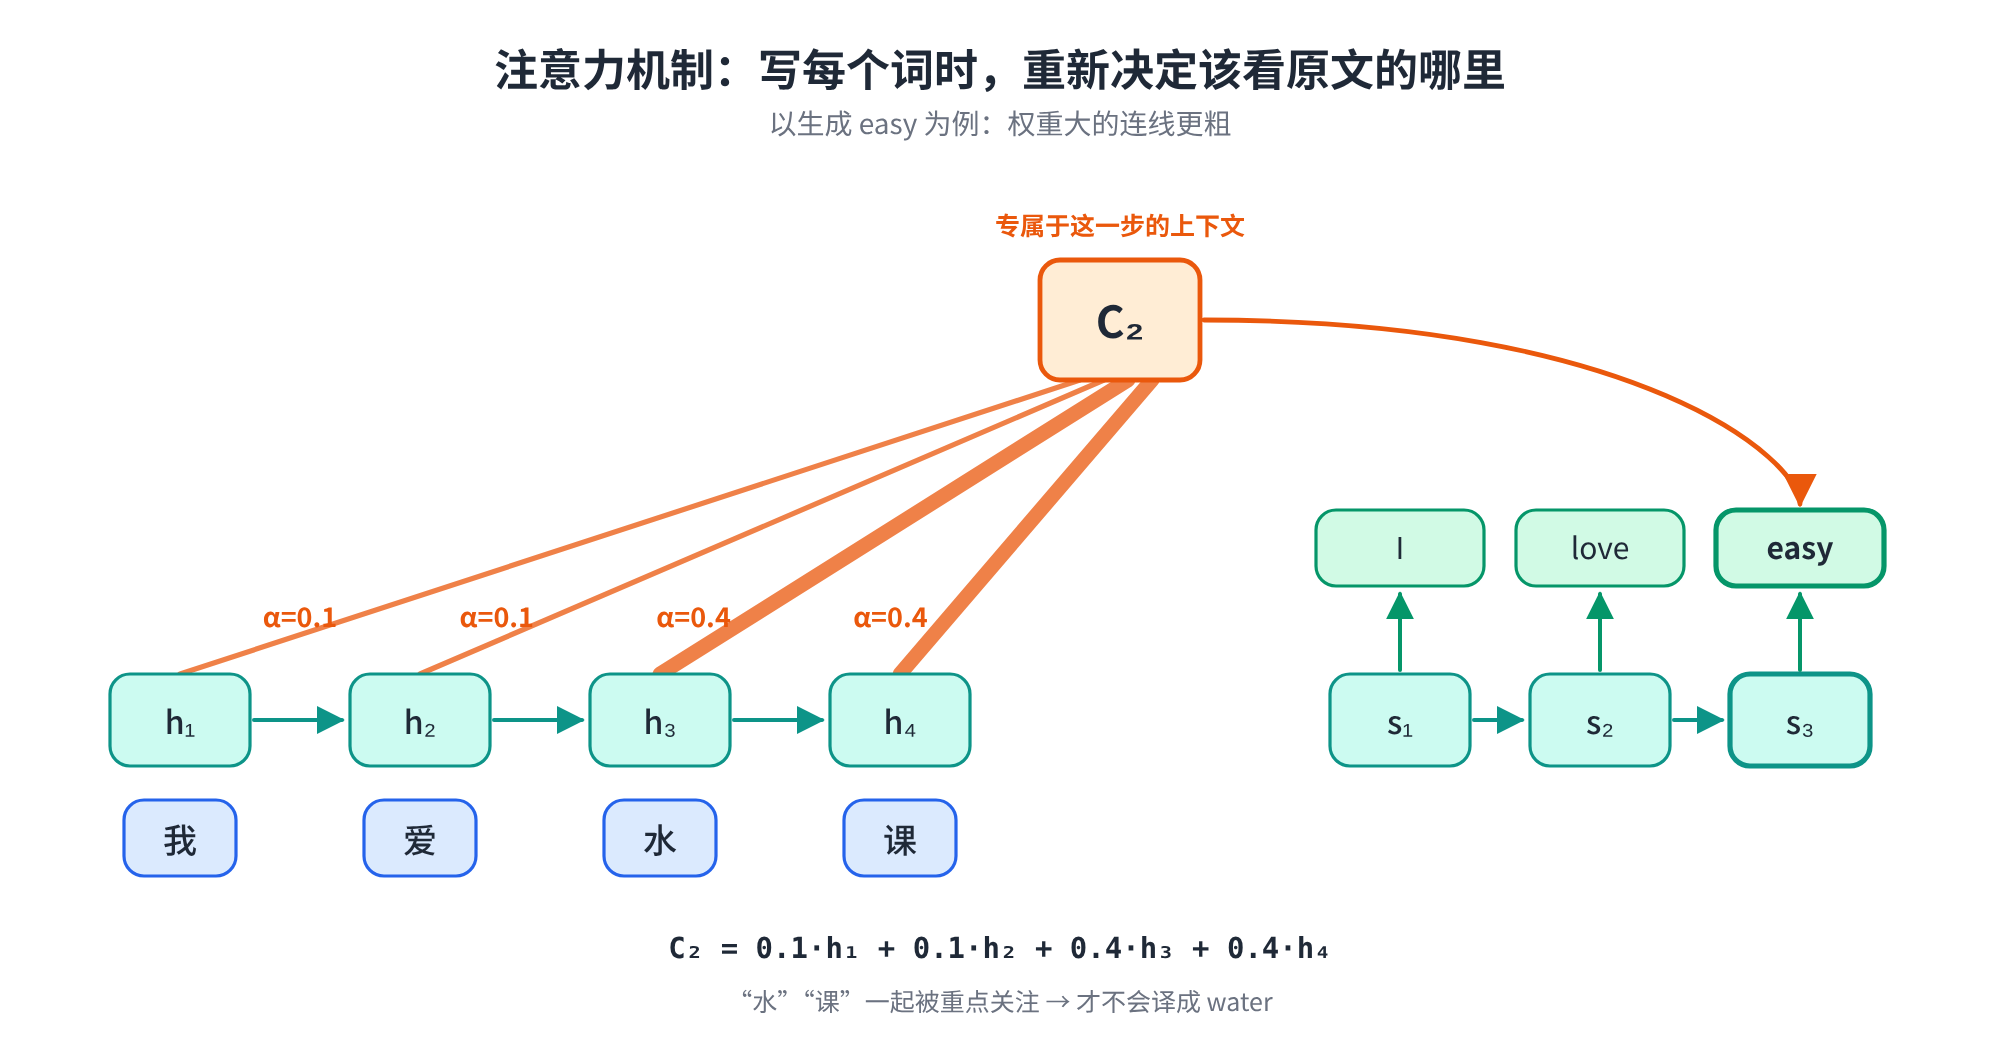
比如生成 “easy” 这一步,我们希望模型同时注意到“水”和“课”,别把“水”孤立地译成 water,于是给它们都分配较大的权重:
$$ C_2 = 0.1,h_1 + 0.1,h_2 + 0.4,h_3 + 0.4,h_4 $$
一般地,第 $i$ 步的上下文是 $C_i = \sum_j \alpha_{ij} h_j$,其中权重 $\alpha_{ij}$ 都是非负数,加起来等于 1。这些权重不是人定的,而是模型根据“当前要写什么”和“原文每个位置是什么”自己算出来的。
这一招一次解决了两个问题:
- 遗忘问题缓解了:哪怕是句子开头的词,只要它重要,就能直接分到大权重,不用再经历层层传递的稀释;
- 轻重问题解决了:每一步都有自己的关注重点。
到这里,我们已经把论文摘要里“以前的模型”的三个特点全讲完了:基于 RNN,采用编码器-解码器结构,用注意力机制连接编码器和解码器。
1.7 还剩最后一个坑:串行计算
注意力机制让翻译质量提升了一大截,但它是“装”在 RNN 上的,RNN 的一个根本缺陷还在:它必须排队计算。
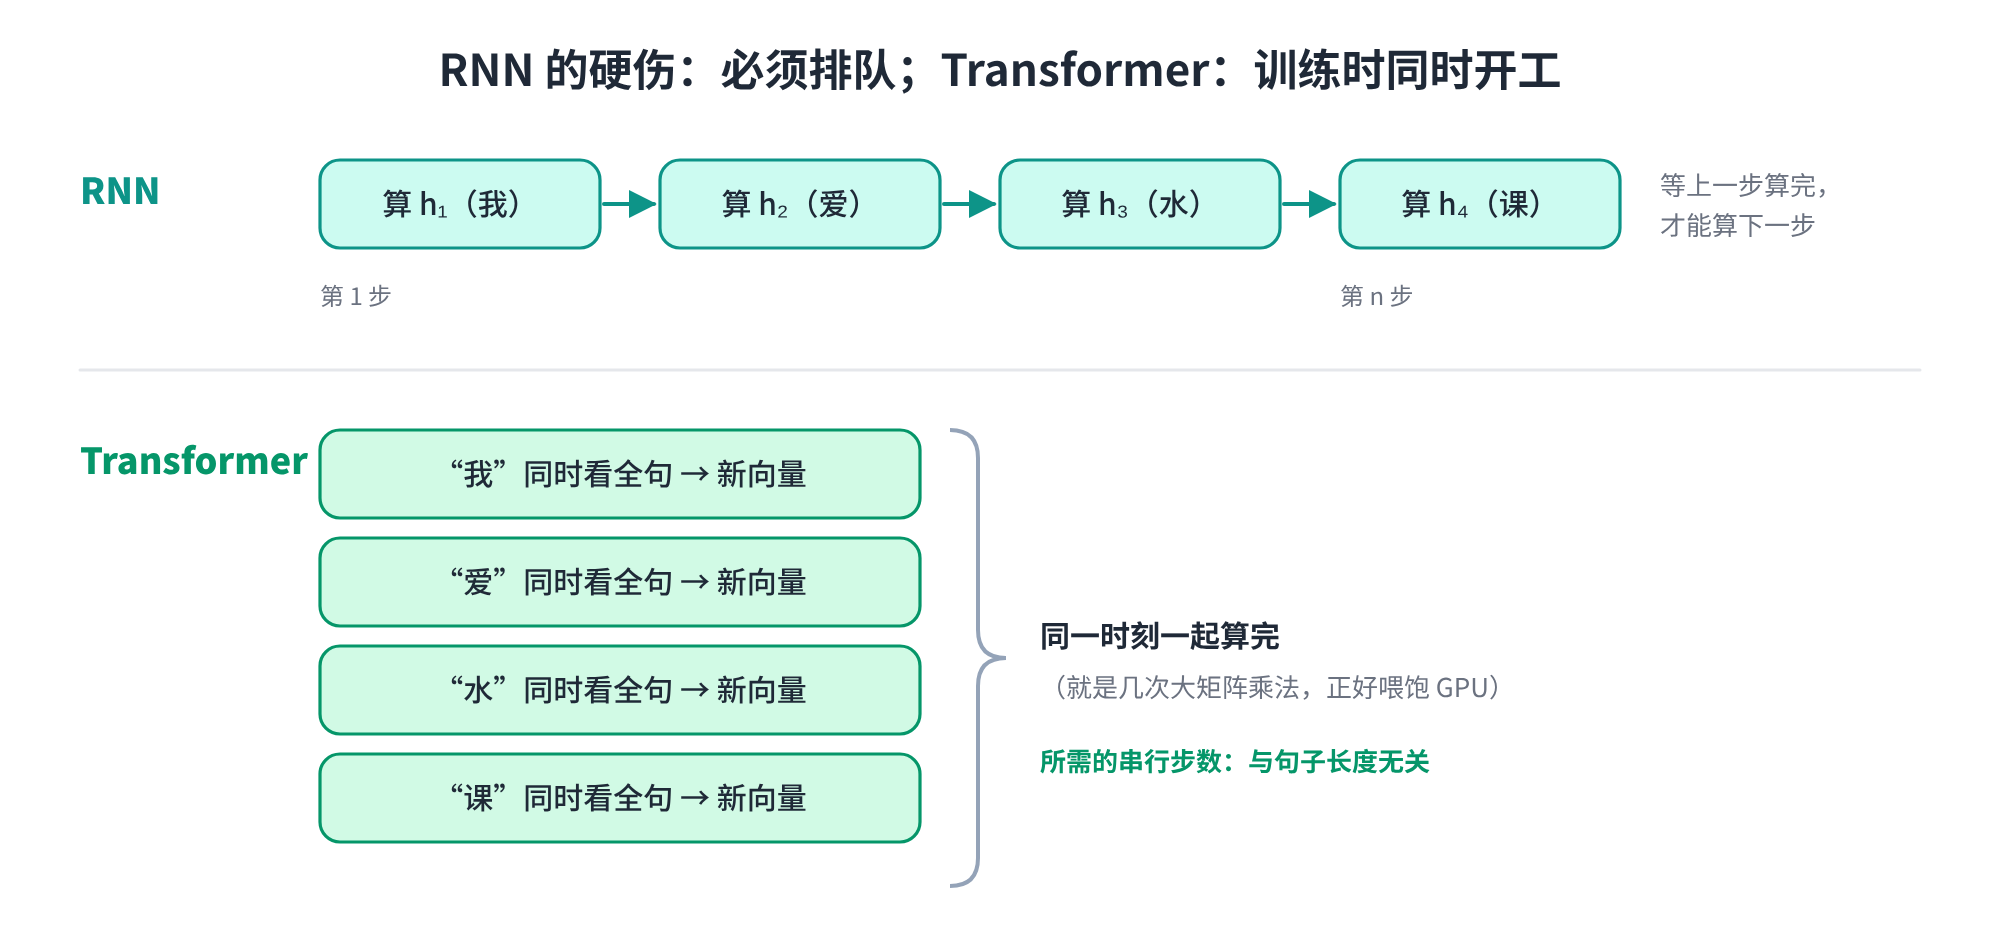
想得到 $h_4$,必须先有 $h_3$;想得到 $h_3$,必须先有 $h_2$……每一步都依赖上一步的结果。解码也一样,要生成 “easy”,必须等 “I love” 先生成完。
这在计算上意味着什么?GPU 的强项是“同时做大量相同的运算”,几千个计算核心一起开工。可 RNN 的计算是一条单行道,再多的核心也只能一个接一个地等。句子越长,等得越久;训练数据越多,这个瓶颈就越致命。
论文第 1 节说的正是这一点:
This inherently sequential nature precludes parallelization within training examples, which becomes critical at longer sequence lengths.
(这种固有的顺序性,使得单个训练样本内部无法并行;序列越长,问题越严重。)
现在回头看那张路线图,我们可以把前面所有的问题列成一张清单:
| 问题 | FNN | RNN | +编码器-解码器 | +注意力 |
|---|---|---|---|---|
| 建模词序 | ✗ | ✓ | ✓ | ✓ |
| 建模上下文依赖 | ✗ | ✓ | ✓ | ✓ |
| 支持不定长输入 | ✗ | ✓ | ✓ | ✓ |
| 输入输出可以不等长 | ✗ | ✗ | ✓ | ✓ |
| 长序列不“遗忘” | — | ✗ | ✗ | ✓ |
| 分得清不同位置的重要性 | — | ✗ | ✗ | ✓ |
| 能并行计算 | — | ✗ | ✗ | ✗ |
最后一行,就是 Transformer 要解决的问题。
1.8 回到论文:Introduction 与 Background 在说什么
有了上面的铺垫,论文前两节就很好读了。它的逻辑是这样的:
Introduction 先说 RNN 及其变体(LSTM、GRU,都属于 RNN 家族)是序列任务的主流方法;然后指出它们的根本局限是“递归计算导致训练无法并行”;接着说注意力机制已经成了好模型的标配,能不管距离远近地捕捉依赖关系——但在几乎所有情况下,注意力都是和 RNN 一起用的,只是一个增强件,没有动摇“顺序计算”这个地基。最后亮出本文的方案:Transformer 完全抛弃循环结构,只靠注意力来建立输入和输出之间的全局依赖。
Background 补充了一些相关尝试。为了解决顺序计算的问题,有人用 CNN 替代 RNN(比如 ConvS2S、ByteNet),CNN 可以并行算所有位置。但 CNN 每次只看一个小窗口,两个离得远的词要建立联系,需要叠很多层才能“传”过去,所需的操作数随距离增长(ConvS2S 是线性增长,ByteNet 是对数增长)。结果是——远距离依赖又难学了,好不容易解决的问题又被捞了回来。Transformer 则把任意两个位置之间的操作数降到了常数。
这一节还提到了“自注意力”(self-attention,让一个序列内部的各个位置互相关注)和端到端记忆网络(一种递归式的注意力机制)。最后一句是全文的定位:
To the best of our knowledge, however, the Transformer is the first transduction model relying entirely on self-attention to compute representations of its input and output without using sequence-aligned RNNs or convolution.
Transformer 是第一个完全依靠自注意力、不使用 RNN 或卷积的序列转导模型。
2 Transformer 是怎么做到的
2.1 核心思路:训练时,答案本来就在手上
在看那张让人“有点绝望”的架构图之前,先想清楚一件事:RNN 为什么非要排队?
因为它假设“后面的东西还不知道”。可在训练的时候,事情并不是这样的。训练数据是成对的:“我爱水课”是输入,“I love easy courses”是标准答案,两者从一开始就完整地摆在我们面前。原文的每个词都在,答案的每个词也都在,谁也没必要等谁。
既然如此,Transformer 换了一种做法:
编码时,不再一个个读。每个词都直接“环顾”整句话,把其他所有词的信息吸收到自己身上,形成一个“带上下文的新向量”。四个词同时做这件事,互不等待。
解码时,同样把整句答案一次性给模型。要预测 “easy” 时,让它看到 “I love” 和原文的编码结果,但把 “easy” 及后面的词遮住,不许偷看。每个位置都这样设置,就能让所有位置的预测同时进行。
这里要强调:这种“同时进行”说的是训练。等模型训练好、真正拿来翻译一句新话时,答案是不知道的,还是只能一个词一个词地生成(第 2.9 节会细讲)。但训练恰恰是最耗算力的环节——大模型要在海量文本上训练,训练能并行,才让“堆数据、堆算力”这条路走得通。
还有一个代价:不再按顺序读,词序信息就没了,所以需要额外把“位置”编码进去。
于是,Transformer 要给每个词编码三样东西:
- 这个词本身的意思——词嵌入;
- 这个词在句子里的位置——位置编码;
- 这个词在当前上下文里的含义——自注意力。
带着这个思路,我们来看全景图。
2.2 全景图
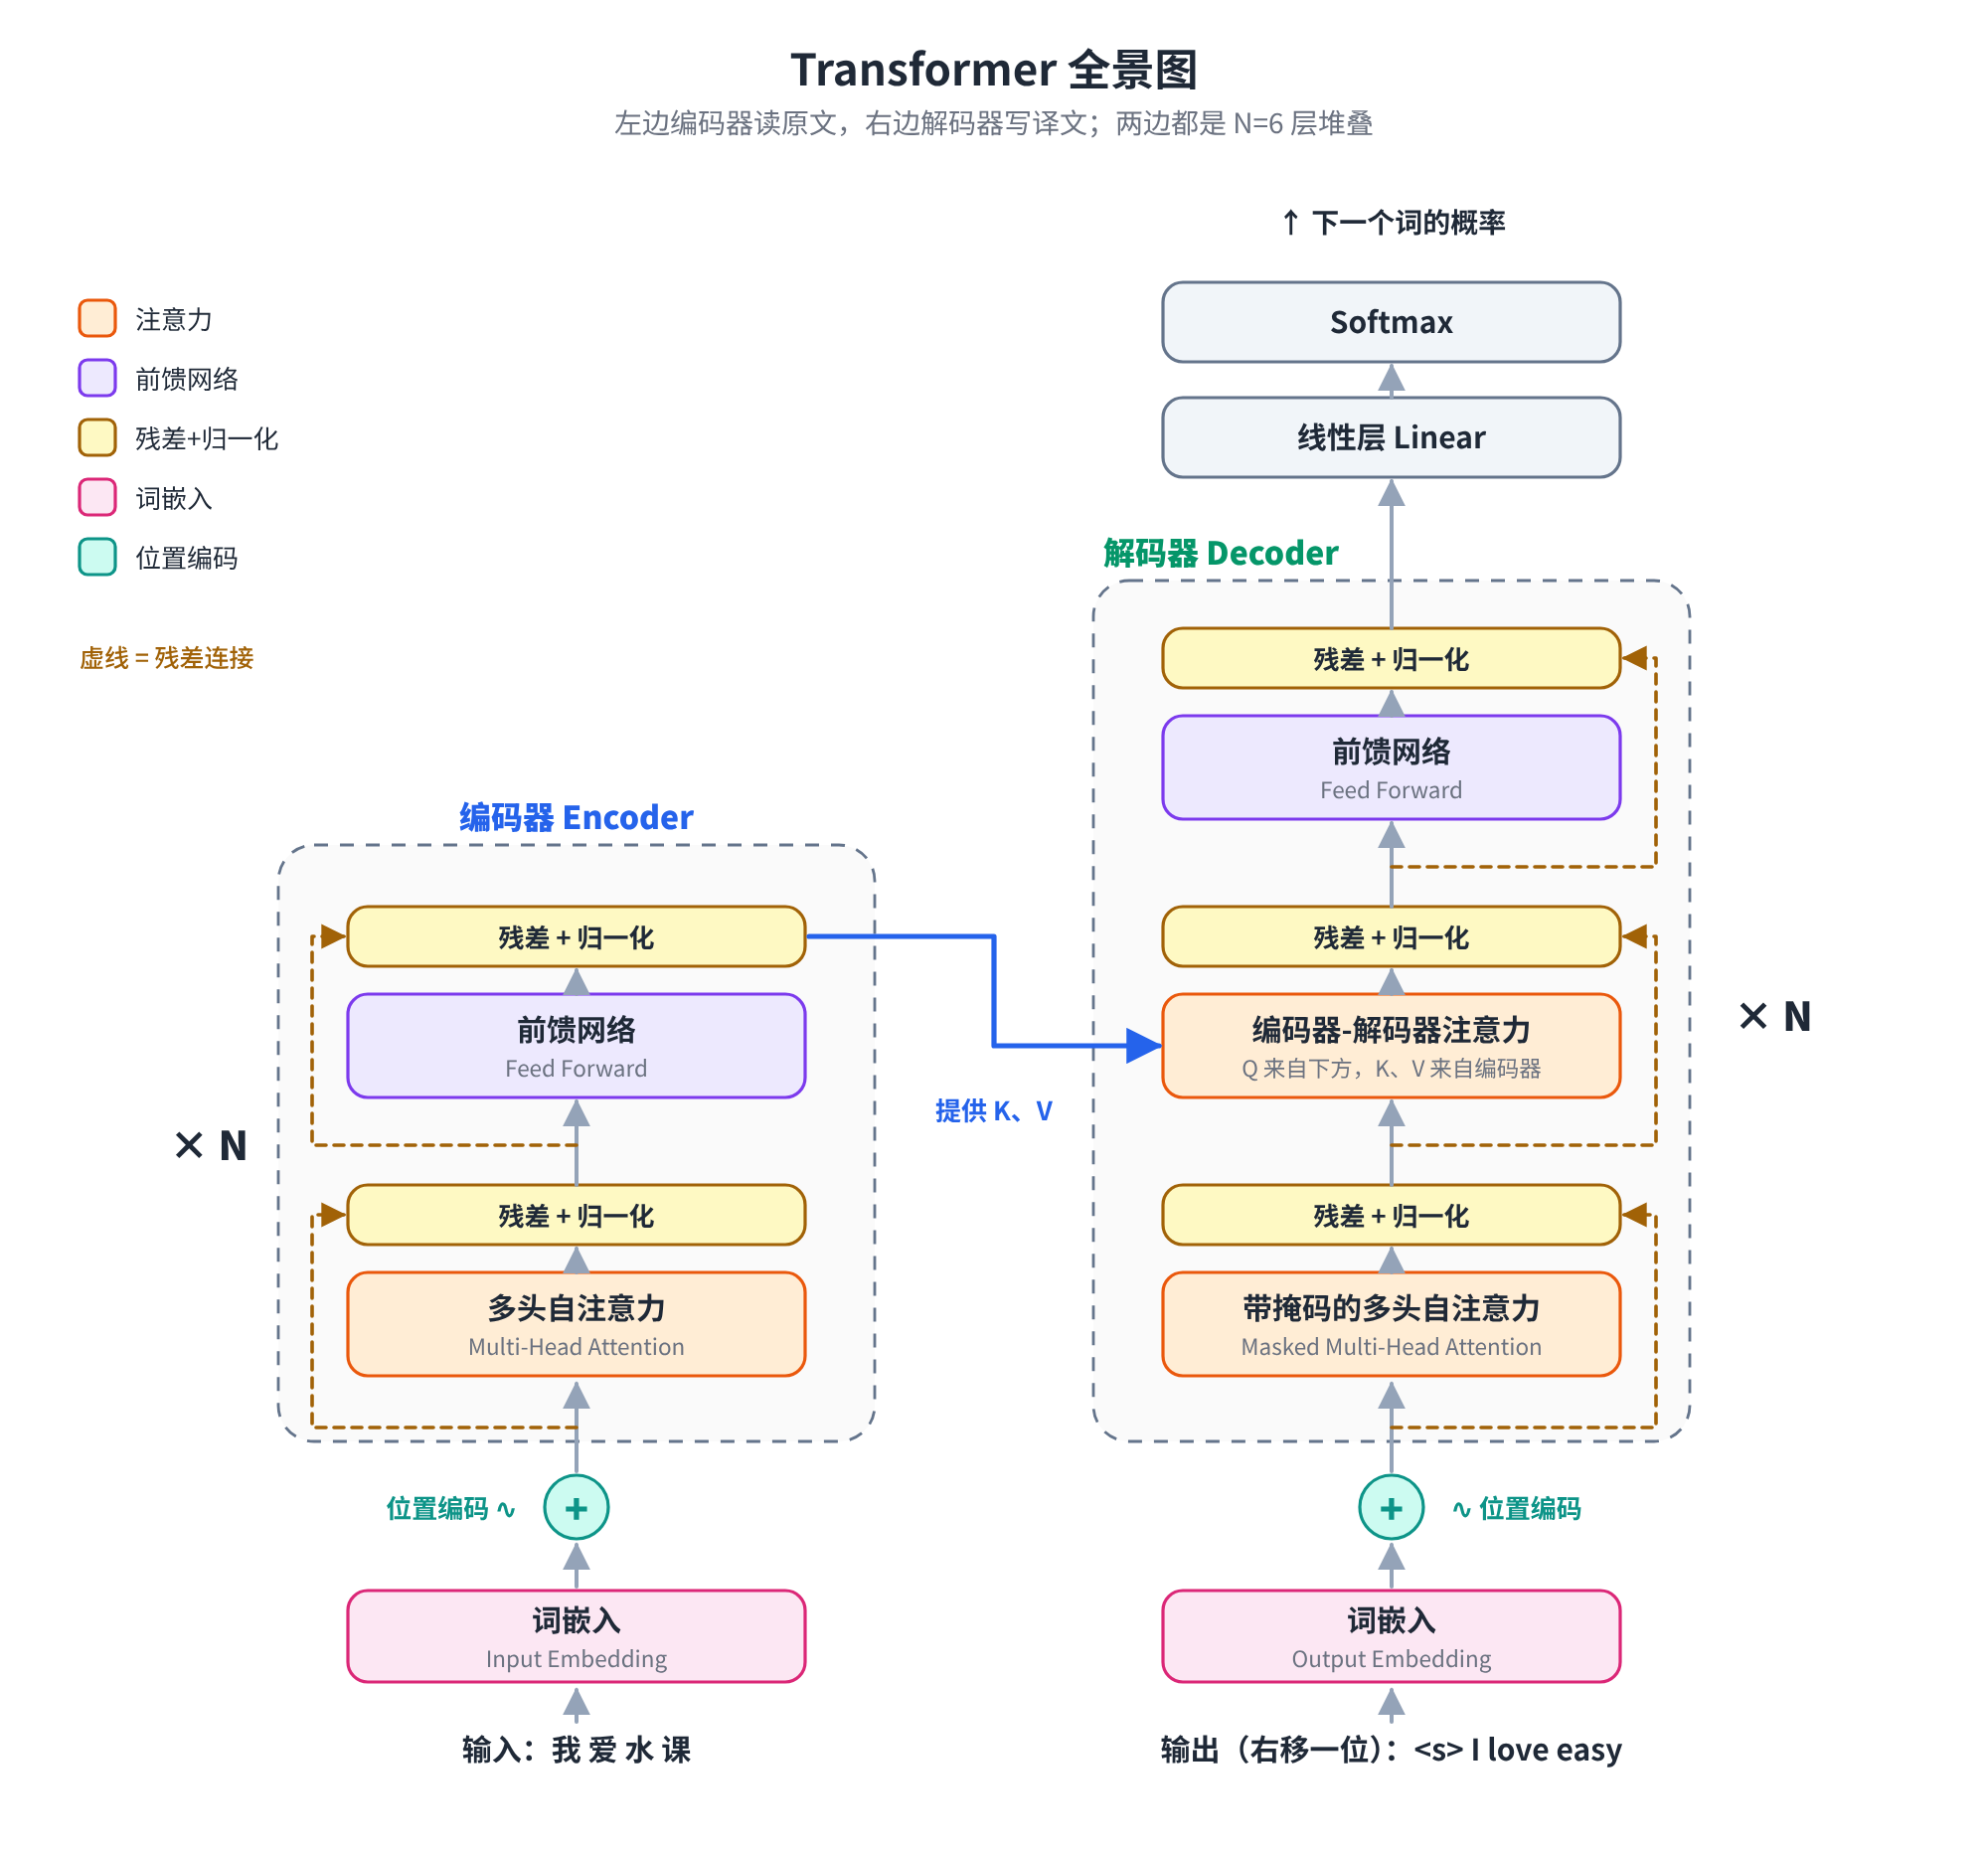
(这是按论文 Figure 1 重画的中文版。)
左边是编码器,读原文“我爱水课”;右边是解码器,读右移一位的答案“<s> I love easy”(<s> 是“开始”标记),输出下一个词的概率。
图看着复杂,其实新东西只有几块:
- 橙色:注意力模块,重中之重。编码器里有一个“多头自注意力”;解码器里有两个,一个“带掩码的多头自注意力”,一个“编码器-解码器注意力”。
- 紫色:前馈网络,就是第 1.3 节那个最朴素的 FNN。
- 黄色:残差连接 + 层归一化,深度学习的常规操作,让深层网络好训练。
- 粉色和青色:词嵌入和位置编码,是数据的入口。
框旁边的 “× N” 表示这一整块会重复堆叠 N 次,论文里 N = 6。为什么能随便叠?因为每一块的输入和输出形状完全一样(每个词都是 512 维),上一块的输出可以原封不动地当下一块的输入,想叠几层都行。
接下来,我们跟着“我爱水课”走一遍完整的训练流程。
2.3 第一步:词嵌入
“我爱水课”先经过词嵌入,每个词变成一个 512 维向量。四个词摞在一起,就是一个 4 × 512 的矩阵(4 行,每行一个词)。
这一步第 1.2 节已经讲过,不再重复。只补一个论文里的细节:Transformer 会把词嵌入向量乘以 $\sqrt{d_{model}} = \sqrt{512}$,而且编码器输入、解码器输入、以及最后输出层的线性变换,三者共享同一份权重矩阵。
2.4 第二步:位置编码
自注意力是“所有词同时看所有词”,这对计算来说是好事,但有一个副作用:它对顺序完全不敏感。如果你把“我爱水课”打乱成“课水爱我”,在没有位置信息的情况下,每个词算出来的结果和原来一模一样(只是换了个排列)。所以必须把位置信息显式地加进去。
2.4.1 为什么不直接写 1、2、3?
最自然的想法是给每个词附一个编号:第 1 个、第 2 个、第 3 个……但单独一个数字有几个麻烦:数值会随句子变长而无限增大,和词向量里那些量级很小的数字混在一起很不协调;模型训练时没见过的长度(比如第 1000 个位置),它就不知道该怎么处理;而且一个孤零零的标量,很难让模型通过向量运算去理解“第 3 个词和第 7 个词隔了多远”。
所以论文的做法是:给每个位置也生成一个 512 维的向量,然后直接加到词向量上。
2.4.2 正弦余弦编码
这个位置向量是用正弦、余弦函数算出来的:
$$ PE_{(pos,,2i)} = \sin!\left(\frac{pos}{10000^{2i/d_{model}}}\right), \qquad PE_{(pos,,2i+1)} = \cos!\left(\frac{pos}{10000^{2i/d_{model}}}\right) $$
$pos$ 是位置(第几个词),$i$ 是维度编号。偶数维用 sin,奇数维用 cos,不同维度的波长不同:从最短的 $2\pi$ 一路增长到最长约 $10000 \cdot 2\pi$。
公式看着吓人,画出来就直观了:
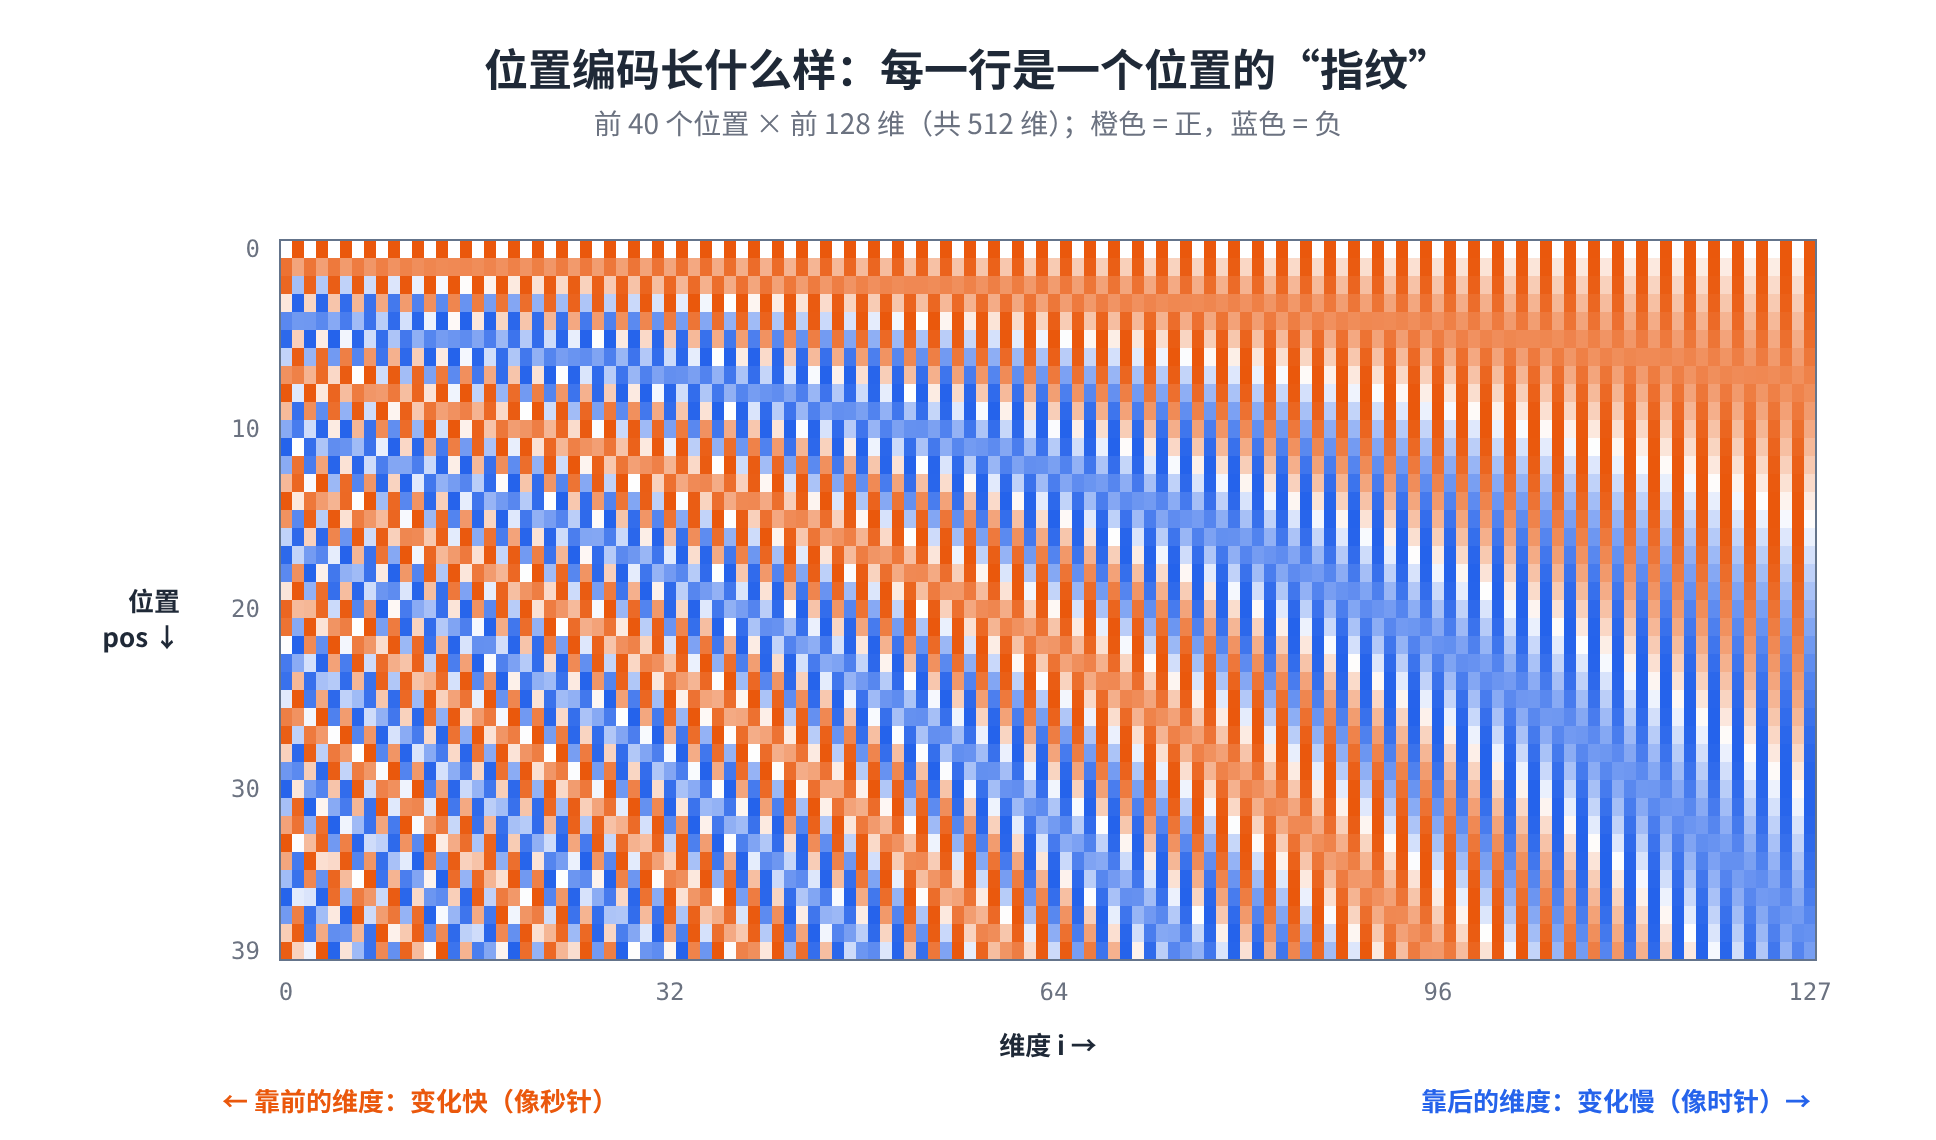
每一行是一个位置的编码。靠左的维度频率高,相邻位置之间变化剧烈,像钟表的秒针;靠右的维度频率低,要隔很多个位置才变一点,像时针。把所有指针的读数合在一起,就能唯一确定“现在几点”——也就是唯一确定这个位置。这其实和二进制计数很像:最低位每次都翻转,越高的位翻转得越慢。
举几个具体的数字(只看前 4 维):
| 位置 | 第 0 维 (sin) | 第 1 维 (cos) | 第 2 维 (sin) | 第 3 维 (cos) |
|---|---|---|---|---|
| 0(我) | 0.000 | 1.000 | 0.000 | 1.000 |
| 1(爱) | 0.841 | 0.540 | 0.822 | 0.570 |
| 2(水) | 0.909 | −0.416 | 0.936 | −0.351 |
| 3(课) | 0.141 | −0.990 | 0.245 | −0.970 |
所有数都在 −1 到 1 之间,不会随句子变长而爆炸。论文还给出了选择它的一个理由:对任意固定的偏移 $k$,$PE_{pos+k}$ 都可以表示成 $PE_{pos}$ 的线性函数(这是三角函数和角公式的性质),作者推测这能让模型更容易学会按“相对位置”去关注。论文同时说明,他们也试过让模型自己学一组位置向量(后来 BERT 就是这么做的),效果几乎一样;选正弦版本,是因为它也许能推广到比训练时更长的句子。
最后,位置编码和词嵌入直接相加:
$$ x_{\text{水}} = \text{Embedding}(\text{水}) + PE_{(2)} $$
就像给每个词贴了一个位置标签。现在,每个词的向量里既有“我是谁”,也有“我在哪”。还差最后一样:“我在这句话里是什么意思”。
2.5 第三步:自注意力,全文的重中之重
2.5.1 它要解决什么问题
回到词嵌入的那张地图。在词嵌入表里,“水”只有一个固定的位置——不管出现在哪句话里,查表得到的都是同一个向量。这显然不合理:
- “这西瓜水真多”里的“水”,应该往“水果”“水分”那边偏一点;
- “我爱水课”里的“水”,应该往“简单”“课程”那边偏一点。
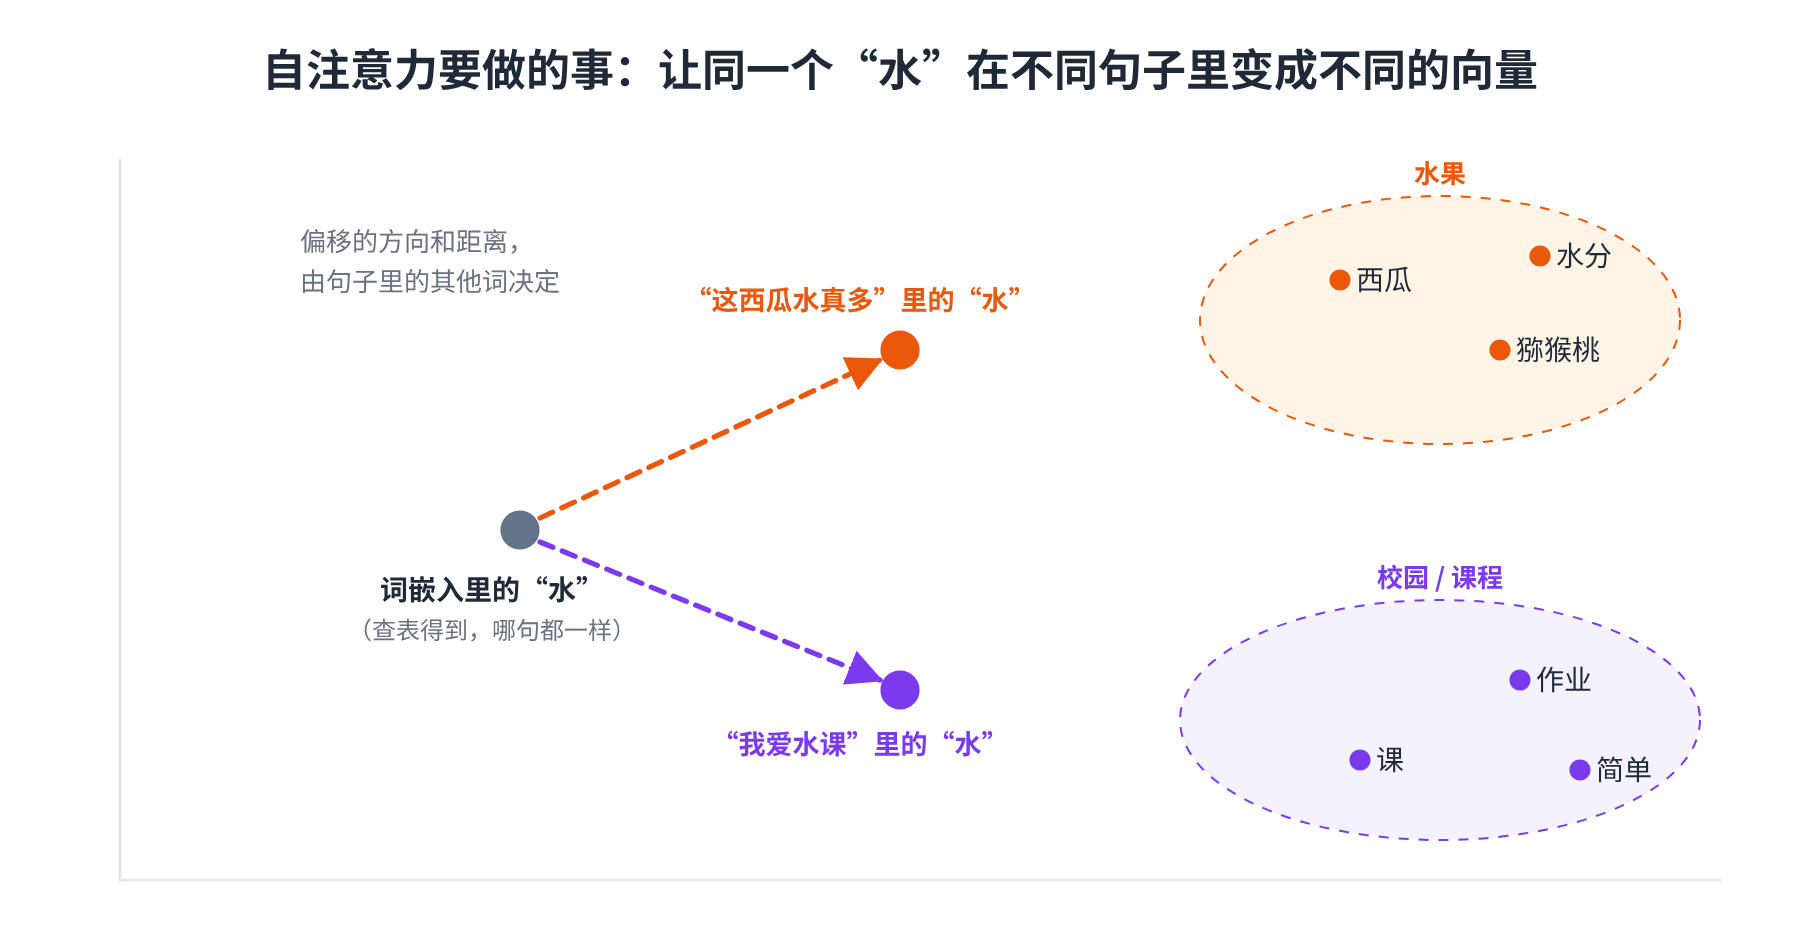
自注意力的任务,就是根据上下文给每个词的向量“挪个位置”。挪向哪里、挪多远,由句子里的其他词决定。挪完之后,两个“水”就不再是同一个向量,机器才算真正区分开了它们。
那具体怎么挪?答案是 Query、Key、Value 这一套。
2.5.2 每个词变出三个分身
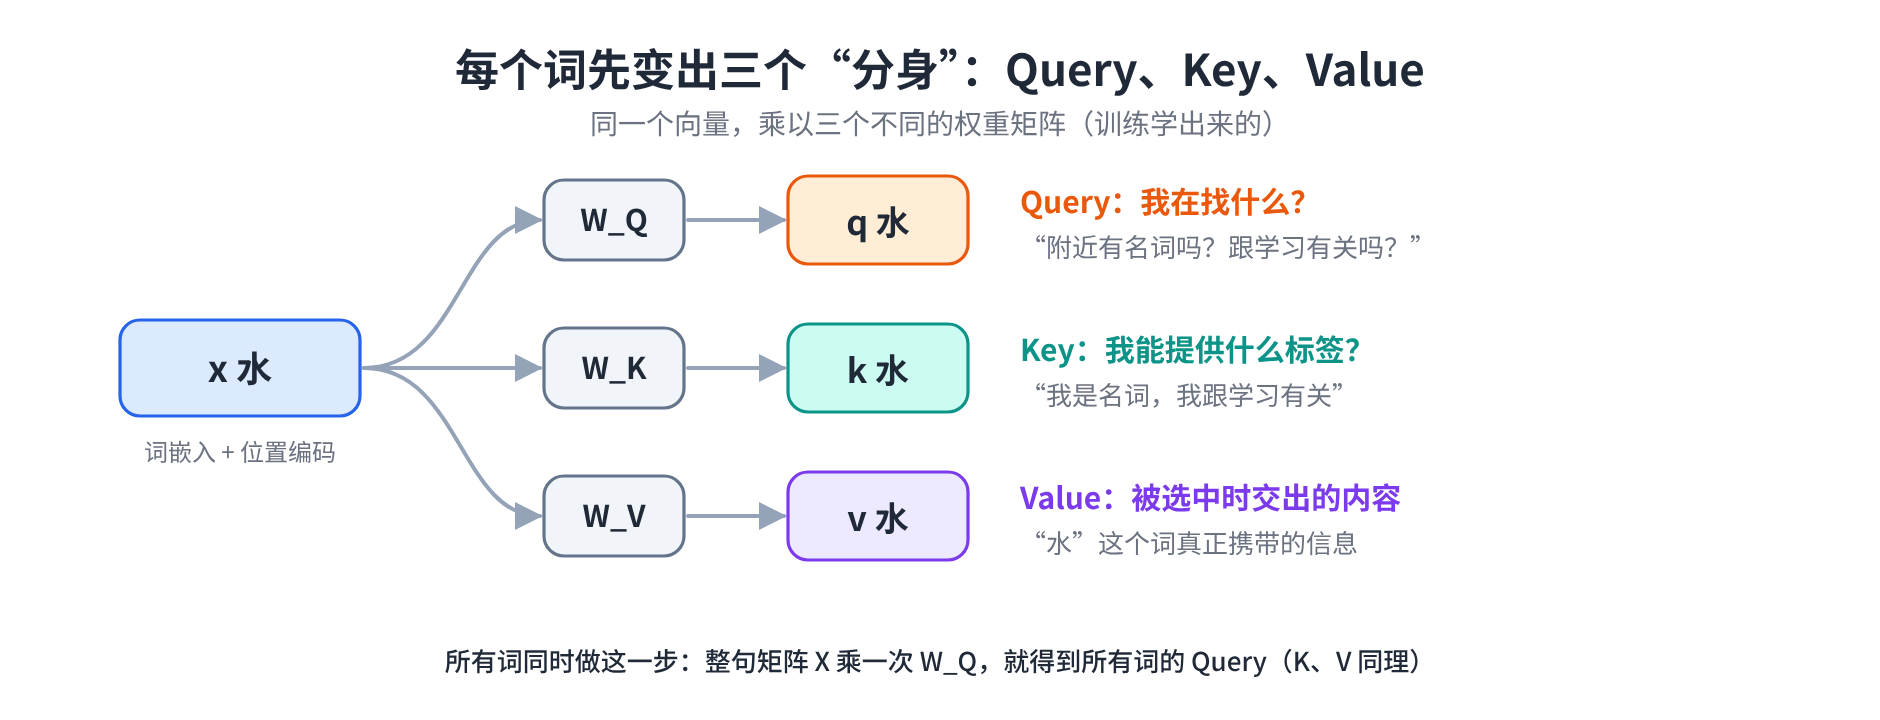
把“水”的向量 $x_{\text{水}}$(已经加过位置编码)分别乘以三个不同的权重矩阵 $W^Q$、$W^K$、$W^V$,得到三个新向量:
- Query(查询) $q_{\text{水}}$:可以理解成“水”发出的一个问题,比如“附近有名词吗?有和学习相关的词吗?”
- Key(键) $k_{\text{水}}$:可以理解成“水”挂在身上的标签,供别人的问题来匹配,比如“我是名词”。
- Value(值) $v_{\text{水}}$:“水”真正携带的内容,被别人选中时交出去的就是它。
一个好用的类比是图书馆检索:Query 是你在搜索框里输入的关键词,Key 是每本书的标签,Value 是书的内容。你用关键词和所有标签比对,越匹配的书,你读得越多。
当然,“附近有名词吗”只是帮助理解的拟人化说法。真实模型里,$W^Q$、$W^K$、$W^V$ 是训练出来的参数,每个维度具体在“问”什么,人类往往说不清。但效果上,它们确实学会了提出有用的问题、贴上有用的标签。
不只是“水”,句子里每个词都会得到自己的 q、k、v。而且这一步不用一个个算:把整句的 4 × 512 矩阵 $X$ 乘一次 $W^Q$,就同时得到了所有词的 Query,K 和 V 同理。这就是“并行”二字落到实处的样子——就是几次大矩阵乘法。
2.5.3 注意力公式
拿到 Q、K、V 之后,计算就是论文里最有名的那个公式,缩放点积注意力(Scaled Dot-Product Attention):
$$ \text{Attention}(Q, K, V) = \text{softmax}!\left(\frac{QK^{\top}}{\sqrt{d_k}}\right)V $$
拆开来只有四步:
- 打分:用每个词的 Query 和所有词的 Key 做点积。点积越大,说明“问题”和“标签”越匹配;
- 缩放:除以 $\sqrt{d_k}$($d_k$ 是 Key 向量的维度),原因稍后讲;
- 归一化:过一个 softmax,把分数变成一组非负、加起来等于 1 的权重;
- 加权求和:用这组权重给所有词的 Value 做加权平均,得到这个词的新向量。
2.5.4 手算一遍
光看公式不够直观,我们拿“水”来手算一遍。为了能用手算,把向量缩到只有 4 维(所以 $d_k = 4$,$\sqrt{d_k} = 2$),数字都是为了演示编出来的:
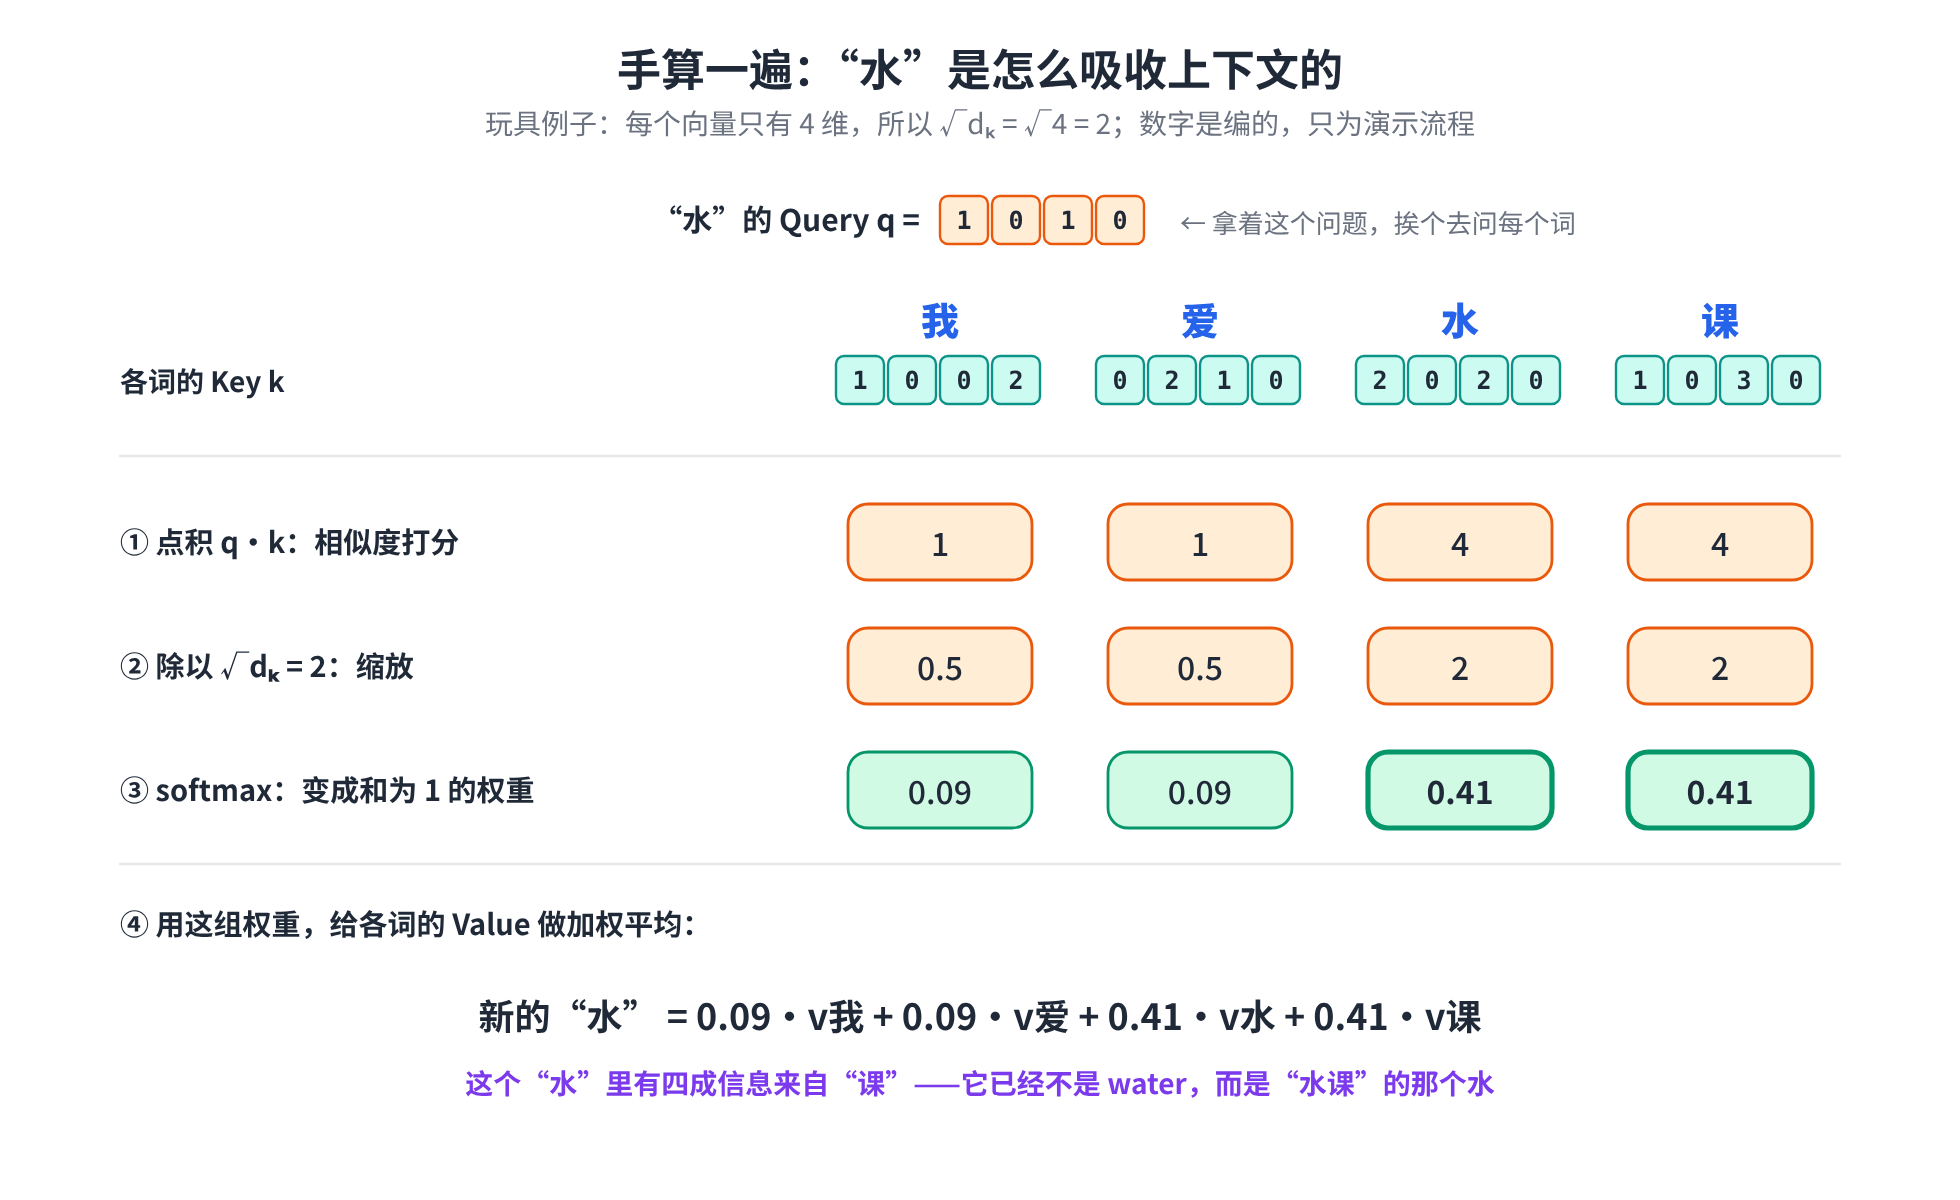
“水”的 Query 是 $q_{\text{水}} = [1, 0, 1, 0]$,四个词的 Key 分别是:
| 我 | 爱 | 水 | 课 | |
|---|---|---|---|---|
| Key | [1, 0, 0, 2] | [0, 2, 1, 0] | [2, 0, 2, 0] | [1, 0, 3, 0] |
① 打分。点积就是对应位置相乘再相加,比如 $q_{\text{水}} \cdot k_{\text{课}} = 1\times1 + 0\times0 + 1\times3 + 0\times0 = 4$。四个分数是 $[1, 1, 4, 4]$。
② 缩放。都除以 2,得到 $[0.5, 0.5, 2, 2]$。
③ softmax。softmax 的做法是:先对每个数取指数 $e^x$,再除以它们的总和。
$$ e^{0.5} \approx 1.649,\quad e^{2} \approx 7.389,\quad \text{总和} = 2\times1.649 + 2\times7.389 = 18.076 $$
$$ \text{权重} = \left[\tfrac{1.649}{18.076},\ \tfrac{1.649}{18.076},\ \tfrac{7.389}{18.076},\ \tfrac{7.389}{18.076}\right] \approx [0.09,\ 0.09,\ 0.41,\ 0.41] $$
取指数有两个好处:结果一定是正数;原来大的分数会被拉得更大,差距更明显。
④ 加权求和。
$$ \text{新的“水”} = 0.09,v_{\text{我}} + 0.09,v_{\text{爱}} + 0.41,v_{\text{水}} + 0.41,v_{\text{课}} $$
新的“水”向量里,有四成多的信息来自“课”。它已经不是孤零零的 water,而是带着“课”的语境的那个“水”。这和第 1.6 节注意力机制的加权平均是同一个思想,只不过这次是句子内部的词互相关注,所以叫“自”注意力(self-attention):Q、K、V 全都来自同一个句子自己。
2.5.5 整句一起算
上面只算了“水”这一行。实际计算中,四个词是同时算的:$QK^\top$ 一次就得到一张 4 × 4 的分数表,softmax 按行归一化,再乘以 $V$,所有词的新向量一起出炉。
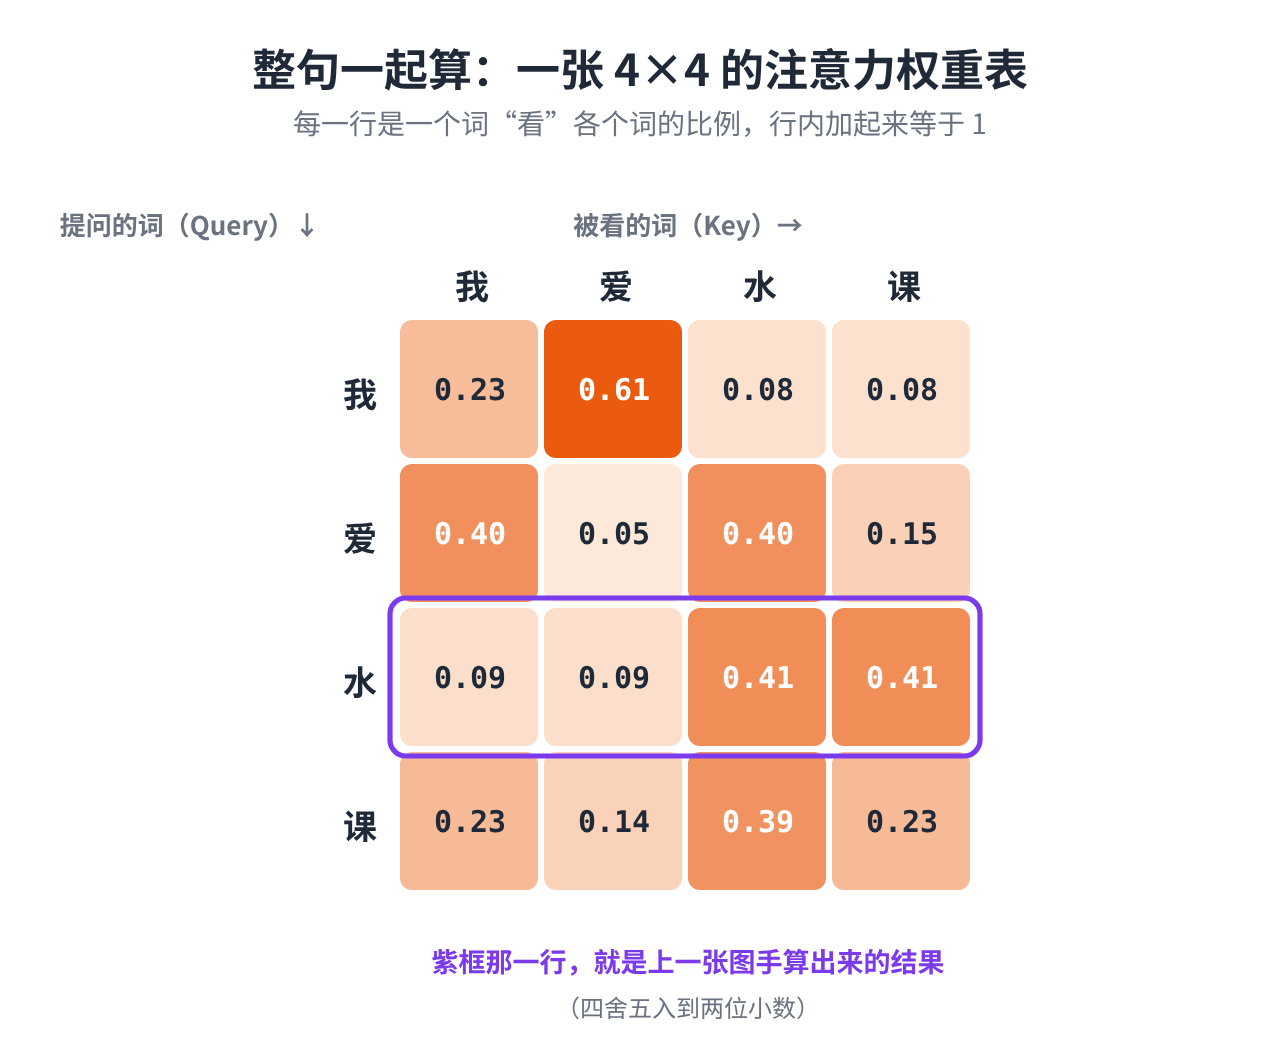
每一行是一个词“看”所有词的比例。比如“我”这一行,最关注“爱”(0.61),可以理解为“我”在找它的动作;“课”这一行,最关注“水”(0.39),可以理解为“课”在找修饰它的词。这张表还有一个额外的好处:它可以直接画出来看,帮助人理解模型“在想什么”,论文第 4 节专门提到了这一点。
2.5.6 为什么要除以 √dₖ
这是论文里专门解释的一个细节,也是面试常考题。
假设 q 和 k 的每个分量都是均值 0、方差 1 的随机数,那么它们的点积 $q \cdot k = \sum_{i=1}^{d_k} q_i k_i$ 是 $d_k$ 个随机数之和,均值为 0,方差为 $d_k$。$d_k$ 越大,点积的数值就越“野”。在 64 维时,点积的标准差约为 8;在 512 维时约为 22.6。
数值太大,softmax 就会“饱和”。举个例子,三个分数 $[22, 11, 5]$ 过 softmax,结果约是 $[0.99998,\ 0.00002,\ 0.0]$:几乎所有权重都压在第一个上,其他位置几乎被无视。更糟的是,这时 softmax 的梯度极小,模型很难通过训练去调整它——像是一个开关卡死在一端。
除以 $\sqrt{d_k}$ 之后,点积的方差被拉回 1。同样的分数除以 $\sqrt{512} \approx 22.6$,softmax 的结果是 $[0.48,\ 0.29,\ 0.23]$,权重分布得柔和多了,训练也更顺畅。
论文还对比了另一种常用的“加性注意力”(additive attention,Bahdanau 用的那种,拿一个小神经网络来算分数)。两者理论复杂度差不多,但点积注意力可以直接用高度优化的矩阵乘法实现,更快也更省内存。缩放这一步,就是为了在 $d_k$ 较大时补上点积注意力的短板。
2.6 多头注意力:八个小专家,各看一个侧面
前面讲的是“单头”注意力:$W^Q$、$W^K$、$W^V$ 都是 512 × 512,“我爱水课”的 4 × 512 矩阵乘过去,Q、K、V 都还是 4 × 512,注意力的输出也是 4 × 512。
而 Transformer 实际用的是多头注意力(Multi-Head Attention):
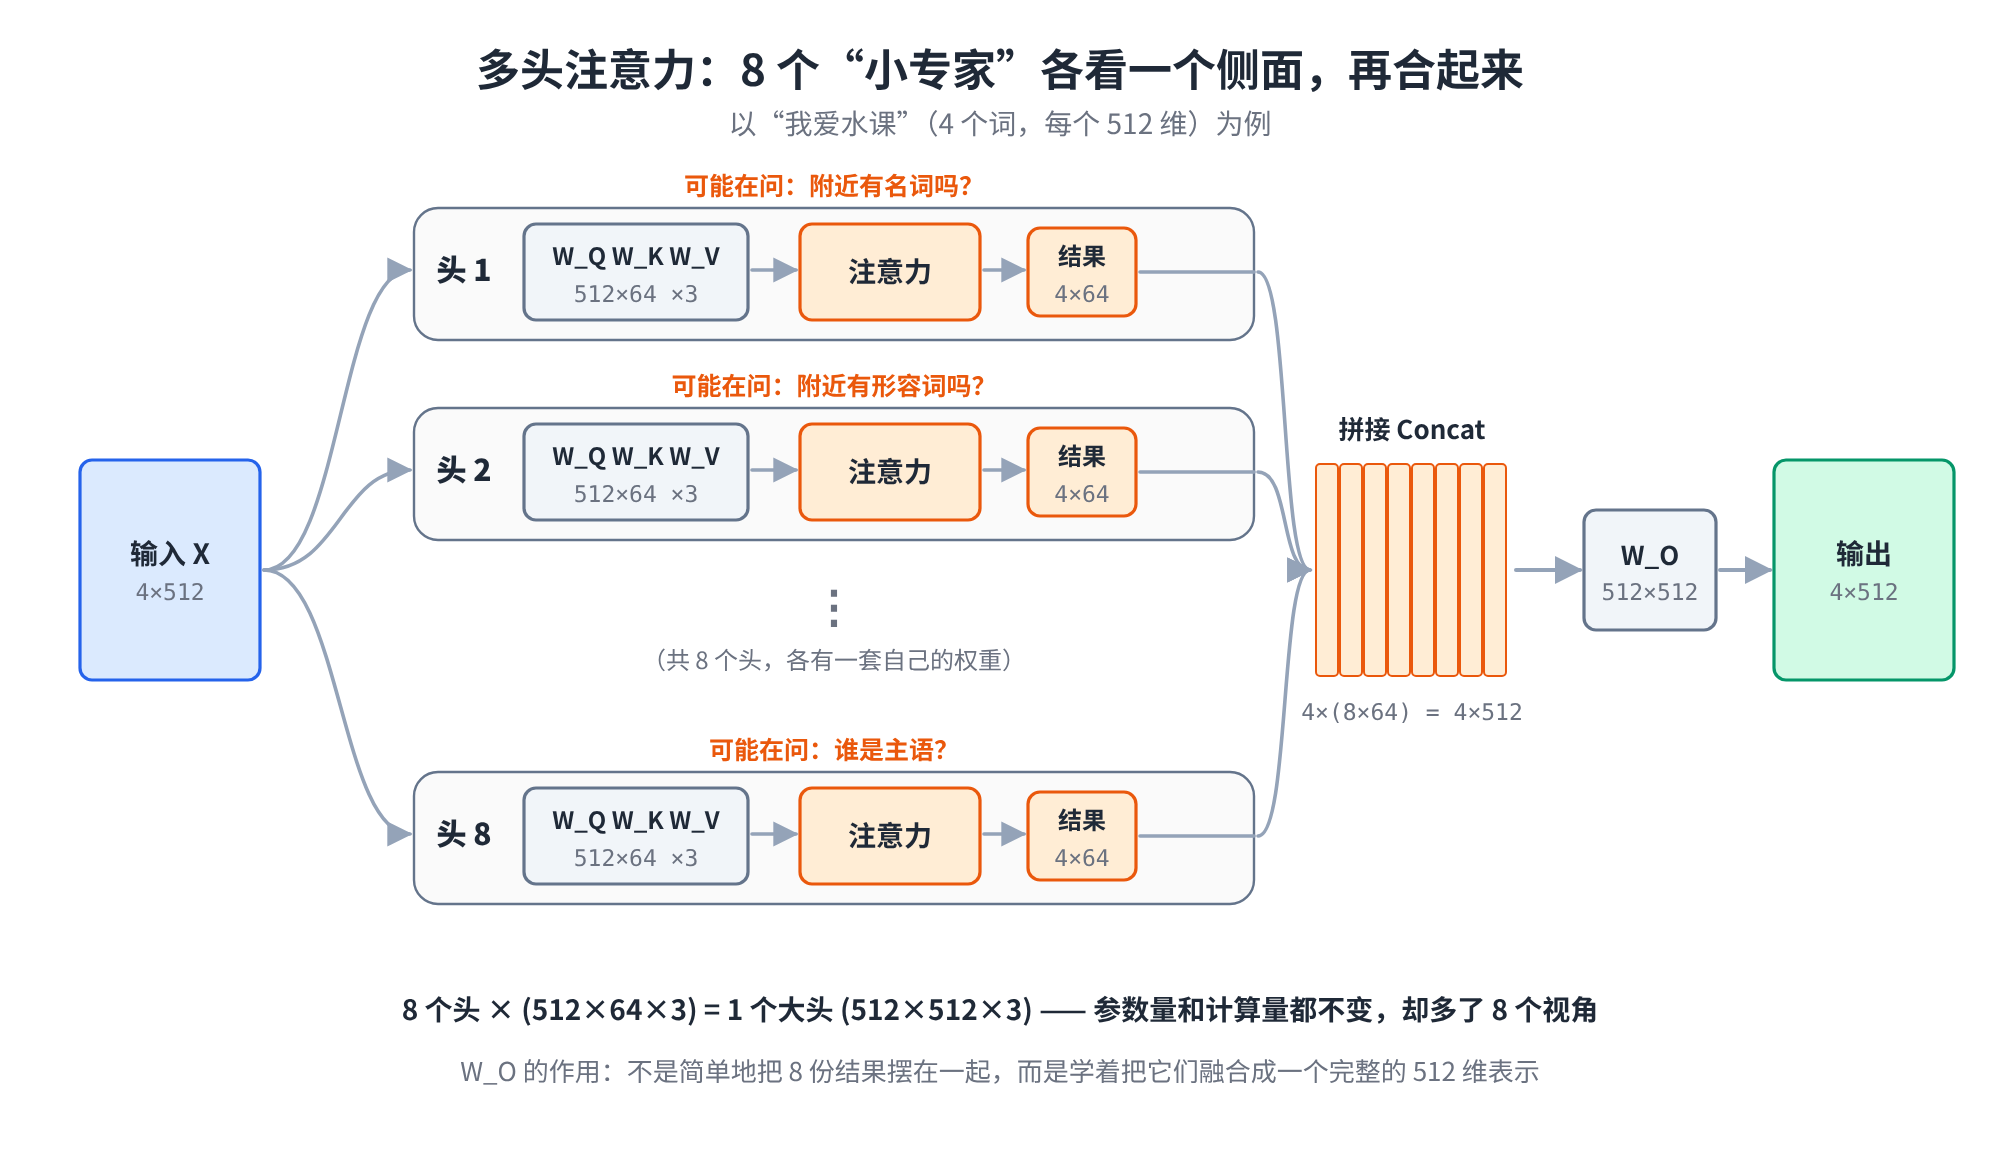
- 准备 8 组权重矩阵,每组的 $W^Q_i$、$W^K_i$、$W^V_i$ 都是 512 × 64;
- 每组各自算出 4 × 64 的 Q、K、V,各自做一遍注意力,得到 4 × 64 的结果——这就是一个“头”;
- 把 8 个头的结果拼接起来:8 × 64 = 512,又回到 4 × 512;
- 最后再乘一个 512 × 512 的矩阵 $W^O$,得到最终输出。
写成公式是:
$$ \text{MultiHead}(Q,K,V) = \text{Concat}(\text{head}_1, \ldots, \text{head}_8),W^O,\qquad \text{head}_i = \text{Attention}(QW^Q_i,\ KW^K_i,\ VW^V_i) $$
这里自然冒出三个问题。
为什么要拆成多个头? 回想一下 512 维空间:你可以想象每个方向代表词的某种特征。视频里举了个很生动的例子,用 512 维描述“汉堡”和“菠萝”:有的维度表示甜不甜、辣不辣、咸不咸(口味),有的表示脂肪、碳水的含量(热量),有的表示维生素含量(营养)。从 512 维投影到 64 维,相当于每个头只抽取出一个“子空间”来看:第一个头可能只关注口味,第二个只关注热量,第三个只关注营养。
放到语言上,就是每个头可以学着问不同的问题:一个头关心“附近有没有名词”,一个头关心“谁是主语”,一个头关心“哪个词在修饰我”。单头注意力只能得出一组权重,很难同时兼顾这么多种关系;多头则让模型能从多个角度同时理解同一句话,论文原话是 “jointly attend to information from different representation subspaces at different positions”。
为什么拼起来之后还要乘一个 $W^O$? 拼接只是把 8 份结果首尾摆在一起,每一份都是在自己的小子空间里独立算出来的,彼此之间没有任何交流。视频打了个比方:8 张低清的小图拼在一起,并不等于一张高清大图。$W^O$ 的作用就是学着把这 8 个视角的信息融合起来,重新投影成一个完整的 512 维表示。
为什么是 8 个 64 维,而不是 8 个 512 维? 算一笔账就明白了:
$$ 8 \times (512 \times 64 \times 3) = 786{,}432 = 1 \times (512 \times 512 \times 3) $$
8 个 64 维的小头,参数量和计算量跟 1 个 512 维的大头完全一样。如果每个头都用 512 维,计算量就要翻 8 倍。拆成 8 × 64,等于不花额外成本,白得了 8 个视角。至于为什么偏偏是 512、8、64,这些都是超参数,是作者试出来效果好的取值,换成别的也能训练。
2.7 残差连接、层归一化与前馈网络
多头注意力之后,紧跟着一个“Add & Norm”,然后是前馈网络,再一个 “Add & Norm”。
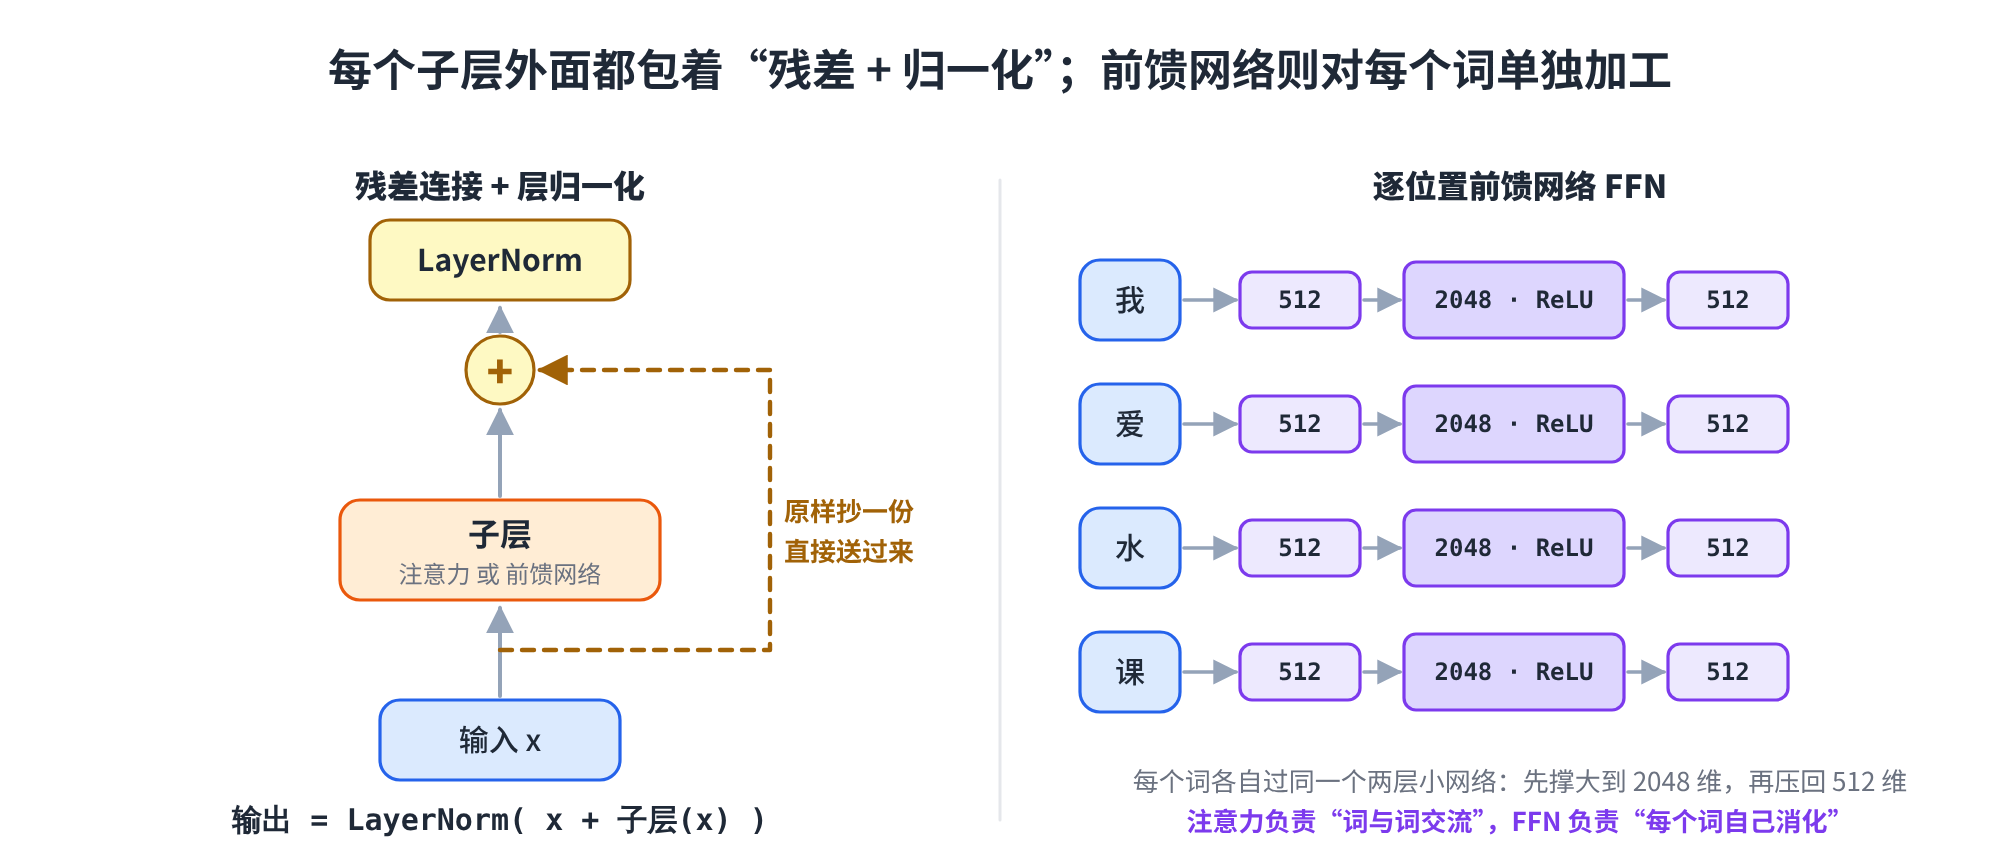
残差连接(Residual Connection)就是图里那条“抄近路”的虚线:把子层的输入 $x$ 原样抄一份,直接加到子层的输出上。
$$ \text{输出} = \text{LayerNorm}\big(x + \text{Sublayer}(x)\big) $$
为什么要这样?设想某个子层学得很差,把输入扭曲得面目全非,后面的层再怎么努力,拿到的也只是一堆被搅乱的东西。有了残差连接,不管这个子层学得如何,原始信息都有一条保底通道能继续往下传。子层只需要学“在原来基础上补充点什么”,而不是“从零重建一切”。这在网络很深时尤其关键,Transformer 的编码器和解码器加起来有 30 个子层,靠的就是它才能稳定训练。
层归一化(Layer Normalization)则是把每个词向量的数值重新调整到均值 0、方差 1 附近,让数值保持稳定,方便训练。
前馈网络(Feed-Forward Network)就是第 1.3 节那个最朴素的两层网络:
$$ \text{FFN}(x) = \max(0,\ xW_1 + b_1),W_2 + b_2 $$
先把 512 维撑大到 2048 维,过一个 ReLU(负数变 0,正数不变),再压回 512 维。论文强调它是“逐位置”(position-wise)的:每个词单独、各自过一遍同一个网络,词与词之间在这里不交流。
可以这么分工理解:注意力负责“词与词之间交流信息”,前馈网络负责“每个词把收集到的信息自己消化一下”,并引入更多的非线性和参数,增强模型的表达能力。
经过“注意力 → Add & Norm → FFN → Add & Norm”,形状依然是 4 × 512,于是可以再送进下一层。重复 6 次,编码器的工作就完成了:最终得到的 4 × 512 矩阵,每一行都是一个融合了词义、位置和整句上下文的向量。
2.8 解码器:掩码,与“去原文里找答案”
解码器的流程和编码器大同小异:答案 “<s> I love easy” 进来,过词嵌入、位置编码,然后进入 6 层堆叠的模块。区别在于两处。
2.8.1 带掩码的自注意力:防作弊
训练时我们把整句答案一次性给了解码器。如果不加限制,预测 “easy” 的时候,模型直接看一眼输入里的 “easy” 就能答对——这是作弊,学不到任何东西。而且在真正使用时,后面的词还没生成,根本没得看。
所以解码器的第一个自注意力加了掩码(mask):
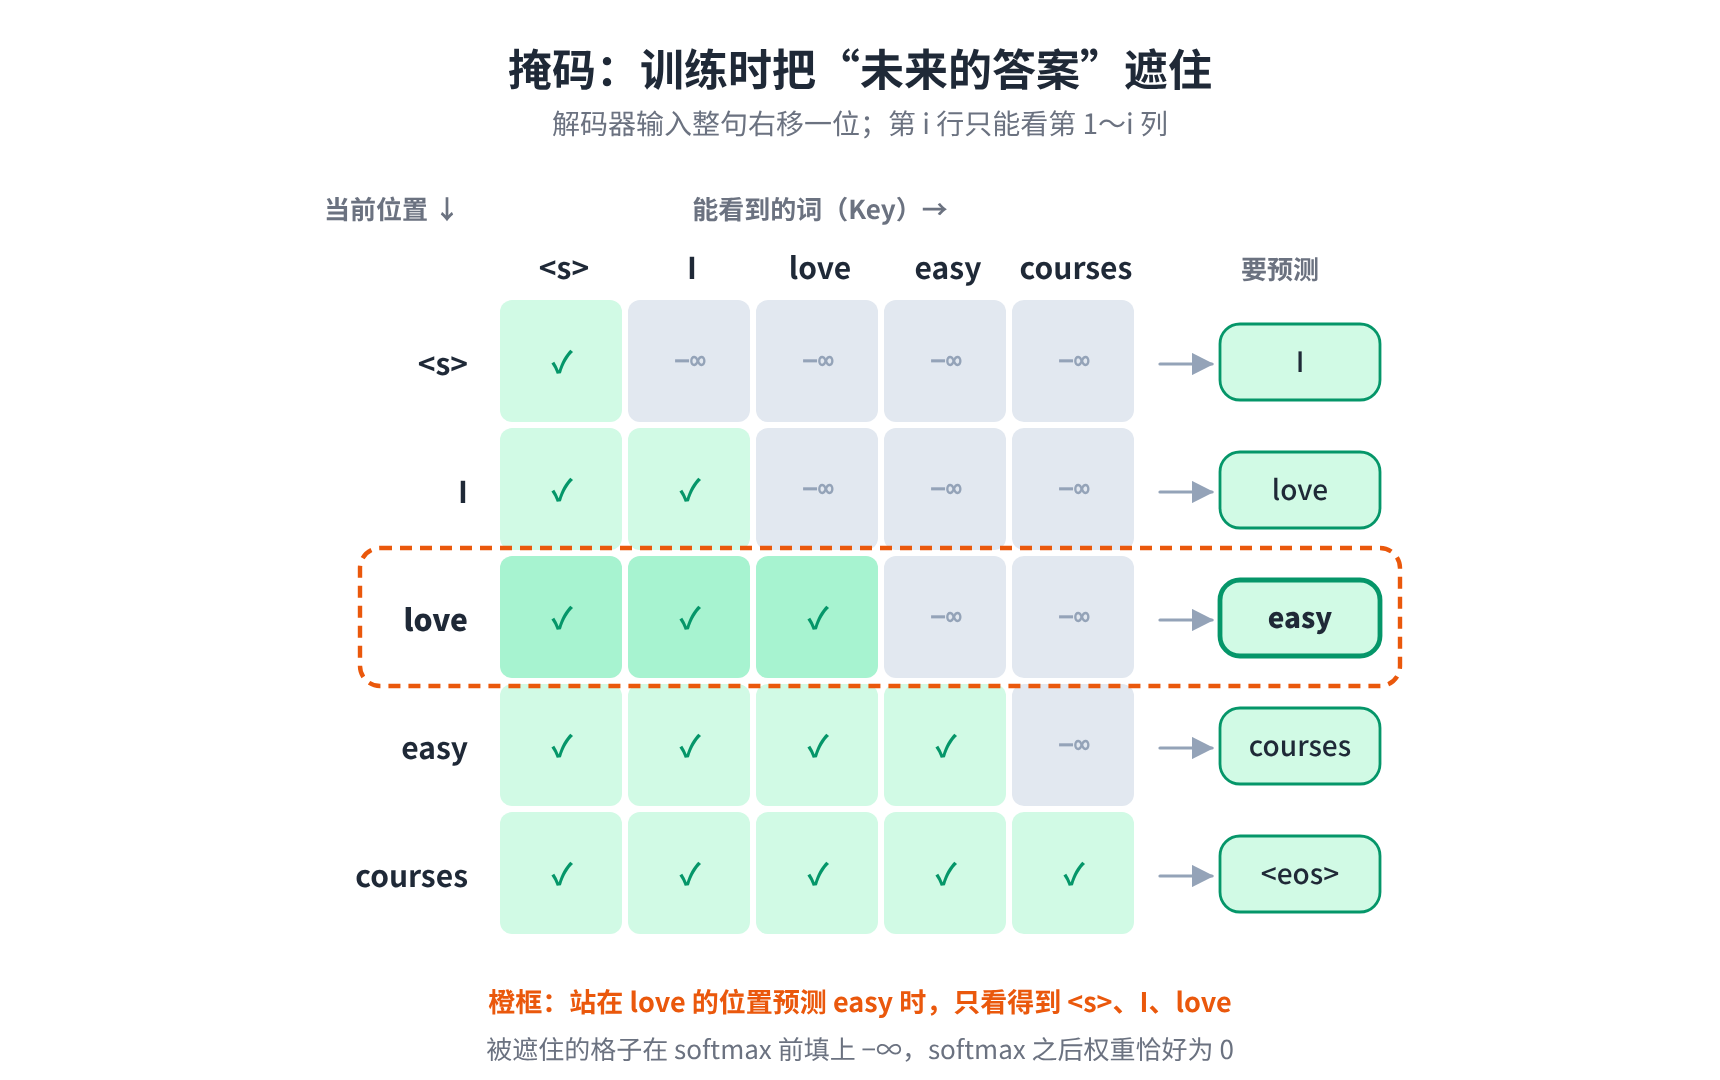
解码器的输入是整句答案右移一位(前面补一个开始符 <s>),每个位置的任务是预测下一个词。在注意力的分数表里,第 $i$ 行只允许看第 1 到第 $i$ 列,右上角的格子全部遮掉。站在 “love” 的位置预测 “easy” 时,它只看得到 <s>、I、love。
具体实现是:在 softmax 之前,把被遮住的位置的分数设为 $-\infty$。因为 $e^{-\infty} = 0$,softmax 之后这些位置的权重恰好是 0,也不影响其他位置的权重加起来等于 1。(注意不是把分数设为 0:分数为 0 时 $e^0 = 1$,那个位置照样能分到权重。)
2.8.2 编码器-解码器注意力:译文拿着问题,去原文里找答案
解码器每一层的第二个注意力模块,和前面的“自”注意力不同,它的 Q 和 K、V 来自两个地方:
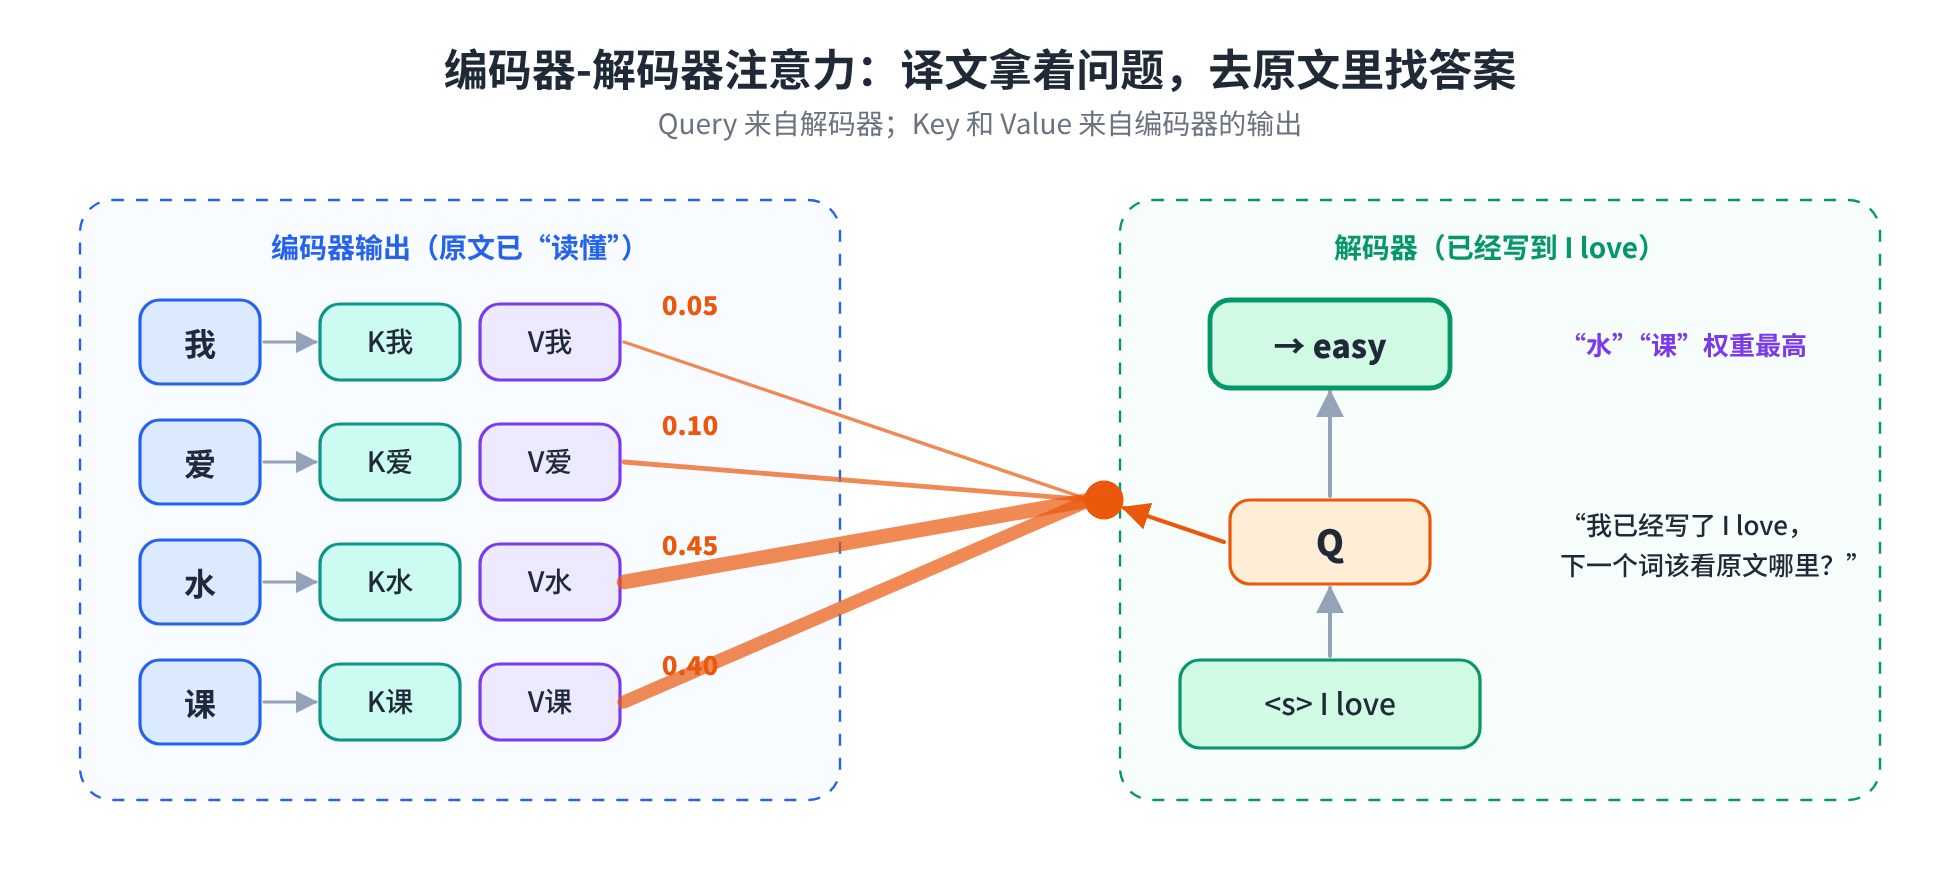
- Query 来自解码器自己(下面那层的输出),可以理解为:“我已经写了 I love,下一个词该看原文的哪里?”
- Key 和 Value 来自编码器的最终输出,也就是“已经读懂了的原文”。
计算方式还是那个公式,只是“提问的人”和“被问的人”分属两个句子。这一步就是第 1.6 节那个经典注意力机制在 Transformer 里的化身:译文的每个位置,都去原文里找自己最该关注的部分。这一层在论文里叫 “encoder-decoder attention”,现在也常叫交叉注意力(cross-attention)。
至此,Transformer 中多头注意力的三种用法都出场了(论文 3.2.3 节):
- 编码器里的自注意力:原文的每个词看原文的所有词;
- 解码器里的带掩码自注意力:译文的每个词只看它自己和它前面的词;
- 编码器-解码器注意力:译文的每个词去看原文的所有词。
之后照例是 Add & Norm、前馈网络、Add & Norm,重复 6 层。
2.9 最后一步:从向量到单词
解码器最终输出的,仍然是每个位置一个 512 维向量。它代表“模型认为这个位置该填的词”的语义,但还不是一个具体的词。最后还要两步:
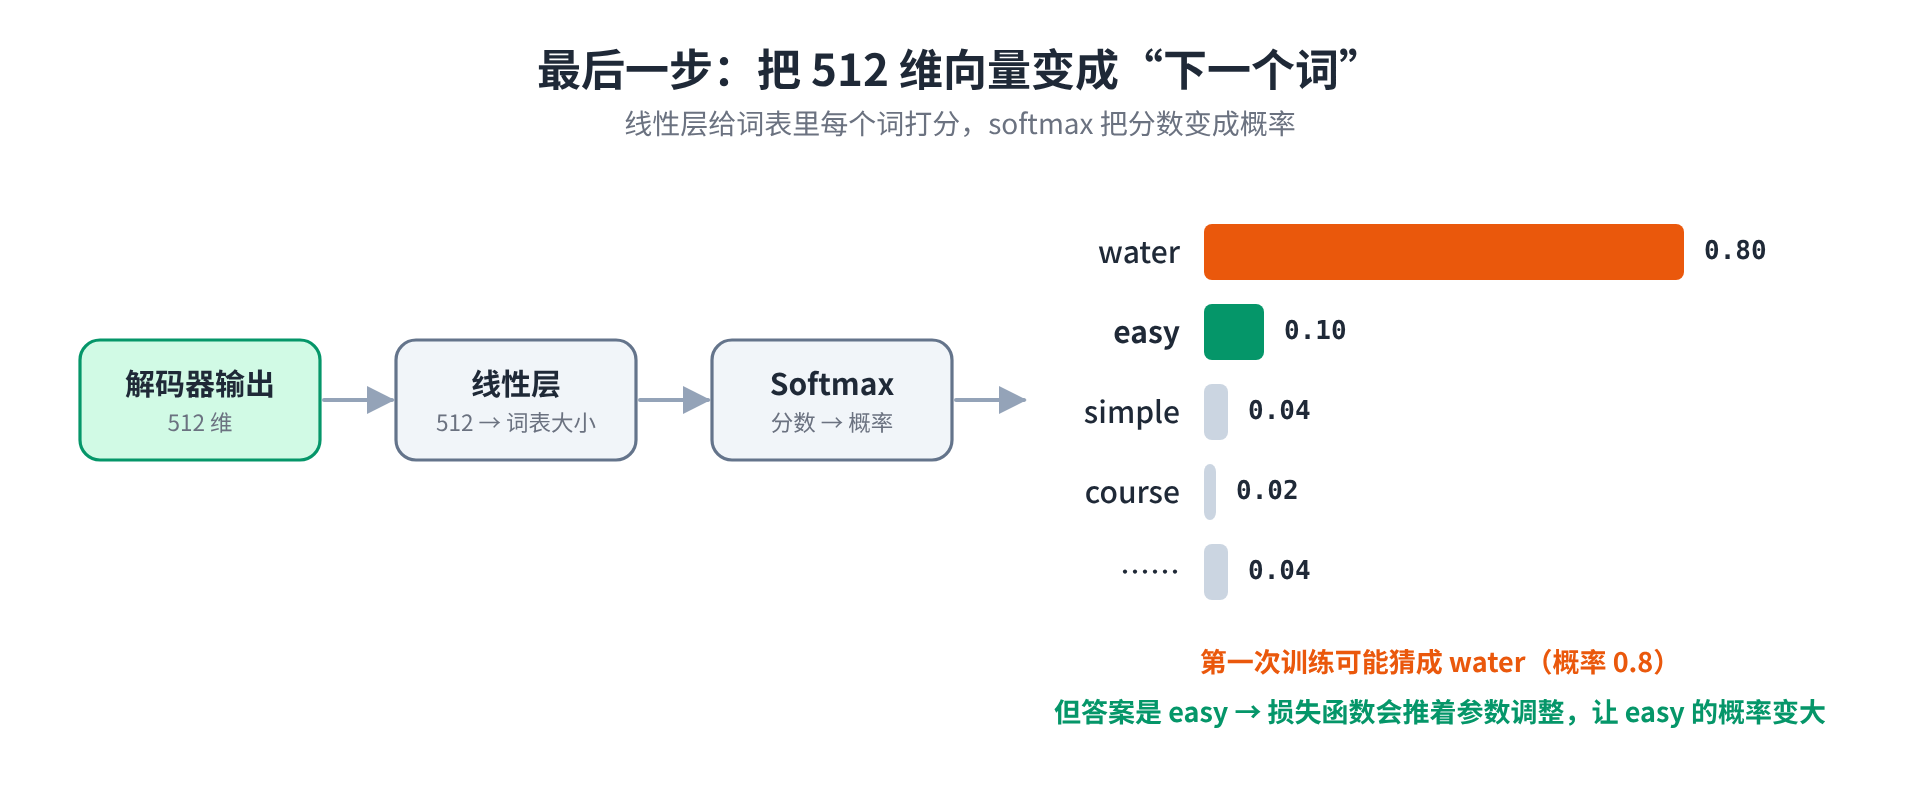
线性层做一次维度变换,把 512 维映射到“词表大小”那么多维。假设词表里有 3 万个词,就得到一个 3 万维的向量,每一维是对应那个词的得分。(论文的英德翻译实验用的是约 37000 个子词单元的共享词表。)
softmax 再把这些得分变成概率。得分本身没有统一的尺度,10 分算高还是算低,取决于其他词的分数;变成概率后,所有词的可能性加起来等于 1,一目了然。
刚开始训练时,模型在 “easy” 这个位置可能给出“water 的概率 0.8,easy 的概率 0.1”。但标准答案是 easy,于是损失函数会衡量预测和答案之间的差距,再通过反向传播去调整模型里所有的参数——词嵌入表、$W^Q$、$W^K$、$W^V$、$W^O$、前馈网络的权重……让下一次 easy 的概率更高一点。成千上万次之后,模型就学会了:“水”后面跟着“课”时,它是 easy,不是 water。
2.9.1 训练和推理的区别
这里正好把第 2.1 节埋的伏笔收回来:
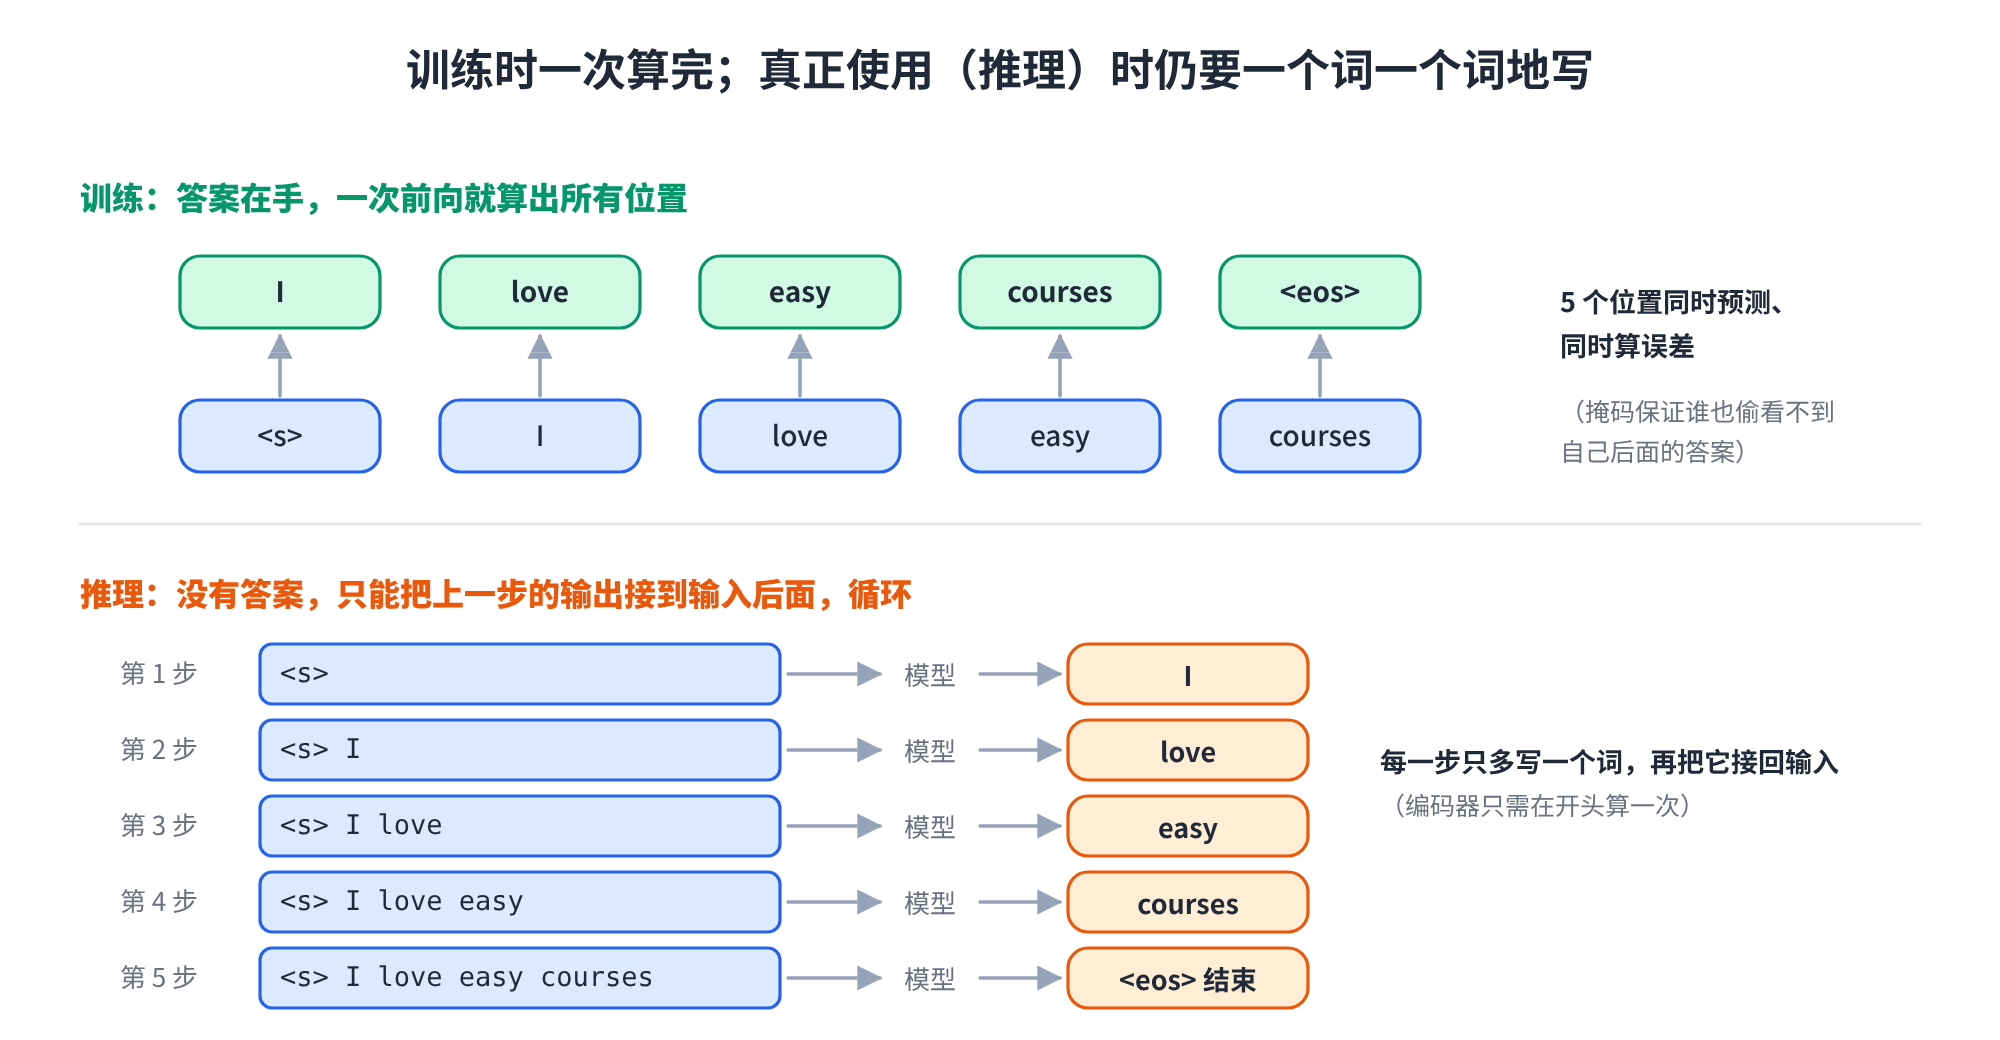
训练时,答案在手,配合掩码,5 个位置的预测在一次前向计算里同时完成、同时算误差。
推理时(训练好之后真正拿来用),没有答案。只能先输入 <s>,让模型预测出 “I”;把 “I” 接到输入后面,再预测出 “love”;再接上,预测 “easy”……直到模型输出结束符 <eos>。这种“把自己的输出当成下一步输入”的方式叫自回归(auto-regressive)。编码器只需要在开头把原文算一次,之后每一步只跑解码器。
你在用 ChatGPT 或 Claude 时,看到回答是一个字一个字“蹦”出来的,原因正在于此。
3 回到主线:为什么这是一场革命
现在终于可以回答开头的问题了。论文第 4 节 “Why Self-Attention” 从三个角度,把自注意力和循环层、卷积层做了对比:
| 层类型 | 每层计算复杂度 | 必须串行的操作数 | 任意两位置间最长路径 |
|---|---|---|---|
| 自注意力 | $O(n^2 \cdot d)$ | $O(1)$ | $O(1)$ |
| 循环(RNN) | $O(n \cdot d^2)$ | $O(n)$ | $O(n)$ |
| 卷积(CNN) | $O(k \cdot n \cdot d^2)$ | $O(1)$ | $O(\log_k n)$ |
($n$ 是序列长度,$d$ 是向量维度,$k$ 是卷积核大小。来自论文 Table 1。)
第一,每层的计算量。 自注意力要算所有词两两之间的分数,所以和 $n^2$ 成正比;RNN 每一步要做一次 $d \times d$ 的矩阵乘法,所以和 $n \cdot d^2$ 成正比。当句子长度 $n$ 小于向量维度 $d$ 时(论文那个年代的机器翻译,句子通常也就几十个词,而 $d = 512$),自注意力反而更省。
第二,能不能并行。 这是最关键的一列。RNN 必须串行 $n$ 步,自注意力不管句子多长,都是常数步——就是几次矩阵乘法,GPU 一口气全算完。这条瓶颈的突破意义重大:今天的大模型动辄用整个互联网规模的文本训练,如果还像 RNN 那样一步一步地等,根本不可能训练得完。能并行,才能堆数据、堆算力、堆参数,才有了后来的“大”模型。
第三,学习长距离依赖的能力。 信息从第 1 个词传到第 $n$ 个词要走几步?
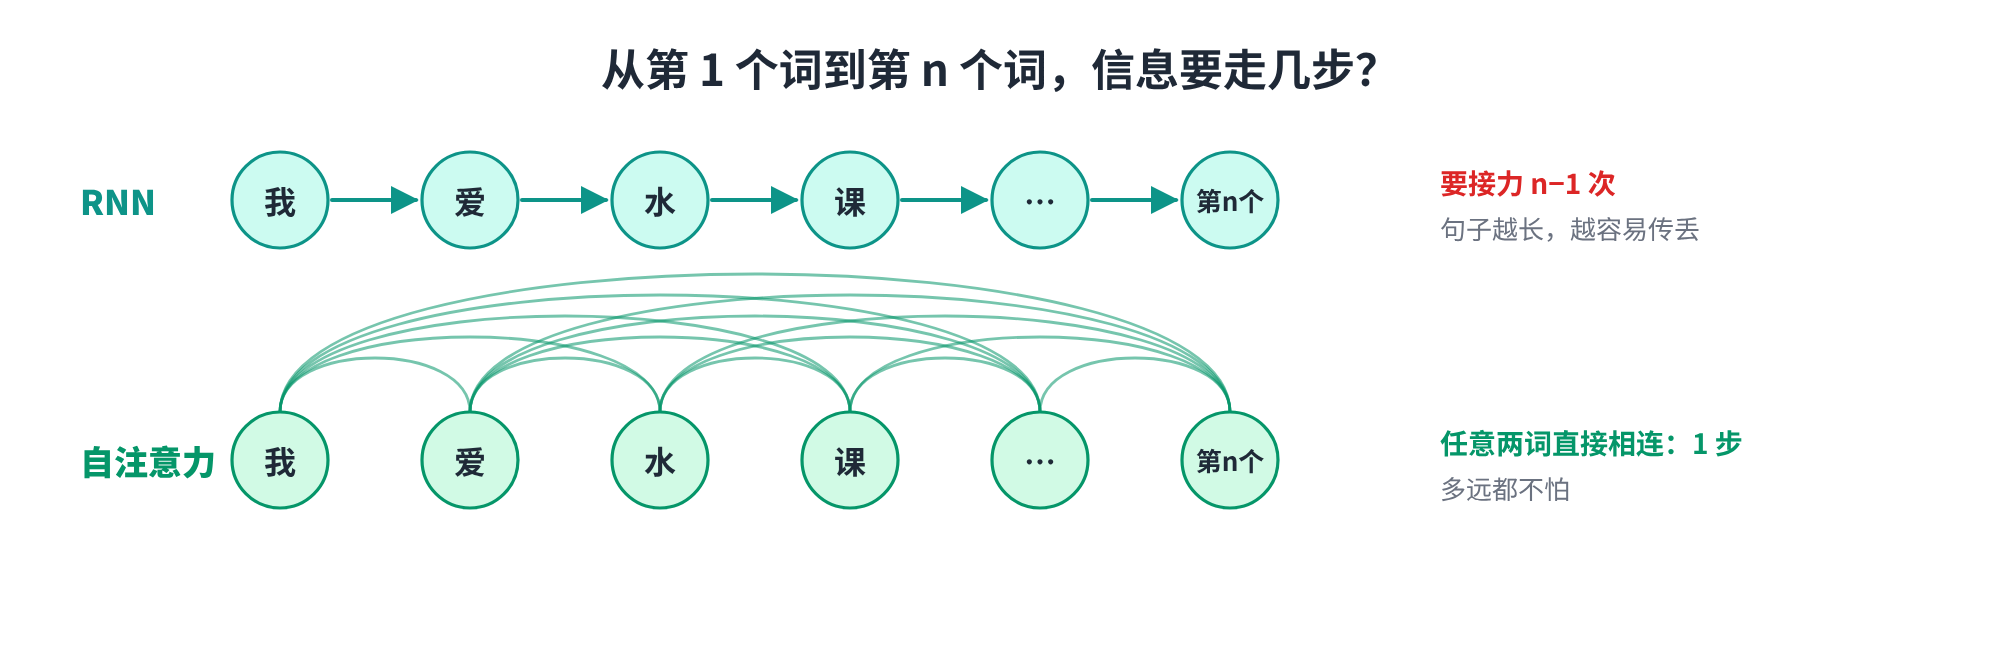
RNN 要接力 $n-1$ 次,每次都有损耗;CNN 要叠 $\log_k n$ 层;自注意力则是一步直达,任意两个词直接相连。路径越短,远距离的依赖关系就越容易学到。
除了这三点,论文还提到一个“额外好处”:自注意力更容易解释。可以直接把注意力权重画出来,看每个词关注了哪些词。作者发现,不同的头确实学会了各司其职,有的和句法结构相关,有的和语义相关。
最后看看实验结果。在 WMT 2014 英译德任务上,Transformer(大模型)拿到了 28.4 的 BLEU 分数,比当时最好的结果(包括多个模型的集成)高出 2 分以上;在英译法任务上,以 41.8 刷新了单模型的最好成绩,而训练只用了 8 块 GPU、3.5 天,是此前最好模型训练成本的一小部分。基础版模型更是只训练了约 12 小时。效果更好,训练更快——这正是“能并行”带来的直接回报。
所以,为什么 2017 年之前没有大模型时代?因为 RNN 那条单行道,让模型没办法高效地吃下海量数据。Transformer 用自注意力同时解决了“记不住远处”和“没法并行”这两个难题,把序列建模变成了 GPU 最擅长的大规模矩阵运算。从此,“更多数据 + 更多算力 = 更强模型”这条路,才真正走得通。
一页回顾
如果只记住几句话,就记这些:
- 主线:Transformer 要解决的,是 RNN 串行计算带来的效率瓶颈,同时不能丢掉注意力机制在长距离依赖上的优势。它的答案是:扔掉 RNN,只用注意力。
- 核心思路:训练时答案就在手上,所以编码时让每个词同时“看”全句,解码时用掩码遮住后文,所有位置并行计算。
- 每个词要编码三样东西:词义(词嵌入)、位置(正弦余弦位置编码,直接相加)、上下文(自注意力)。
- 自注意力:每个词变出 Q、K、V 三个分身;用 Q 和所有 K 打分,除以 $\sqrt{d_k}$,过 softmax,再给所有 V 加权求和。除以 $\sqrt{d_k}$ 是为了防止点积太大让 softmax 饱和。
- 多头注意力:8 个头各在 64 维子空间里从不同角度看,拼接后用 $W^O$ 融合;计算量和单头一样。
- 配套组件:残差连接给信息留一条保底通道;层归一化稳定数值;逐位置前馈网络让每个词自己消化信息。
- 解码器的两个特别之处:带掩码的自注意力(防作弊,被遮位置填 $-\infty$);编码器-解码器注意力(Q 来自译文,K、V 来自原文)。
- 训练并行,推理仍逐词生成。
- 为什么是革命:串行步数 $O(1)$、任意两词路径长度 $O(1)$,让大规模训练成为可能。
后来的故事
Transformer 原本是为机器翻译设计的,但它的组件很快被拆开来用。只用编码器那一半,就有了 BERT 这类擅长“理解”的模型;只用解码器那一半(带掩码的自注意力 + 前馈网络,去掉交叉注意力),就有了 GPT 系列这类擅长“生成”的模型。今天的大语言模型,绝大多数都是后一种思路的放大版。读懂了这篇论文,也就拿到了理解它们的钥匙。
参考资料
- Vaswani, A., et al. (2017). Attention Is All You Need. NeurIPS 2017.
- 堂吉诃德拉曼查的英豪.《Attention Is All You Need》论文解读(视频). bilibili BV1xoJwzDESD.
- Sutskever, I., Vinyals, O., & Le, Q. V. (2014). Sequence to Sequence Learning with Neural Networks. NeurIPS 2014.
- Bahdanau, D., Cho, K., & Bengio, Y. (2014). Neural Machine Translation by Jointly Learning to Align and Translate. arXiv:1409.0473.
- Williams, R. J., & Zipser, D. (1989). A learning algorithm for continually running fully recurrent neural networks. Neural Computation, 1(2).